English
 Deutsch
 Polski
Tutorial: Sprawdzenie JSON-a, zanim trafi do tagu

Spis treści
Zawartość odrzucona przez parser jest uciążliwa i nieszkodliwa: coś psuje się natychmiast, w jednym miejscu, a naprawa trwa minutę. Zawartość, którą parser przyjmuje i czyta inaczej, niż zamierzono, nie jest ani jednym, ani drugim.
Oba rodzaje mają to samo źródło. JSON wygląda jak obiekt JavaScript, a jest formatem znacznie węższym – i różnice między nimi to dokładnie poniższa lista.
Dlaczego obiekt JavaScript nie jest JSON-em
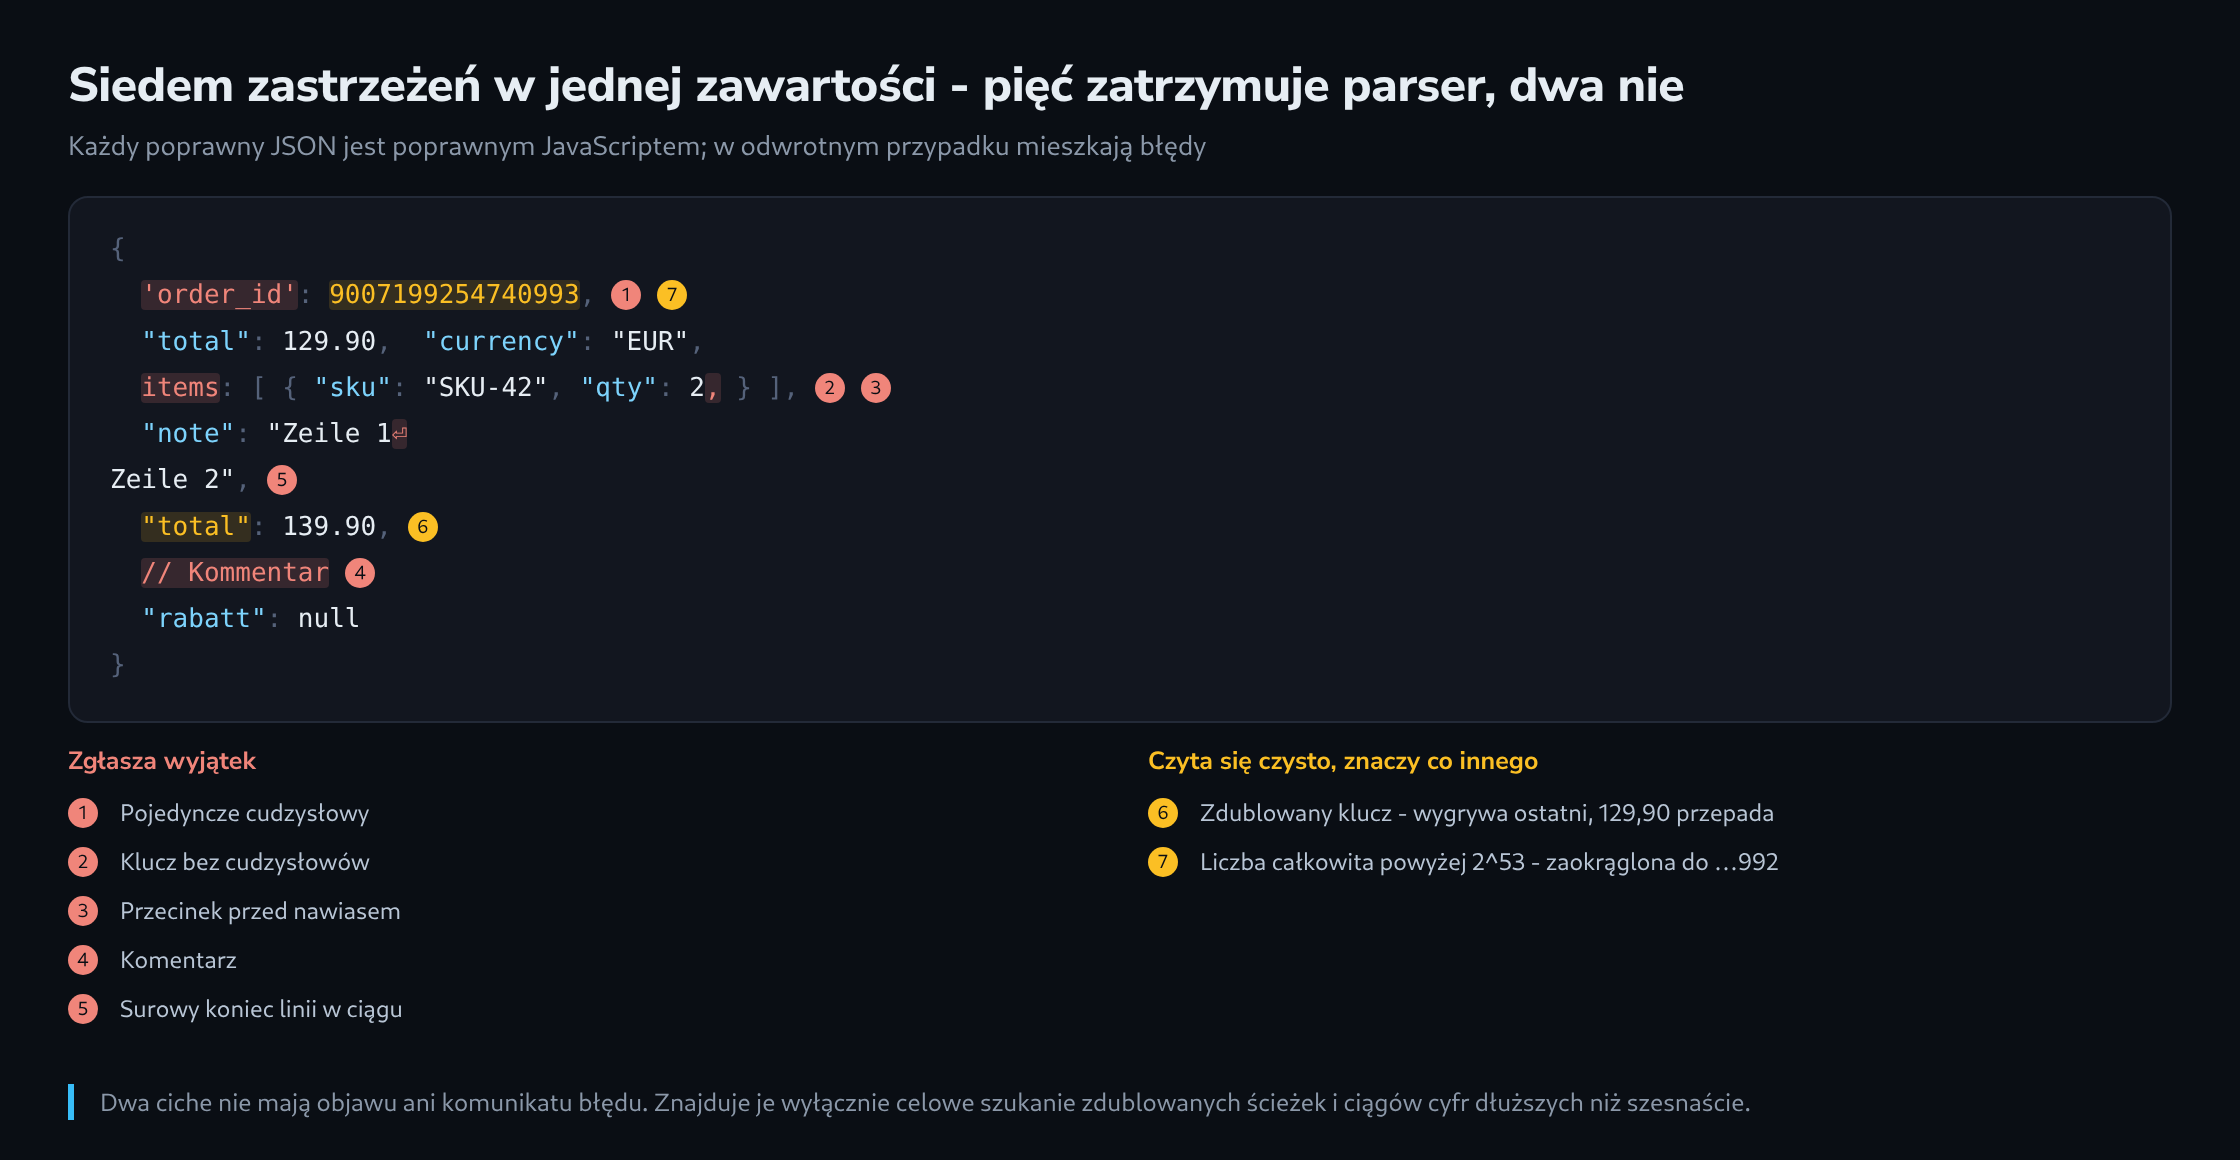
Wszystko poprawne w JSON-ie jest poprawnym JavaScriptem. Odwrotnie już nie, a w tym odstępie mieszkają błędy.
{                                     // JavaScript, nie JSON
  'order_id': 9007199254740993,       // pojedyncze cudzyslowy
  total: 129.90,                      // klucz bez cudzyslowow
  items: [ { sku: "SKU-42", qty: 2, } ],   // przecinek przed nawiasem
  rabatt: NaN,                        // nie jest wartoscia JSON
  /* komentarz */
}
JSON dopuszcza cudzysłowy podwójne i żadnych innych, wymaga cudzysłowów przy każdym kluczu, zabrania przecinka przed nawiasem zamykającym, nie zna komentarzy i zna dokładnie siedem rodzajów wartości: obiekt, listę, ciąg znaków, liczbę, true, false oraz null. Nie ma undefined, nie ma NaN, nie ma Infinity i nie ma daty.
Ostatni punkt należy wypowiedzieć wprost, bo wywołuje powracające zaskoczenie: data nie ma własnej reprezentacji. To, co dociera, jest ciągiem znaków albo liczbą, którą obie strony umówiły się czytać jako datę – a każda niezgoda co do formatu jest dla parsera niewidoczna.
Pięć błędów zgłaszających wyjątek
To te głośne, a każdy z nich daje ten sam mało pomocny komunikat o nieoczekiwanym tokenie.
| Błąd | Jak wygląda |
|---|---|
| Pojedyncze cudzysłowy | ’order_id’ zamiast „order_id” |
| Klucz bez cudzysłowów | total: 129.90 zamiast „total”: 129.90 |
| Przecinek przed nawiasem | Przecinek przed } albo ] |
| Komentarz | Wszystko po // albo między /* a */ |
| Surowy koniec linii w ciągu | Znak nowej linii w cudzysłowach; potrzebne jest \n |
Szósty należy do tej samej grupy i wcale nie jest widoczny: znacznik kolejności bajtów na początku pliku. To trzy niewidoczne bajty przed nawiasem otwierającym, a parser zgłasza nieoczekiwany token na pozycji 0 – co wygląda, jakby problemem był nawias. Plik wyglądający bezbłędnie i zawodzący na pozycji 0 taki znacznik ma, a edytor z ustawieniem zapisu bez znacznika go usuwa.
Dwa, które nic nie zgłaszają
Tych warto szukać celowo, bo nic innego na nie nie wskaże.
Pierwszym jest zdublowany klucz. Specyfikacja go dopuszcza, a zachowaniem zwyczajowym jest, że wygrywa ostatni – dokument z dwoma "total" czyta się więc czysto i niesie wartość drugą. Gdy oba leżą w długiej zawartości daleko od siebie, powstaje liczba ani niewyglądająca błędnie, ani niebędąca poprawną.
{ "total": 129.90, "currency": "EUR", "total": 139.90 }

JSON.parse(...).total   →   139.90
Drugim jest duża liczba całkowita. Liczby w JavaScripcie są zmiennoprzecinkowe, a całkowite pozostają dokładne tylko do 2^53 − 1. Numer zamówienia, identyfikator z bazy danych, identyfikator Meta CAPI – wszystkie regularnie to przekraczają, a parser zaokrągla je bez słowa.
JSON.parse('{"id": 9007199254740993}').id   →   9007199254740992

JSON.parse('{"id": "9007199254740993"}').id →   "9007199254740993"
Wynikająca zasada jest krótka: identyfikator jest ciągiem znaków, zawsze, także gdy składa się z samych cyfr. Nikt na nim i tak nie liczy, a ciąg znaków przechodzi przez każdy parser bez zmian.
Odczyt zgłaszanej pozycji
Pozycja w komunikacie błędu to przesunięcie znakowe w całym dokumencie, a w zawartości zminifikowanej jest to liczba bez znaczenia.
Pierwszym krokiem jest więc zawsze sformatowanie dokumentu, a nie szukanie błędu. Sformatowana zawartość układa pozycję na linii, a linia powyżej wskazanej jest zwykle właściwym miejscem usterki – brakujący przecinek rzuca się w oczy przy następnym tokenie, a nie tam, gdzie go brakuje.
try {
  JSON.parse(text);
} catch (e) {
  const stelle = Number((e.message.match(/position (\d+)/) || [])[1]);
  if (!Number.isNaN(stelle)) {
    console.log(text.slice(Math.max(0, stelle - 60), stelle + 60));
    console.log(" ".repeat(Math.min(60, stelle)) + "^");
  }
}
Sześćdziesiąt znaków po każdej stronie wystarcza niemal zawsze, aby zobaczyć problem, a daszek zdejmuje konieczność liczenia. Warto zachować to jako gotowy fragment, bo alternatywą jest otwarcie formatera, wklejenie, przewijanie i utrata pozycji.
Sprawdzenie w wierszu poleceń
Gdy zawartość pochodzi z pliku albo z żądania, na pytanie odpowiada jedno polecenie.
# poprawny? sformatowane wyjscie albo blad z numerem linii
jq . nutzlast.json

# sama odpowiedz, bez tresci
jq -e . nutzlast.json >/dev/null && echo "poprawny" || echo "niepoprawny"

# znalezc zdublowane klucze - --stream zglasza kazda pare, takze powtorzona
jq -c --stream 'select(length == 2) | .[0]' nutzlast.json | sort | uniq -d

# duze liczby, ktore straca dokladnosc
grep -oE '"[a-z_]+": *[0-9]{16,}' nutzlast.json
Trzecie polecenie opłaca się na każdej nigdy niesprawdzanej zawartości. Wypisuje ścieżki występujące więcej niż raz, a to maszynowa droga do przypadku cichego – przy zawartości generowanej znajduje coś zaskakująco często, bo szablon dopisujący pole w dwóch gałęziach wytwarza dokładnie to.
Gdzie liczy się to najbardziej
Trzy miejsca zamieniają drobny błąd JSON w coś trudnego do zauważenia później.
Blok JSON-LD na stronie jest pierwszym. Błąd składni oznacza, że wyszukiwarki nie odczytują żadnych danych strukturalnych, a strona nadal działa bez zarzutu – nic w witrynie nie wskazuje więc na problem, a strata pojawia się tygodnie później jako brak wyników rozszerzonych. Kontrolą, która to wyłapuje, jest walidator na stronie wysłanej, a nie na szablonie.
Zawartość Conversions API jest drugim. Platforma odbierająca odpowiada błędem, ale ten błąd stoi w odpowiedzi serwer-serwer, której nikt nie obserwuje, a nieudane zdarzenie po prostu się nie pojawia. To tutaj zdublowany klucz czyni największą szkodę: zawartość z wartością zdarzenia dwa razy wysyła tę błędną, a i nadawca, i odbiorca uważają żądanie za udane.
Konfiguracja szablonu menedżera tagów jest trzecim. Jej JSON czytany jest raz przy wczytaniu szablonu, a błędne pole potrafi zostawić szablon zainstalowany, lecz bezczynny. Ten przypadek różni się tym, że zawodzi przy imporcie, a nie w trakcie działania – to lepsze miejsce na porażkę, i tylko wtedy, gdy ktoś przeczyta komunikat.
Wszystkim trzem wspólne jest jedno: sprawdza się tam, gdzie zawartość powstaje, a nie tam, gdzie zostaje zużyta. Krok budowania przepuszczający parser przez każdy wytworzony plik nic nie kosztuje i wyłapuje wszystkie pięć głośnych błędów, zanim opuszczą maszynę.
Pytania i odpowiedzi
Czy przy zdublowanym kluczu w każdym parserze wygrywa ostatnia wartość?
Nie, i właśnie w tym tkwi większe niebezpieczeństwo. Specyfikacja JSON, RFC 8259, mówi jedynie, że nazwy w obiekcie powinny być unikalne, i wyraźnie odnotowuje, że odbiorcy zachowują się przy zdublowanych nazwach różnie: wiele implementacji zachowuje ostatnią wartość, inne zgłaszają błąd, a jeszcze inne przekazują dalej wszystkie pary. JSON.parse, moduł json w Pythonie i jq zachowują ostatnią.
Kłopot pojawia się, gdy tylko dwa miejsca czytają tę samą zawartość różnymi parserami. Jeśli walidator sprawdza pierwszą wartość, a odbiorca przetwarza ostatnią, sprawdzenie widziało inną wartość niż odbiorca, a obie strony zgłaszają sukces.
We własnym kodzie da się ten przypadek twardo odrzucić. W Pythonie wystarczy object_pairs_hook, który liczy klucze każdego obiektu i przy zdublowaniu zgłasza wyjątek; cichy przypadek staje się wtedy równie głośny jak pięć błędów z tabeli.
Czy jq . pokazuje dużą liczbę dokładnie tak, jak stoi w pliku?
To zależy od wersji. Do jq 1.6 każda liczba jest wczytywana jako zmiennoprzecinkowa, a sformatowane wyjście pokazuje 9007199254740993 jako 9007199254740992, tak samo jak JSON.parse, więc zapisana kopia tego wyjścia traci cyfrę; dopiero od jq 1.7 liczba z pliku pozostaje niezmieniona, dopóki nie wykonuje się na niej obliczeń. Niezawodne jest więc polecenie grep z artykułu, bo czyta tekst pliku, a nie sparsowaną wartość.
Powiązane artykuły