English
 Deutsch
 Polski
Microsoft Advertising Conversions API: Praxisleitfaden für server-seitiges UET

Inhalt
- 1. Anfrageformat und Zugangsdaten
- 2. Eine echte Dokumentationsabweichung mit begrenzter Aussagekraft
- 3. Deduplizierung benötigt mehr als eine Bestellnummer
- 4. Feldbezogene Normalisierung und Einwilligung
- 5. Sieben Tage, Zukunftszeiten und die letzte Stunde
- 6. HTTP-Erfolg und Ereigniserfolg unterscheiden sich
- 7. Monitoring und Datenabgleich
- Fragen und Antworten
- Quellen
Die Microsoft Advertising Conversions API (CAPI) stellt einen serverseitigen Übertragungsweg für Ereignisse aus Checkout, CRM und weiteren Systemen bereit. Dadurch lassen sich Lücken durch ausgebliebene Browseranfragen verringern. Ein angenommenes Ereignis ist jedoch nicht automatisch eine zugeordnete Conversion: Einwilligung, Kennungen, Conversion-Ziele und Attributionsregeln bleiben maßgeblich.
Zur Umsetzung gehören Ereigniszuordnung, Zugangsdaten, zulässige Kennungen, Duplikatbehandlung und eine überwachte Versandwarteschlange. Ein pauschaler Aufwand von ein bis zwei Wochen würde Unterschiede zwischen vorhandenen Datensystemen verdecken. Das Mai-Release 2026 ergänzte GetUetTagAuthKey und den Click-ID-Bericht; ein geändertes Dokumentationsdatum allein belegt keine Änderung des Backend-Verhaltens.
1. Anfrageformat und Zugangsdaten
Ereignisse werden als JSON an https://capi.uet.microsoft.com/v1/{tagId}/events gesendet, mit dem CAPI-Schlüssel des Tags in Authorization: Bearer …. Das Array data enthält höchstens 1.000 Ereignisse. eventType lautet custom oder pageLoad; eventTime enthält die UTC-Unixzeit in Sekunden innerhalb der vergangenen sieben Tage. userData benötigt mindestens eine unterstützte Kennung. Seitenaufrufe benötigen zusätzlich eventSourceUrl. Benutzerdefinierte Conversion-Ziele müssen zu den konfigurierten Ereigniseigenschaften passen.
Der getrennte Campaign-Management-Aufruf verwendet OAuth sowie die erforderlichen Entwickler- und Kontoheader. Diese Zugangsdaten sind nicht mit dem CAPI-Schlüssel austauschbar. GetUetTagAuthKey ruft einen vorhandenen Schlüssel ab; die erstmalige Erzeugung setzt den Besitz des Tags voraus. Ein erneuter Abruf rotiert den Schlüssel nicht. Neuerzeugung oder Widerruf müssen dem unterstützten Kontoverfahren folgen.
2. Eine echte Dokumentationsabweichung mit begrenzter Aussagekraft
Zum Prüfdatum 24. Oktober 2026 zeigt der Integrationsleitfaden TagId und die verschachtelte Antwort TagAuthKey.AuthKey. Die Operationsreferenz nennt UetTagId und den flachen Wert UetTagAuthKey. Das ist eine Abweichung zwischen Dokumenten, kein Beleg für unterschiedliche API-Verträge pro Konto. Anfragen sollten dem gewählten SDK beziehungsweise Operationsvertrag folgen und in einer autorisierten Integrationsumgebung geprüft werden.
Der Adapter akzeptiert Dictionaries und Objektantworten in beiden beschriebenen Formen, weist gemeldete Teilfehler und widersprüchliche Schlüssel zurück und protokolliert kein Geheimnis. Der Zugriff als Dictionary erfolgt erst nach Prüfung des Antworttyps.
from collections.abc import Mapping

def field(value, name):
    return value.get(name) if isinstance(value, Mapping) else getattr(value, name, None)

def extract_auth_key(response):
    if field(response, "PartialErrors"):
        raise ValueError("Auth response contains errors; inspect redacted diagnostics")
    values = [field(response, "UetTagAuthKey"),
              field(field(response, "TagAuthKey"), "AuthKey")]
    keys = {v for v in values if isinstance(v, str) and v.strip()}
    if len(keys) != 1:
        raise ValueError("Missing or conflicting auth-key fields")
    key = keys.pop()
    if any(c.isspace() or ord(c) < 32 or ord(c) == 127 for c in key):
        raise ValueError("Invalid auth-key whitespace/control character")
    return key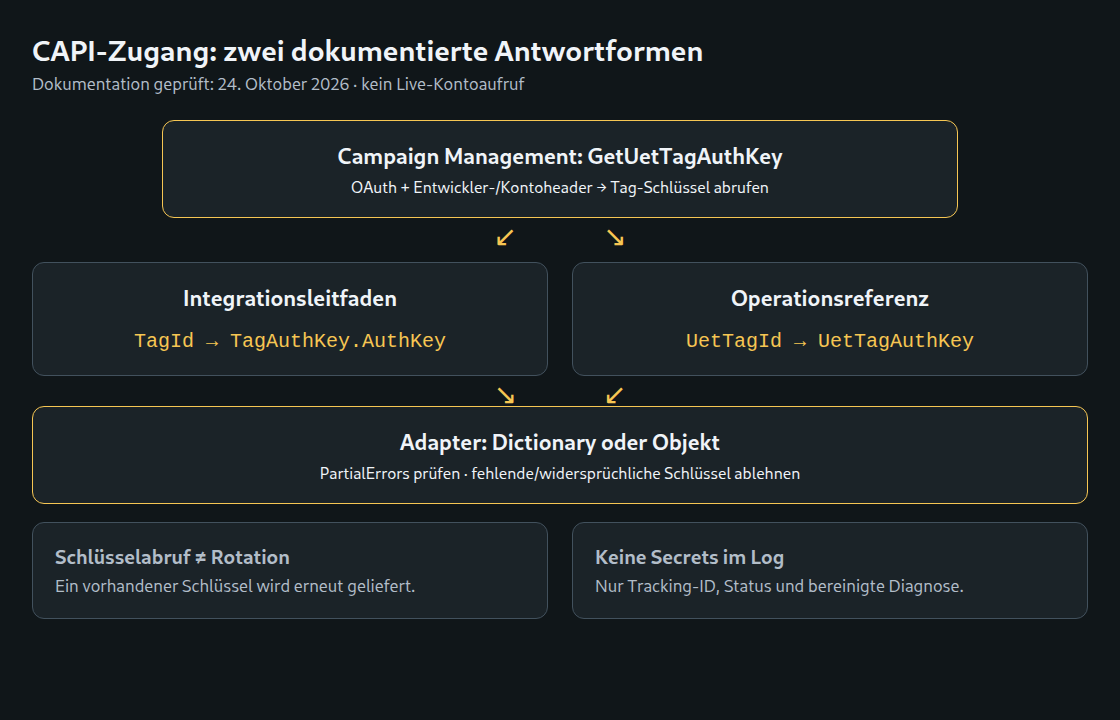
Schema-Toleranz repariert weder falsche Zugangsdaten noch eine ungültige Anfrage. Diagnoseprotokolle sollten Anfrage-/Tracking-IDs, Status und eine bereinigte Fehlerklassifikation enthalten. Rohe Auth-Antworten, Bearer-Header und Kundendaten gehören nicht in gewöhnliche Logs. Das Laden eines neu freigegebenen Secrets zwischen Batches erleichtert den Wechsel; unterbrechungsfreie Rotation und vernachlässigbare Zugriffslatenz sind dadurch nicht garantiert.
3. Deduplizierung benötigt mehr als eine Bestellnummer
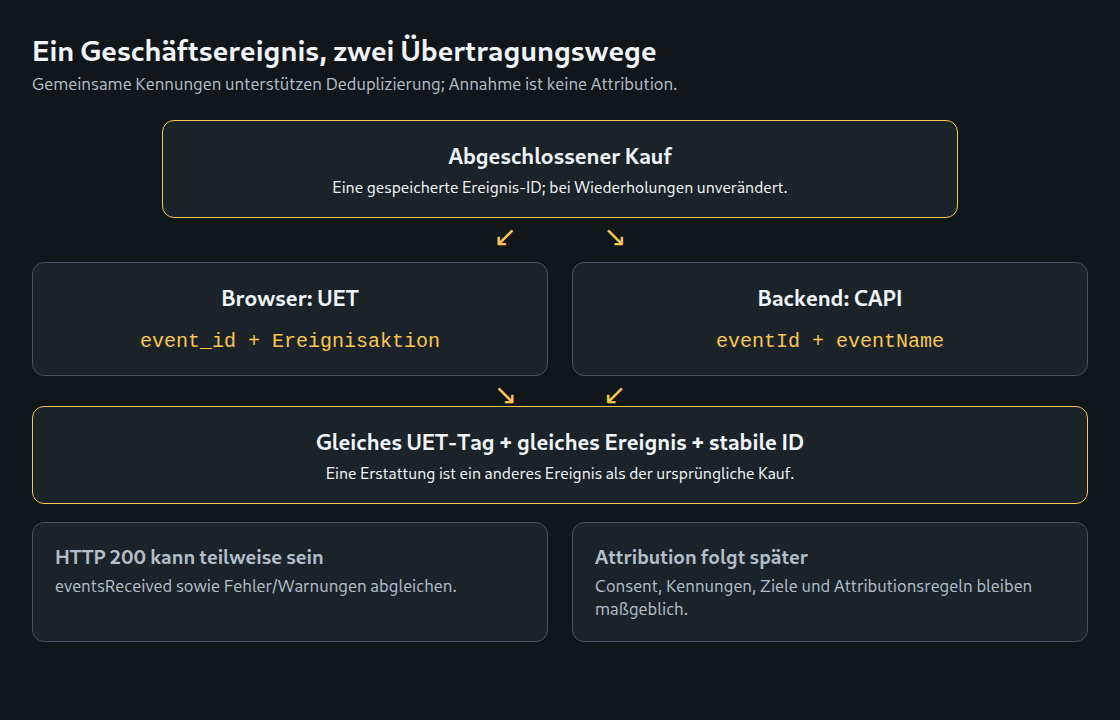
Browser- und Serverkopie desselben Ereignisses benötigen dasselbe UET-Tag, einen passenden Ereignisnamen und eine stabile Ereignis-ID. UET-JavaScript verwendet event_id, CAPI dagegen eventId. Die Kennung sollte das Geschäftsereignis identifizieren, etwa den abgeschlossenen Kauf, und bei Wiederholungen unverändert bleiben. Kauf und Erstattung sind verschiedene Ereignisse, auch bei derselben Bestellung.
Eine gespeicherte zufällige Ereignis-ID oder eine bewusst mit Ereignistyp und Namensraum versehene Bestellkennung kann diese Stabilität liefern. Der zweite Transportweg darf keine neue Zufalls-ID erzeugen. Rein serverseitige CRM-Ereignisse haben kein Browsergegenstück, benötigen aber weiterhin zuverlässige Wiederholungsverwaltung. Stabile Kennungen unterstützen die Duplikatvermeidung; eine absturzsichere Genau-einmal-Garantie folgt aus einem einzelnen Feld nicht.
4. Feldbezogene Normalisierung und Einwilligung
Die aktuellen Microsoft-Vorgaben für E-Mail-Adressen umfassen das Entfernen äußerer Leerzeichen, von Punkten und Plus-Alias im lokalen Teil, Kleinschreibung und SHA-256. Diese Regel gilt für Microsofts Zuordnung, nicht allgemein für gespeicherte Kontaktadressen oder andere Plattformen. Telefonnummern werden in kanonischem E.164-Format einschließlich führendem Plus gehasht. Der Helfer erwartet eine bereits international normalisierte Nummer; länderspezifische Verarbeitung und Prüfung der tatsächlichen Nummer gehören davor.
import hashlib
import re

def microsoft_email_hash(value):
    if not isinstance(value, str):
        return None
    value = value.strip()
    if value.count("@") != 1 or any(c.isspace() or ord(c) < 32 for c in value):
        return None
    local, domain = value.split("@")
    local = local.split("+", 1)[0].replace(".", "")
    if not local or not domain or "." not in domain:
        return None
    return hashlib.sha256((local + "@" + domain).lower().encode("utf-8")).hexdigest()

def microsoft_phone_hash(e164):
    if not isinstance(e164, str) or not re.fullmatch(r"\+[1-9][0-9]{6,14}", e164):
        return None
    return hashlib.sha256(e164.encode("utf-8")).hexdigest()
Diese Helfer sind bewusst begrenzte Beispiele, keine vollständigen E-Mail- oder Telefonnummernprüfer. Ungültige oder fehlende Kennungen sollten entfallen, statt durch Hashes von Platzhaltern ersetzt zu werden. IP-Adresse, User-Agent und Click-ID folgen eigenen Feldregeln; die pauschale Anweisung, jede Kennung zu hashen, ist falsch. Hashing macht identifizierende Daten außerdem nicht anonym.
adStorageConsent erlaubt G und D. Ohne Angabe gilt laut Dokumentation standardmäßig eine erteilte Einwilligung. Eine ausdrücklich gesetzte Zustandsangabe ist deshalb wichtig: Ereignisse mit verweigertem Consent werden nicht für Werbezwecke einschließlich Attribution und Remarketing verwendet. Das Feld erteilt keine Erlaubnis zur sonst unzulässigen Übermittlung personenbezogener Daten.
Die Anwendung muss eine zulässige Erfassungs- und Übermittlungsgrundlage sicherstellen, relevante Einwilligungsnachweise speichern und vor dem Versand geltende Widerrufs- oder Sperrregeln erneut prüfen. Eine frühere Zustimmung rechtfertigt nicht das Ignorieren eines späteren Widerrufs. Ein Telefonverkauf kann einen getrennten Einwilligungsnachweis besitzen; ein fehlendes Webbanner belegt allein weder Erlaubnis noch Verbot. Ein unbekannter Zustand darf nicht stillschweigend als erteilt gelten.
5. Sieben Tage, Zukunftszeiten und die letzte Stunde
Eine Altersprüfung muss zukünftige Zeitstempel zurückweisen, ohne gültige Datensätze allein wegen einer nahenden Frist zu verwerfen. Die Funktion unterscheidet ungültige, zukünftige, abgelaufene und dringliche Zeitstempel. Ein dringliches Ereignis bleibt für einen sofortigen Versuch vorgesehen; die Warnschwelle ist keine vorgezogene API-Ablauffrist. Unmittelbar vor dem Versand ist die Eignung erneut zu prüfen.
from datetime import datetime, timedelta, timezone

def event_age_state(event_time, now):
    if not isinstance(event_time, datetime) or not isinstance(now, datetime):
        return "invalid"
    if event_time.tzinfo is None or event_time.utcoffset() is None or now.tzinfo is None or now.utcoffset() is None:
        return "invalid"
    age = now.astimezone(timezone.utc) - event_time.astimezone(timezone.utc)
    if age < timedelta(0):
        return "future"
    if age >= timedelta(days=7):
        return "expired"
    if age >= timedelta(days=7, hours=-1):
        return "urgent"
    return "ready"
Die Grenze von genau sieben Tagen wird vorsichtig als abgelaufen behandelt. Der Helfer liefert nur Zustände und versendet oder löscht keine Datensätze. Eine dauerhafte Warteschlange benötigt eindeutige Ergebnisse, begrenzte Wiederholungen und Zuständigkeit für laufende Aufträge. Nach einem Worker-Absturz kann die Zustellung unklar sein; eine Statusspalte allein beweist deshalb keine folgenlose Wiederaufnahme. Alte Ereignisse dürfen zur Umgehung des Fensters keinen aktuellen Zeitstempel erhalten.
6. HTTP-Erfolg und Ereigniserfolg unterscheiden sich
Der Leitfaden dokumentiert inzwischen ausdrücklich HTTP 400 für Validierungsfehler und 401 für Autorisierungsfehler. Eine 401 erfordert die Korrektur von Zugangsdaten und Tag-Zuordnung; ein unverändert ungültiges Payload sollte nach 400 nicht endlos wiederholt werden. Vorübergehende Transport- oder Dienstfehler können begrenzte Wiederholungen mit exponentiell wachsender Wartezeit und Zufallsanteil erhalten. Eine tatsächlich gelieferte Retry-After-Anweisung ist zu berücksichtigen; ein undokumentiertes zahlenmäßiges Anfragelimit wird nicht angenommen.
Standardmäßig verhindert ein Validierungsfehler die Verarbeitung des gesamten Batches. Mit continueOnValidationError: true können gültige Ereignisse verarbeitet und ungültige übersprungen werden. HTTP 200 kann daher Fehler oder Warnungen enthalten; eine Warnung kann das Entfernen eines optionalen Feldes bedeuten. eventsReceived und Diagnosedetails müssen vor der Annahmemarkierung abgeglichen werden. Die Dokumentation begrenzt die ausgegebenen Fehler-/Warnungsdetails auf die ersten zehn Einträge. Das Fehlen eines Datensatzes in der sichtbaren Fehlerliste beweist deshalb nicht immer dessen Annahme.
Eine einfachere Anfangsstrategie lässt Teilverarbeitung deaktiviert, validiert lokal und trennt fehlerhafte Datensätze zur Korrektur ab. Das Monitoring sollte API-Annahme, verworfene Ereignisse, entfernte Felder und später zugeordnete Conversions unterscheiden. Protokolle speichern sichere Kennungen und Fehlerklassen statt ungefilterter Antwortinhalte.
7. Monitoring und Datenabgleich
Nützlich sind das Alter des ältesten offenen Ereignisses, dringliche und abgelaufene Datensätze, Versandlatenz-Perzentile, angenommene Ereignisse, Validierungsfehler, Consent und Abdeckung durch sämtliche unterstützten Kennungen. „Kein E-Mail-Hash“ bedeutet nicht „keine Kennung“; ein Ereignis kann msclkid oder ein anderes akzeptiertes Feld enthalten. Abgelaufene Datensätze können aus alter Datenübernahme oder falschen Zeitstempeln entstehen und beweisen keinen sechstägigen Ausfall.
Sprünge bei Consent oder Kennungsabdeckung begründen eine Untersuchung, beweisen jedoch keinen bestimmten Formular- oder Consent-Tool-Fehler. Traffic-Zusammensetzung, Akquisekanäle und tatsächliche Geschäftsänderungen können dieselben Kennzahlen verändern. Die von Microsoft ausgewiesenen Conversions müssen nicht allen angenommenen Bestellungen entsprechen: Zuordnung, Ziele, Zeitfenster, Zählregeln, Berichtsdatum und Verarbeitungszeit beeinflussen den Vergleich.
Fragen und Antworten
Beweisen aggregierte Summen die Deduplizierung?
Nein. Zeitlich abgestimmte Summen können auffällige Veränderungen zeigen; zur Eingrenzung der Duplikatbehandlung sind jedoch Ereignis-Testfälle und Versandnachweise erforderlich. Ein niedrigerer Plattformwert beweist allein keine verlorenen API-Ereignisse.
Ist der Click-ID-Bericht erforderlich?
Nein. MSClickIdPerformanceReport kann bei Verfügbarkeit die Analyse auf Klickebene unterstützen. Die Spaltenreferenz enthält funktionsbezogene Verfügbarkeitshinweise; zwei Hinweise auf derselben Seite beweisen keinen Pilotstatus des gesamten Berichts. ConversionsQualified ist als Double dokumentiert. Kontoverfügbarkeit und Berichtssemantik sind vor einer betrieblichen Abhängigkeit zu prüfen.
Was ändert sich beim Remarketing?
Der aktuelle Leitfaden verlangt clientseitigen ID Sync für Remarketing/Zielgruppen und empfiehlt den Abgleich für die Qualität der Conversion-Messung. Ein rein serverseitiger Ereignisstrom ersetzt diesen Browserschritt nicht automatisch. Auch der Abgleich unterliegt den geltenden Einwilligungsregeln; die Besucher-ID muss mit anonymousId im Serverereignis übereinstimmen.
Passend dazu