English
 Deutsch
 Polski
Extrahieren spezifischer Tabellen aus riesigen SQL-Dumps mit PHP

Inhalt
Aus einem großen MySQL-Dump wird manchmal nur eine bestimmte Tabelle benötigt. Dafür muss die gesamte Datei nicht in einen Editor oder in den PHP-Arbeitsspeicher geladen werden. Entscheidend ist jedoch, welche Art von Ergebnis benötigt wird: ein Textauszug zur Untersuchung oder eine tatsächlich wiederherstellbare Datenbanksicherung.
Ein zeilenbasierter Filter ist kein SQL-Parser. Das folgende PHP-Beispiel kopiert ausgewählte, durch Standardkommentare abgegrenzte Tabellenabschnitte. Das Ergebnis bleibt ein Textauszug zur Prüfung. Für eine Wiederherstellung ist ein gezielter neuer Export oder ein geprüfter Wiederherstellungsablauf vorzuziehen.
Warum ein einfacher Ein-/Ausschalter nicht genügt
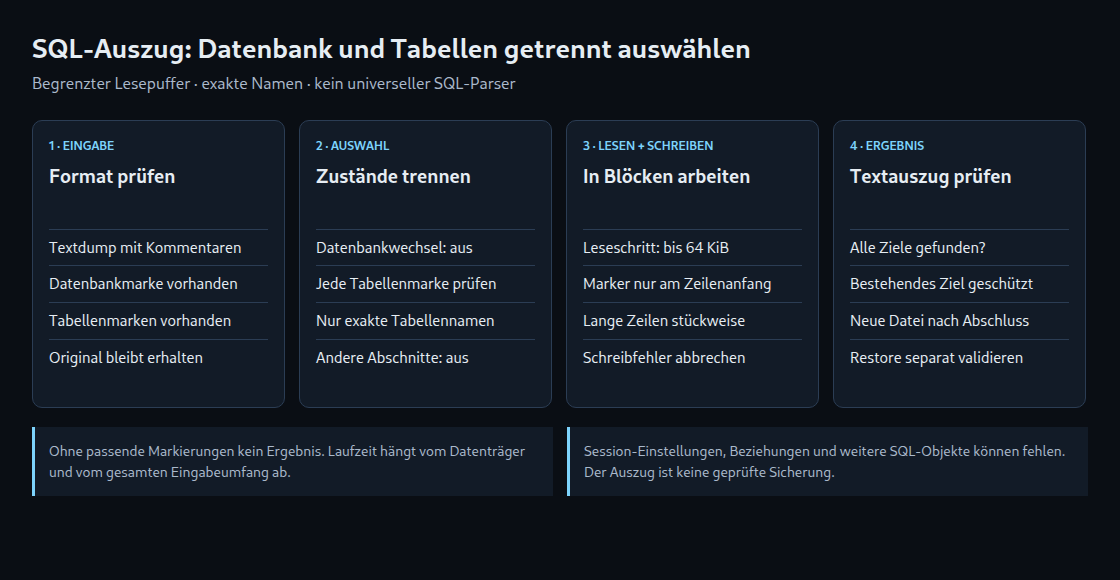
Datenbank und Tabelle sind zwei getrennte Zustände. Beim Wechsel der Datenbank muss eine laufende Auswahl enden. Bei jeder neuen Tabellenmarkierung muss erneut entschieden werden, ob die Tabelle ausgewählt ist. Eine Prüfung der nächsten Tabellenmarke ausschließlich bei ausgeschaltetem Kopierschalter würde nach dem ersten Treffer weitere Tabellen mitschneiden.
Auch fgets() allein garantiert keinen winzigen Speicherverbrauch: Ohne Längenbegrenzung wird eine vollständige Zeile gelesen. Ein erweitertes INSERT kann sehr lang sein. Das Beispiel liest deshalb höchstens 65.536 Bytes pro Schritt und untersucht Markierungen ausschließlich am Zeilenanfang. Lange Datenzeilen werden stückweise kopiert.
Welche Dump-Formate das Beispiel voraussetzt
- Unkomprimierte Textdatei im üblichen
mysqldump-Kommentarformat mit Datenbankmarkierungen, etwa aus einem Export mit--databasesoder--all-databases. - Abschnittsmarkierungen
-- Current Database:,-- Table structure for tableund/oder-- Dumping data for tablesind vorhanden. Ein Dump mit--skip-commentswird dafür nicht unterstützt. - Exakte Datenbank- und Tabellennamen statt einer unklaren gemeinsamen Präfixsuche. Namen mit eingebetteten Backticks und abweichende Generatorformate sind nicht abgedeckt.
- PHP 8 auf der Kommandozeile und ein lokales Dateisystem, das Hardlinks zwischen Dateien desselben Verzeichnisses unterstützt. Eingabe, Teil- und Ausgabedatei liegen außerhalb eines öffentlich erreichbaren Webverzeichnisses.
Komprimierte Dumps müssen vorher in eine ausreichend große, geschützte Arbeitsumgebung entpackt werden. Eine Sichtung des Dateianfangs hilft bei der Einordnung, beweist aber weder den vollständigen Inhalt noch sämtliche späteren Tabellen oder Zeilenlängen.
PHP-Beispiel: genau benannte Tabellenabschnitte
Der Aufruf php extract.php dump.sql excerpt.txt shop orders customers wählt die Tabellen orders und customers aus der Datenbank shop. Die Ausgabedatei und die zugehörige .part-Datei dürfen noch nicht existieren.
<?php
// PHP 8 CLI. Produces a text excerpt, not a validated restore file.
umask(0077);
if ($argc < 5) {
    fwrite(STDERR, "Usage: php extract.php input.sql excerpt.txt database table [table...]\n");
    exit(2);
}
[, $input, $output, $database] = $argv;
$tables = array_fill_keys(array_slice($argv, 4), true);
$part = $output . '.part';
$in = $out = false;
$created = false;

try {
    $in = @fopen($input, 'rb');
    if ($in === false) throw new RuntimeException('Cannot open input');
    $out = @fopen($part, 'xb');
    if ($out === false) throw new RuntimeException('Cannot create new partial output');
    $created = true;
    $currentDatabase = null;
    $copy = false;
    $lineStart = true;
    $seen = [];

    while (($chunk = fgets($in, 65537)) !== false) {
        if ($lineStart) {
            if (preg_match('/^-- Current Database: `([^`]+)`\r?\n?$/D', $chunk, $m)) {
                $currentDatabase = $m[1];
                $copy = false;
            } elseif (preg_match('/^-- (?:Table structure|Dumping data) for table `([^`]+)`\r?\n?$/D', $chunk, $m)) {
                $copy = $currentDatabase === $database && isset($tables[$m[1]]);
                if ($copy) $seen[$m[1]] = true;
            } elseif (str_starts_with($chunk, '-- ')) {
                $copy = false;
            }
        }
        if ($copy) {
            $offset = 0;
            $length = strlen($chunk);
            while ($offset < $length) {
                $n = fwrite($out, substr($chunk, $offset));
                if ($n === false || $n === 0) throw new RuntimeException('Write failed');
                $offset += $n;
            }
        }
        $lineStart = str_ends_with($chunk, "\n");
    }
    if (!feof($in)) throw new RuntimeException('Read failed');
    if (array_diff_key($tables, $seen)) {
        throw new RuntimeException('Requested table marker missing; format or names differ');
    }
    if (!fflush($out)) throw new RuntimeException('Flush failed');
    if (!fclose($out)) throw new RuntimeException('Close failed');
    $out = false;
    // Same-directory hard link: fails if the final name already exists.
    if (!@link($part, $output)) throw new RuntimeException('Cannot publish new output');
    if (!unlink($part)) throw new RuntimeException('Output exists, partial link cleanup failed');
    $created = false;
    fwrite(STDERR, "Text excerpt written. Separate restore validation required.\n");
} catch (Throwable $e) {
    if (is_resource($out)) fclose($out);
    if ($created && is_file($part)) unlink($part);
    fwrite(STDERR, $e->getMessage() . "\n");
    exit(1);
} finally {
    if (is_resource($in)) fclose($in);
}
Die neue Ausgabedatei erscheint erst nach dem vollständigen Leselauf, erfolgreichen Schreibprüfungen und mindestens einer passenden Markierung je angeforderter Tabelle. Ein Treffer belegt dabei nur die Abschnittsauswahl, nicht die Vollständigkeit der SQL-Objekte. Ein bestehendes Ergebnis wird nicht überschrieben. Bei einem Fehler erfolgt ein Abbruch mit einem von null verschiedenen Exitcode; ein Teil-Auszug wird nicht als fertiges Ergebnis gemeldet.
Vom Textauszug zur Wiederherstellung
Session-Einstellungen wie Zeichensatz und SQL-Modus, Fremdschlüsselbezüge, Trigger, Views und Routinen können außerhalb des kopierten Abschnitts liegen. Kommentare können außerdem in ungewöhnlich formatierten SQL-Zeichenketten vorkommen. Das Beispiel interpretiert solche SQL-Strukturen nicht und darf deshalb nicht als universeller Importfilter eingesetzt werden.
Bei verfügbarem Originalserver kann mysqldump eine Datenbank und danach ausdrücklich benannte Tabellen direkt exportieren. Für InnoDB kann --single-transaction zur konsistenten Sicherung dienen; andere Speicher-Engines und gleichzeitige Strukturänderungen benötigen eine passende Strategie. Ist nur der vorhandene Dump verfügbar, ermöglicht eine isolierte Wiederherstellung mit anschließender Objektauswahl einen kontrollierteren Weg. Zielversion, Speicherplatz, Abhängigkeiten und Zugriffsrechte gehören vor dem Import geprüft.
Fragen und Antworten
Wie schnell arbeitet der Filter?
Die gesamte Eingabedatei wird gelesen. Laufzeit und Speicherbedarf hängen unter anderem von Datenträger, Ausgabeumfang und PHP ab. Eine allgemeine Zusage „mehrere Gigabyte in wenigen Sekunden“ ist nicht belastbar. Der begrenzte Lesepuffer verhindert lediglich, dass eine einzelne sehr lange Zeile vollständig im PHP-Speicher liegen muss.
Was bedeutet ein fehlender Treffer?
Ein Name kann fehlen, anders geschrieben sein oder ohne die erwarteten Kommentare vorliegen. Das Skript meldet diesen Fall als Fehler. Ein leerer Auszug wird nicht als Beleg für eine leere Tabelle ausgegeben.
Sind sämtliche gewünschten Daten damit wiederherstellbar?
Das lässt sich aus einem erfolgreichen Textfilterlauf nicht ableiten. Eine Wiederherstellungsprobe mit Schema-, Zeilen- und Abhängigkeitskontrolle ist eine getrennte Prüfung. Das Original bleibt unverändert erhalten.
Quellen und Stand
2026-10-24
Passend dazu