

 English
 Deutsch
 Polski
Warum gelöschte Websites weiter gecrawlt werden: Fehlercodes bei robots.txt verstehen

Management Summary
Die Antwort 410 Gone teilt mit, dass eine Seite entfernt wurde. Die Datei robots.txt hat dagegen eine andere Aufgabe: Regeln für kooperierende automatische Besucher bereitzustellen. Eine 410-Antwort für diese Regeldatei bedeutet deshalb kein Verbot weiterer Seitenabrufe. Das ist bei Stilllegung oder Entlastung einer Website wichtig. Eine zu frühe Zugriffssperre kann Suchmaschinen daran hindern, entfernte Inhalte zu erkennen. Weniger Serververkehr und die Entfernung aus Suchergebnissen sind daher getrennte Entscheidungen.
Inhalt
- Entfernung und Crawling sind verschiedene Entscheidungen
- Warum 410 auf robots.txt nicht sperrt
- Ein Serverfehler ersetzt keine dauerhafte Regel
- Was der historische Vorfall belegt
- Antwortgrößen brauchen Einheiten und Protokollkontext
- Sicherheitsheader passend zur Antwort erhalten
- Das Betriebsziel festlegen
- Fragen und Antworten
- Quellen
Ein Crawler ist ein Programm, das Seiten automatisch abruft, etwa für eine Suchmaschine. Ein stillgelegter Hostname kann entfernte Seiten mit 410 Gone beantworten und trotzdem Crawler-Anfragen erhalten. Die Antwort auf /robots.txt braucht eine eigene Prüfung: Ein Entfernungsstatus für die Regeldatei ist selbst kein Abrufverbot.
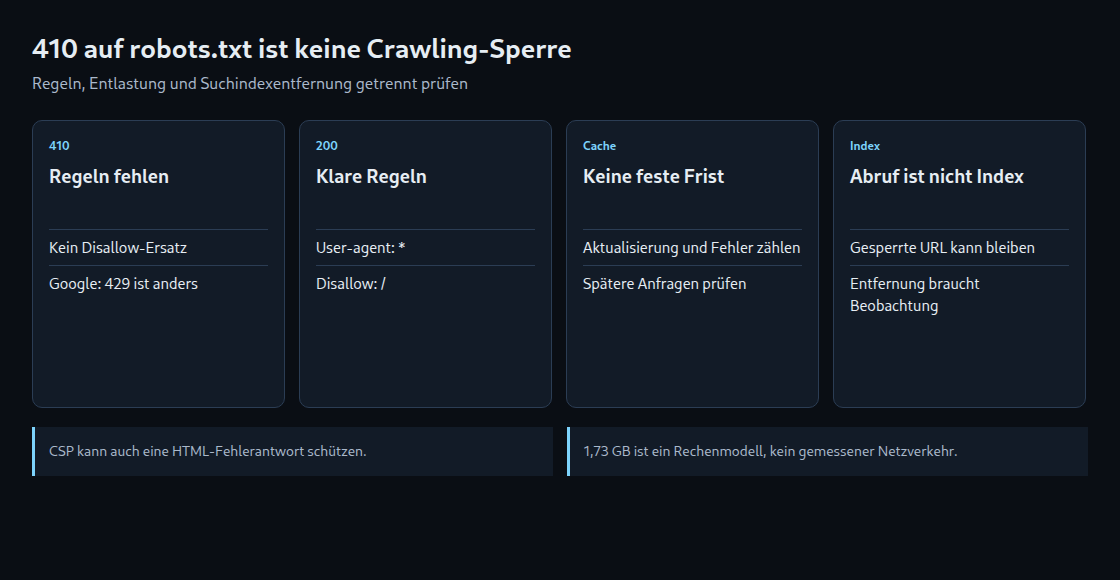
Entfernung und Crawling sind verschiedene Entscheidungen
410 bedeutet, dass die Zielressource nicht mehr verfügbar ist und dieser Zustand wahrscheinlich dauerhaft bleibt. 404 legt nicht fest, ob die Abwesenheit vorübergehend oder dauerhaft ist. Keiner der Codes garantiert sofort ausbleibende Anfragen. Googles aktuelle Dokumentation behandelt gewöhnliche 404- und 410-Antworten hinsichtlich einer späteren Entfernung aus dem Suchindex gemeinsam. Eine allgemeine Garantie schnellerer Entfernung durch 410 ist nicht begründet.
Warum 410 auf robots.txt nicht sperrt
RFC 9309 erlaubt Crawling bei einer nicht verfügbaren Regeldatei, etwa nach einer 4xx-Antwort. Das betrifft das Ausschlussprotokoll und erlaubt kein Umgehen von Anmeldung oder anderen Zugangskontrollen. Google behandelt laut Dokumentation 4xx außer 429 als fehlende Crawling-Beschränkung. Die Ausnahme ist wichtig: 429 signalisiert Überlastung.
Eine erfolgreiche Regelantwort sollte gültigen UTF-8-Klartext enthalten. Eine minimale Datei für einen stillgelegten Ursprung lautet:
User-agent: *
Disallow: /
Die Datei braucht tatsächlich eine erfolgreiche Antwort. Derselbe Text in einer 410-Antwort ist nicht gleichwertig. Die Regeln gelten für das betreffende Protokoll, den Hostnamen und Port. Vorhandene speziellere Crawlergruppen oder Allow-Regeln können das Ergebnis verändern. Die beiden Zeilen an eine komplexe Datei anzuhängen, sperrt daher nicht zwangsläufig alles.
Ein Serverfehler ersetzt keine dauerhafte Regel
RFC 9309 verlangt zunächst ein vollständiges Verbot, wenn Server- oder Netzwerkfehler die Regeldatei unerreichbar machen, erlaubt aber andere Behandlung nach längerer Störung. Googles dokumentierter Ablauf beginnt mit zwölf Stunden Crawling-Pause und verwendet danach bis zu 30 Tage die letzte gültige Kopie. Ohne gespeicherte Kopie kann das dokumentierte spätere Verhalten Abrufe zulassen. Ein absichtlich defekter Regelendpunkt ist deshalb kein guter Ersatz für klare Regeln.
Die übliche 24-Stunden-Empfehlung des Standards besitzt eine Ausnahme für unerreichbare Dateien. Google dokumentiert ebenfalls veränderliche Cachefristen. Eine garantierte Wirkung bis zum nächsten Tag gibt es nicht; erste Auswirkungen können auch früher sichtbar werden. Erfolgreiche Abrufe, tatsächlich ausgelieferte Regeln und spätere Anfragen liefern Belege. Vergangene Zeit allein genügt nicht.
Was der historische Vorfall belegt
Der archivierte Artikel beschreibt eine breite 410-Regel, die auch robots.txt erfasste, sowie viele Adressen mit Parametern. Genannt sind 732.498 Antworten insgesamt und 698.400 Anfragen mit Crawlerkennung, davon 696.907 unterschiedliche Adressen. Der ursprüngliche, zeitlich abgegrenzte Anfragedatensatz war im geprüften Artikelpaket nicht verfügbar. Diese Werte bleiben daher historische Angaben und keine unabhängig bestätigte Messung.
Rechnerisch ergeben sich 1.493 Wiederholungsanfragen, ungefähr 0,214 Prozent der Anfragen mit Crawlerkennung. Ein hoher Anteil verschiedener Adressen passt zu einem großen Adressraum. Das beweist aber weder eine endlose Linkschleife noch fortlaufende Linkentnahme aus 410-Antworten. Dafür wären Herkunftsangaben, erzeugte Links, Zeitstempel und eine bestätigte Crawleridentität nötig. Eine User-Agent-Kennung allein belegt keine Identität.
Antwortgrößen brauchen Einheiten und Protokollkontext
Als reines Rechenmodell ergeben die Artikelzahlen 732.498 × 2.364 Byte = 1.731.625.272 Byte: ungefähr 1,73 GB beziehungsweise 1,61 GiB. Bei jeweils 850 Byte entstehen 622.623.300 Byte, rund 64,0 Prozent weniger. Damit wird die frühere Angabe von 1,65 GB korrigiert.
Diese Multiplikation ist keine Messung des Netzwerkverkehrs. Headerkompression bei HTTP/2 oder HTTP/3, Inhaltskompression sowie TLS- und Transportaufwand können die tatsächliche Übertragungsmenge verändern. Die behaupteten Einzelgrößen benötigen eine dokumentierte Erfassungsmethode samt Protokoll, bevor daraus eine Bandbreitenaussage folgt.
Sicherheitsheader passend zur Antwort erhalten
Auch ein Fehlerstatus kann ein HTML-Dokument mit Skripten, Links oder übernommenen Eingaben enthalten. Eine Content Security Policy (CSP) kann festlegen, welche Skripte und weiteren Ressourcen der Browser für ein solches Dokument laden darf. Die Empfehlung „Sicherheitsheader gehören nie auf Absagen“ ist deshalb falsch. Bei einer festen Klartextantwort kann eine kleinere Richtlinie passen; entscheidend sind Inhaltstyp und Darstellung. Andere Header erfüllen andere Aufgaben und brauchen eine eigene Bewertung.
Das Betriebsziel festlegen
Ausdrückliche robots-Regeln können die Arbeit kooperierender Crawler reduzieren. Beliebige Clients und die Aktualisierungsabrufe der robots.txt werden dadurch nicht technisch gestoppt. Zugangskontrollen und Ratenbegrenzung sind eigene Maßnahmen. Das Entfernen überholter Linkerzeugung beseitigt eine weitere mögliche Ursache fortlaufender Arbeit.
Für eine Suchindexentfernung braucht ein Crawler Zugriff auf 404, 410 oder eine unterstützte noindex-Antwort. Eine vorherige Sperre kann diese Beobachtung verhindern und eine bekannte URL in den Ergebnissen belassen. Die Reihenfolge hängt davon ab, ob sofortige Entlastung oder Indexentfernung Vorrang hat. Auf das Verschwinden jeder denkbaren URL zu warten, ist kein allgemeines Verfahren. Die Prüfung umfasst jeden betroffenen Ursprung, Regelantwort, Inhaltsantworten und den folgenden Verkehr.
Fragen und Antworten
Lässt sich die robots.txt eines stillgelegten Hostnamens einfach auf die Hauptdomain weiterleiten?
Technisch ja, die Wirkung ist aber selten die gewünschte. RFC 9309 sieht vor, dass Crawler mindestens fünf aufeinanderfolgenden Weiterleitungen der robots.txt folgen sollen und die erreichte Datei dann für den ursprünglichen Hostnamen anwenden. Erlaubt die robots.txt der Hauptdomain das Crawling weitgehend, gilt das damit auch für den stillgelegten Hostnamen: Die Anfragen bleiben, nur die Regeln stammen jetzt aus einer anderen Datei.
Soll der alte Hostname gesperrt werden, braucht er eine eigene erfolgreiche Antwort mit User-agent: * und Disallow: /. Dabei gilt dieselbe Abwägung wie ohne Weiterleitung: Eine Sperre verhindert, dass Crawler die 410-Antworten der alten Seiten sehen, und kann bekannte URLs länger in den Suchergebnissen halten. Hat die Entfernung aus dem Index Vorrang, bleibt die robots.txt zunächst offen, und die Sperre folgt später.
Entlastet ein Disallow: / den Server sofort?
Nicht sofort und nicht vollständig. Kooperierende Crawler übernehmen neue Regeln erst bei ihrem nächsten Abruf; RFC 9309 empfiehlt, eine zwischengespeicherte Fassung nicht länger als 24 Stunden zu verwenden, und die robots.txt selbst wird weiter abgerufen. Clients, die sich nicht an das Protokoll halten, bremst erst eine Zugangskontrolle oder Ratenbegrenzung.
Quellen
Passend dazu


