English
 Deutsch
 Polski
Abrufhäufigkeit der robots.txt: Was historische Protokolle belegen

Management Summary
Suchprogramme rufen die robots.txt erneut ab, um Zugriffsregeln einer Website zu erhalten. Serverprotokolle machen solche Besuche sichtbar und helfen bei der Einordnung, wie oft automatische Dienste nach neuen Regeln sehen. Ein Abruf belegt jedoch noch nicht deren Anwendung; historische Summen ohne genaue Zeitgrenzen ergeben keine verlässliche Aktualisierungsfrist. Das ist bei dringenden Änderungen wichtig. Durchschnittliche Abrufhäufigkeit bietet keinen sofortigen Schutz; dafür braucht es durchgesetzte Zugriffsbeschränkungen oder Anfragegrenzen.
Inhalt
Eine Änderung der robots.txt veröffentlicht eine Anweisung, ersetzt aber keine Zugriffskontrolle. Ein protokollierter Abruf zeigt einen Kontakt zum Server. Daraus folgt noch nicht, dass ein Crawler die neuen Regeln erhalten, verstanden und angewandt hat. Die erhaltene Auswertung ist hilfreich, erlaubt aber nur begrenzte Schlüsse.
Die erhaltenen Belege
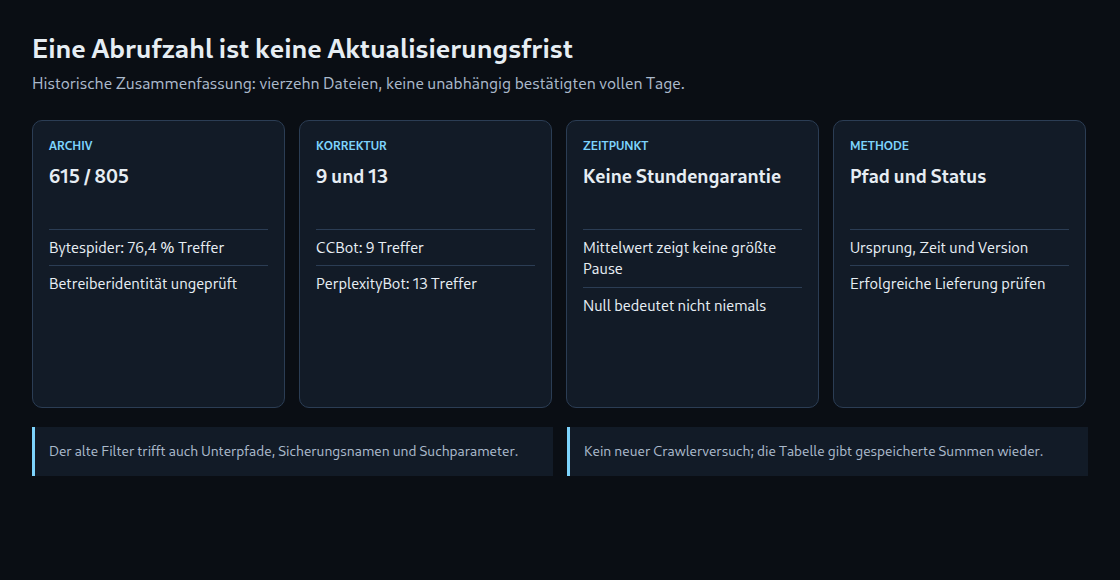
Der ursprüngliche Artikel nennt den 22. August bis 4. September 2026. Die gespeicherte Ausgabe enthält vierzehn Protokolldateigruppen; das Skript wählt die aktuelle Apache-Datei und dreizehn rotierte Dateien aus. Bei der Rotation wandern ältere Einträge in getrennte Dateien. Eine Datei muss deshalb nicht genau einen Tag abdecken. Zeitstempel werden nicht gefiltert. Vierzehn Dateien belegen deshalb weder vierzehn vollständige Tage noch unabhängig den genannten Zeitraum.
Das überarbeitete historische Skript berücksichtigt Hauptdomain und www-Präfix. Die Zuordnung erfolgt anhand des User-Agent-Textes ohne Prüfung der Quell-IP. Das sind angegebene Kennungen, keine bestätigten Betreiberidentitäten. Gezählt wird außerdem jede Anfragezeile mit robots.txt, auch ein Unterpfad, ein Sicherungsdateiname oder ein Suchparameter. Methode und Antwortstatus bleiben ungeprüft.
Was die gespeicherten Zahlen aussagen
Die Tabelle gibt die erhaltene Zusammenfassung wieder. Die letzte Spalte teilt durch vierzehn, damit die ursprüngliche Rechnung vergleichbar bleibt. Daraus wird keine neu bestätigte Tagesrate. Übrige Anfragen sind nicht automatisch Seiten: Auch Weiterleitungen, Fehler und Dateien können enthalten sein.
Für CCBot sind neun Treffer gespeichert, nicht die aus drei Abrufen täglich folgende Zahl. PerplexityBot hat dreizehn Treffer: rund 0,9 statt 1,9 je rechnerischem Tag. Bei Bytespider entsprechen 615 von 805 Anfragen 76,4 Prozent; bei OAI-SearchBot ergeben 152 von 477 rund 31,9 Prozent. Das sind Anfrageanteile, keine Nachweise erfolgreicher Regelabrufe.
| Angegebene Kennung | Anfragen | robots.txt-Treffer | Treffer / 14 |
|---|---|---|---|
| Bytespider | 805 | 615 | 43,9 |
| ClaudeBot | 10 227 745 | 601 | 42,9 |
| OAI-SearchBot | 477 | 152 | 10,9 |
| Applebot | 958 | 147 | 10,5 |
| Googlebot | 875 | 124 | 8,9 |
| bingbot | 4 357 | 69 | 4,9 |
| PerplexityBot | 607 | 13 | 0,9 |
| CCBot | 167 | 9 | 0,6 |
| Amazonbot | 10 700 | 9 | 0,6 |
| ChatGPT-User | 1 047 | 1 | 0,1 |
| meta-externalagent | 1 851 | 0 | 0,0 |
| GPTBot | 1 464 | 0 | 0,0 |
Ein Mittelwert ist keine Frist
Selbst wenn 615 Anfragen genau vierzehn Tage abdeckten, ergäbe die Division weder die längste Pause noch den nächsten Abruf oder den Zeitpunkt der Regelanwendung. Mehrere Prozesse, verschiedene Kombinationen aus Protokoll, Host und Port, gebündelte Anfragen und Wiederholungen können denselben Mittelwert erzeugen.
Null Treffer bedeuten nur keinen Treffer in dieser Zusammenfassung. Geteilte Zwischenspeicher, andere Kennungen, fehlende Protokolle oder falsche Zuordnung bleiben mögliche Erklärungen. Umgekehrt ist eine vierzehn Tage alte Kopie nicht automatisch gerechtfertigt: RFC 9309 empfiehlt die Erneuerung innerhalb von 24 Stunden, außer bei Nichterreichbarkeit. Für die bisher behauptete Wirkung nach sieben Minuten fehlt im geprüften Paket eine zeitgestempelte Vorher/Nachher-Aufzeichnung.
Dienstklasse und Fehlerfall unterscheiden
ChatGPT-User ist als durch Nutzeraktionen ausgelöster Agent dokumentiert, nicht als automatischer Webcrawler. Auf solche Anfragen müssen robots.txt-Regeln nicht zutreffen. Eine Rangliste mit unterstelltem identischem Aktualisierungsauftrag wäre deshalb irreführend. Google beschreibt zudem gemeinsam genutzte robots.txt-Zwischenspeicher verschiedener Crawler.
RFC 9309 erlaubt Zugriff bei einer nicht verfügbaren robots.txt, etwa nach 4xx, und verlangt bei Server- oder Netzfehlern zunächst die Annahme einer Sperre; für lange Ausfälle besteht eine Ausnahme. Google behandelt gewöhnliche 4xx als fehlende Abrufbeschränkung, 429 jedoch anders. Bei Serverfehlern pausiert Google zunächst zwölf Stunden und kann danach die letzte gültige Fassung verwenden. Ohne gespeicherte Fassung kann der Abruf unbeschränkt weitergehen. Ein 503 ist deshalb keine verlässliche dauerhafte Sperre.
Ein 403 auf robots.txt hebt weder Anmeldung noch Firewallregeln anderer URLs auf. Ein 304 kann eine gespeicherte Fassung gültig bestätigen. Ein klarer 200 mit aktuellem Text ist hilfreich; die Forderung, jede zulässige Antwort müsse 200 sein, wäre jedoch falsch.
Eine belastbarere Messung
Eine Folgeauswertung benötigt festen Zeitraum und Zeitzone, Protokoll, Host, Port, exakten Pfad, Methode, Status und Regelversion. Die Betreiberidentität braucht eine eigene Prüfung. Auch CDN-Protokolle und Zeitstempel für Abrufpausen gehören dazu. Ein Inhalts-Hash ist ein aus dem Dateiinhalt berechneter Fingerabdruck. Dieser Hash oder eine Versionskennung verknüpft einen erfolgreichen Abruf mit den geänderten Regeln.
Die Google Search Console erlaubt bei wichtigen Änderungen eine erneute robots.txt-Abfrage. Daraus folgt keine sofortige Abfrage der betroffenen Seiten. Andere Anbieter benötigen jeweils aktuelle Belege. Dringender Schutz gehört in Zugriffskontrollen oder passende Ratenbegrenzungen mit klarer Reichweite. robots.txt entfernt keine URLs selbst aus einem Index. Ein lesbares noindex, entfernte Inhalte oder beschränkter Zugriff dienen unterschiedlichen Zielen.
Quellen
Passend dazu