

 English
 Deutsch
 Polski
Łączenie danych w Looker Studio: unikanie błędnych sum i podwójnych wierszy

Management Summary
Looker Studio może łączyć informacje z różnych źródeł w jednym raporcie, na przykład koszty kampanii z wynikami. Takie łączenie nosi nazwę data blending. Użyteczne liczby powstają wtedy, gdy dopasowane zapisy opisują zgodne jednostki, choćby jedną kampanię w jednym dniu. W przeciwnym razie sumy i wskaźniki mogą być zniekształcone mimo wiarygodnego wyglądu. Artykuł wyjaśnia znaczenie każdego wiersza, brakujących danych i sposobu dodawania wartości dla rzetelnych porównań biznesowych.
Przejdź do interaktywnego przykładu ↓
Spis treści
Data Blending łączy tabele z kilku źródeł w jednym wykresie. Złączenie przyporządkowuje wiersze według pasujących wartości, na przykład tej samej daty i identyfikatora kampanii. Wiarygodnie wyglądające sumy nadal mogą być błędne, gdy złączenie powtarza wartości, usuwa niedopasowane klucze lub łączy niezgodne metryki. Rzetelna kontrola obejmuje poszczególne klucze i sumy.
Znaczenie mają trzy etapy: grupowanie każdej tabeli według wybranych wymiarów, łączenie powstałych wierszy oraz możliwa ponowna agregacja w wykresie. Kontroli wymagają też filtry tabel, zakresy dat i filtry wykresu. Sam typ złączenia nie określa końcowej liczby.
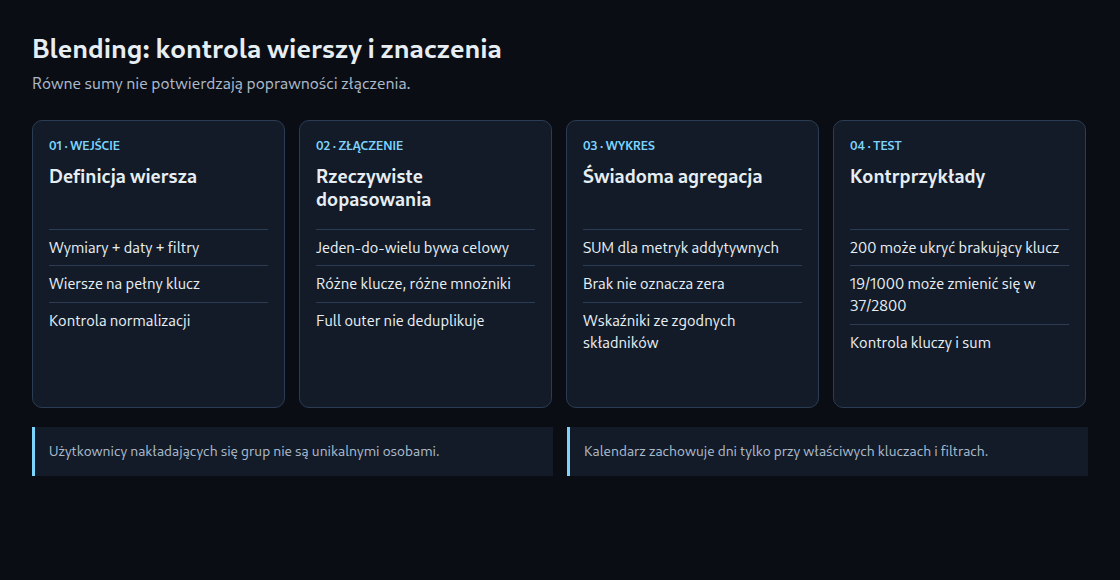
1. Określenie znaczenia jednego wiersza
Przed wyborem pól warto określić docelowy wiersz: jeden dzień, kampania w danym dniu lub zamówienie. Klucz musi odpowiadać temu poziomowi szczegółowości. Warunek złożony może zawierać osobne pola daty i kampanii; sklejanie tekstów nie jest potrzebne.
Jeżeli wiersz daty zawiera 100 sesji i pasuje do trzech wierszy kampanii, złączenie tworzy trzy kopie wartości sesji. Późniejsze SUM daje 300. Mnożnik wynosi trzy tylko dla kluczy z dokładnie trzema dopasowaniami. Łączna suma zależy zarówno od wartości metryk, jak i liczby dopasowań.
Złączenie jeden-do-wielu nie zawsze jest błędem: suma kampanii może celowo towarzyszyć szczegółom dziennym. Oznaczenie i agregacja muszą wtedy odpowiadać znaczeniu danych. AVG lub MAX nie jest uniwersalną deduplikacją i może zgubić wkład innych kampanii. Jeden wiersz na klucz po obu stronach jest prostą opcją dla porównania jeden-do-jednego.
2. Wybór złączenia według pytania raportu
Left outer zachowuje lewe wiersze i dołącza dopasowania z prawej. Right outer odwraca ten wybór. Inner zachowuje tylko pasujące pary. Full outer zachowuje też niedopasowane wiersze obu stron. Cross łączy każdy wiersz z każdym i nie wymaga klucza.
Full outer nie zapobiega powtórzeniom i nie tworzy dni nieobecnych w obu źródłach. Kalendarz z jednym wierszem na wymagany dzień może być podstawą left joinów, jeśli wszystkie złączenia używają jego daty, a późniejsze filtry nie usuwają niedopasowanych wierszy. Przy full outer wyświetlana data może wymagać IFNULL(data_lewa, data_prawa).
Kolejne złączenia pracują na wynikach wcześniejszych operacji. Pierwsza fizyczna tabela nie jest więc całym lewym wejściem każdego następnego złączenia. Blend obsługuje najwyżej pięć tabel, wliczając kalendarz. Niezależne wykresy mogą używać osobnych blendów; jeden wykres z większą liczbą wejść może wymagać wcześniejszego przygotowania danych.
3. Kontrola kluczy i rzeczywistych wierszy wejściowych
Data i znacznik czasu wymagają zgodnych typów oraz jawnej strefy czasowej raportu. Konwersja blisko północy może przypisać to samo zdarzenie do różnych dni. LOWER i TRIM mogą normalizować nazwy kampanii tylko wtedy, gdy pozwala na to znaczenie biznesowe. Różne identyfikatory nie powinny łączyć się wyłącznie z powodu podobnej pisowni.
Klucz można przygotować w źródle lub w obsługiwanym polu obliczeniowym pojedynczej tabeli blendu. Obliczenia wewnątrz jednej tabeli mogą używać tylko jej pól. Obliczenia łączące pola kilku tabel należą do etapu po złączeniu, na przykład do wykresu.
Record Count często liczy bazowe rekordy źródła, a nie wstępnie zagregowane wiersze złączenia. Dzienne złączenie jeden-do-jednego może więc pokazać wartość większą od jednego. Tabela diagnostyczna powinna ujawniać wszystkie wybrane wymiary, liczbę wierszy na pełny klucz i brakujące klucze. Przekroczenie czasu konektora może wywołać komunikat błędu; pusty wykres sam nie wyjaśnia przyczyny.
4. Czytelne nazwy pól
Aliasy takie jak sessions_a i sessions_b ułatwiają kontrolę formuł. Nadal potrzebny jest wybór właściwego pola źródłowego. Identyczne nazwy wyświetlane nie dowodzą same w sobie, że program po cichu obliczył błędną sumę.
Metryki źródłowe mogą być agregowane ponownie po połączeniu. SUM pasuje do wartości addytywnych na docelowym poziomie, lecz nie naprawia powielonych wierszy ani liczby unikalnych użytkowników. Przed zmianą agregacji automatycznej potrzebne jest zrozumienie jej działania. Dwa wykresy mogą używać jednego blendu na różnych poziomach, jeśli pozwala na to znaczenie metryk.
5. Rozdzielenie użytkowników, zdarzeń i wskaźników
Suma użytkowników regionalnych usług liczy przynależności do usług, niekoniecznie unikalne osoby. Dzienne liczby unikalnych użytkowników również nie wyznaczają unikalnej liczby miesięcznej: ta sama osoba odwiedzająca stronę w poniedziałek i wtorek jest liczona w obu dniach, lecz w miesiącu powinna być policzona tylko raz. Takie zliczenia są addytywne wyłącznie przy znanych rozłącznych populacjach. Sam eksport zdarzeń nie rozwiązuje identyfikacji między usługami: deduplikacja wymaga prawidłowego identyfikatora o wspólnym zakresie i określonej reguły tożsamości.
Dla dwóch rozłącznych źródeł o zgodnych definicjach wskaźnik można obliczyć z sum składników. W przykładzie converted_sessions liczy sesje z co najmniej jednym pasującym wynikiem. Liczba zdarzeń w liczniku zmieniłaby znaczenie na zdarzenia na sesję i mogłaby przekroczyć 100 procent.
Brak wartości nie oznacza automatycznie zera. Nieudany import, brak dopasowania klucza i potwierdzony dzień bez aktywności mają różne znaczenie. Poniższa formuła celowo pozostawia niepełne dane nierozstrzygnięte; zastąpienie zerem jest właściwe tylko przy potwierdzonej zerowej aktywności.
CASE
  WHEN SUM(
    CASE
      WHEN sessions_a IS NULL OR sessions_b IS NULL
        OR converted_sessions_a IS NULL
        OR converted_sessions_b IS NULL
      THEN 1 ELSE 0
    END
  ) > 0 THEN NULL
  ELSE
    (SUM(converted_sessions_a) + SUM(converted_sessions_b))
    / NULLIF(SUM(sessions_a) + SUM(sessions_b), 0)
END
Formuła wykresu zakłada jeden kompletny wiersz na wspólny klucz po obu stronach, rozłączne populacje, zgodne okresy i nieujemne liczby sesji. Nazwy pól są przykładowymi aliasami. Każdy niepełny połączony wiersz pozostawia pusty wynik; osobna kontrola kompletności musi też wykryć daty lub klucze nieobecne w obu źródłach. Wynik liczbowy jest ułamkiem wyświetlanym jako procent.
6. Testowanie kontrprzykładami
W przykładzie A ma 100 sesji i 10 wyników, a B ma 900 sesji i 9 wyników. Łączny wskaźnik wynosi 19/1000 = 1,9%. Jeśli A pasuje raz, a B trzy razy, SUM po złączeniu daje 37/2800, około 1,32%. Licznik i mianownik z tego samego źródła nie zachowują łącznego wskaźnika przy różnych liczbach dopasowań.
Równe sumy nie dowodzą poprawności. Początkowe A=100 i B=100 dają 200; wynik z A powtórzonym dwukrotnie i brakującym B również daje 200. Porównanie musi obejmować pokrycie kluczy i pojedyncze wartości. Większe lub mniejsze sumy są wskazówkami, nie jednoznaczną diagnozą: różnić mogą się też daty, filtry, definicje metryk i aktualność źródeł.
Kontrola odbiorcza porównuje jednakowe daty, filtry i definicje metryk w źródle oraz blendzie. Następnie obejmuje reprezentatywne klucze, brakujące dopasowania i zerowe mianowniki. Połączone wiersze trzeba oceniać przy agregacji faktycznie używanej w wykresie.
Pytania i odpowiedzi
Czy brakująca prawa wartość staje się poprawna, gdy wykres pokazuje zero?
Nie. Format wyświetlania nie potwierdza rzeczywistego zera. Pokrycie dopasowań i kompletność źródła powinny być widoczne osobno. Wskaźnik pozostaje niedostępny, gdy istotne dane wejściowe są nieznane.
Dlaczego dodatkowy wymiar może zmienić sumę?
Dodatkowy wymiar może podzielić zagregowany wiersz na kilka wierszy z tym samym kluczem. Wartość drugiej strony może wtedy wystąpić wielokrotnie. Przy tylko jednej wartości wymiaru na klucz liczba wierszy nie musi się zmienić; decydują rzeczywiste dane.
Co w przypadku sześciu źródeł?
Limit pięciu tabel dotyczy jednego blendu, nie całego raportu. Oddzielne wykresy mogą używać osobnych blendów. Jeśli jedno obliczenie wymaga sześciu wejść, wcześniejsza tabela lub widok może dostarczyć przygotowane dane jako jedno źródło. Kalendarz również zajmuje miejsce tabeli.
Zrozum przez eksperyment
Skąd wzięły się dodatkowe koszty?
Trzy kampanie kosztują łącznie 200 €. Alpha ma dwa zakupy. Połącz tabele i zobacz, co stanie się przy sumowaniu kosztów.
Kampanie i koszty
Alpha   100 €
Beta     60 €
Gamma    40 €
Poszczególne zakupy i przychód
Alpha / P1   80 €
Alpha / P2  120 €
Beta  / P3   90 €
| Kampania | Koszt | Przychód |
|---|
- Suma wierszy z kosztami
- Suma przychodu
Kluczem złączenia jest kampania. Bez agregacji identyfikator zakupu pozostaje wymiarem: Alpha daje dwa pasujące wiersze, powielając koszt. INNER JOIN usuwa Gammę bez zakupu również po agregacji. — oznacza brak wartości; puste pola przychodu są pomijane w sumie. Stały przykład wyjaśnia liczbę dopasowań i poziom szczegółowości danych; nie wykonuje zapytania w Looker Studio.
Ten moduł działa w przeglądarce i nie wysyła ani nie zapisuje wpisanych danych.
Zrozum przez eksperyment
Jedna minuta: znajdziesz błąd?
Alpha kosztuje 100 € i ma dwa zakupy. Po złączeniu z poszczególnymi zakupami sumujesz wiersze kosztów. Jaki wynik otrzymasz dla samej Alphy?
Oba wiersze zakupów zawierają koszt: 100 € + 100 €. Najpierw zsumuj zakupy na poziomie kampanii, jeśli koszt każdej kampanii ma wejść do sumy tylko raz.
Znajdź błąd
Odkrywaj
Znajdź błąd
Problem, dwie wskazówki i Twoja decyzja. Najpierw sprawdź wskazówki, potem zobacz, co zmienia poprawka.
- Problem
- Sprawdź wskazówki
- Przetestuj poprawkę
Otwórz obie wskazówki, zanim wybierzesz poprawkę.
Przeczytaj powiązany artykuł →
PNG z ustawieniami, wynikiem i adresem artykułu. Powstaje lokalnie dopiero po kliknięciu.
Ćwiczenia obliczają wyniki w przeglądarce. Moduł nauki nie wysyła Twoich odpowiedzi.
Znajdź ukryte problemy
Uproszczony model edukacyjny
Znajdź ukryte problemy
Każdy przykład kryje trzy problemy. Kliknij podejrzane miejsce i sprawdź swoje przypuszczenie.
Wybierz miejsce. Czy jest tu problem, czy w tym przykładzie wszystko się zgadza?
Fikcyjne, celowo uproszczone przykłady. Każde miejsce zawiera pełny kontekst; to nie ocena Twojej strony ani urządzeń.
Przejdź do powiązanego artykułu →
Te przykłady działają tylko w Twojej przeglądarce. Nie zakłócają prawdziwych systemów.
PNG z ustawieniami, wynikiem i adresem artykułu. Powstaje lokalnie dopiero po kliknięciu.
Powiązane artykuły


