

 English
 Deutsch
 Polski
Jaki format obrazu otrzymuje przeglądarka: kontrola wyboru formatu i pamięci podręcznej

Management Summary
Witryny mogą dostarczać ten sam obraz w różnych formatach dopasowanych do przeglądarki i oszczędzających transmisję. Pamięć podręczna musi rozdzielać warianty; instrukcja Vary wskazuje istotne różnice żądań. Historyczna próba dwudziestu stron wykazała odmienne formaty, lecz mieszane metody pobierania ograniczają wyjaśnienie przyczyn. Dobre obrazy na stronie wymagają też zarezerwowanego miejsca, odpowiedniego ładowania i opisów zwiększających dostępność treści.
Spis treści
Serwer może dostarczać różne formaty obrazu pod tym samym adresem. Nagłówek żądania Accept określa preferowane typy mediów, a nagłówek odpowiedzi Vary pomaga pamięci cache wybrać pasującą zapisaną odpowiedź. Inny typ zawartości ani brak nagłówka nie dowodzą jednak błędnego wyświetlania obrazu.
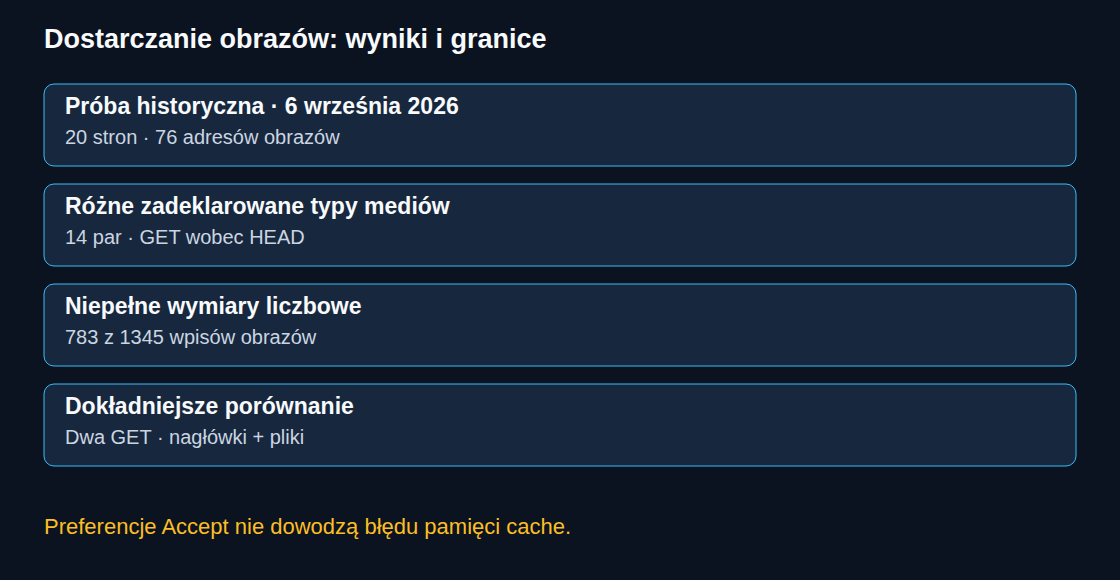
Historyczna kontrola dwudziestu stron głównych z 6 września 2026 r. objęła 1345 wpisów obrazów i próbę 76 adresów. Zapisane wyniki pozostają przydatne, ale pierwotna interpretacja przeceniała metodę: implementacja porównywała żądanie GET z HEAD, a nie dwa poza tym jednakowe żądania GET. GET żąda nagłówków i treści odpowiedzi; HEAD żąda nagłówków bez treści odpowiedzi. Poniższy opis oddziela zapisane wartości od wniosków wymagających nowego, kontrolowanego testu.
Co rzeczywiście zapisano w próbie
W czternastu z 76 par zadeklarowane typy mediów były różne. Sześć próbek New York Times wskazywało WebP wobec JPEG z Vary: Accept. Sześć próbek Zeit wskazywało WebP wobec JPEG bez zapisanej wartości Vary, a dwie próbki Onetu — AVIF wobec PNG również bez tej wartości. W pozostałych 62 parach zadeklarowany typ był taki sam. Nie oznacza to potwierdzenia identycznej zawartości plików.
Żądania różniły się zarówno metodą, jak i Accept. Ponadto żądanie alternatywne zawierało Accept: image/*. Taki zapis dopuszcza AVIF i WebP, więc nie odwzorowuje przeglądarki bez obsługi tych formatów. Czternaście różnic stanowi wskazówki do dalszej kontroli, a nie samodzielny dowód negocjacji na podstawie Accept. Zbiór zawiera podsumowania, bez obu plików odpowiedzi i kompletnych surowych nagłówków.
Dokładniejsze porównanie
Kontrolowane porównanie wymaga dwóch GET, tego samego adresu i jednakowych opcji poza Accept. Żądanie bazowe może jawnie wykluczyć AVIF i WebP przez q=0; zapis image/* nie wyklucza żadnego z tych formatów. Accept określa preferencje żądania. Zgodność faktycznej odpowiedzi nadal wymaga sprawdzenia.
Przydatne dane obejmują końcowy URL, status, zadeklarowany typ mediów, rzeczywisty format pliku, liczbę bajtów, skrót zawartości i pełne nagłówki. Jednakowy typ i długość nie dowodzą jednakowych bajtów. Różne bajty mogą także wynikać ze zmiany obrazu, działania CDN albo czasu pobrania. Powtórzenia oraz dostępna konfiguracja serwera pozwalają lepiej ustalić przyczynę.
Vary określa ponowne użycie odpowiedzi
Jeżeli odpowiedź dopuszczona do cache jest wybierana według Accept, Vary: Accept zwykle przekazuje to kryterium wyboru. Cache nie może po prostu ponownie użyć takiej odpowiedzi dla żądania z niepasującą wartością Accept. HTTP dopuszcza normalizację przy porównaniu wartości; oddzielna kopia dla każdej różnicy zapisu nie jest nieuniknionym wymogiem.
Możliwość przechowywania i ponownego użycia zależy również od dyrektyw cache, aktualności i konfiguracji. Brak Vary może powodować ryzyko niewłaściwego użycia odpowiedzi, ale historyczna próba nie wykazała faktycznie błędnej odpowiedzi CDN. Ograniczenia takie jak no-store i świadomie skonfigurowany klucz cache zmieniają ocenę. Vary: * uniemożliwia bezpośrednie ponowne użycie bez walidacji.
Kontrola wymaga porównania pełnych nazw nagłówków. Vary: Accept-Encoding dotyczy kodowania zawartości, a nie tego samego kryterium co Vary: Accept. Wyszukiwanie samego fragmentu accept może pomylić oba przypadki.
Potwierdzona lekcja z narzędzia
Starsza lokalna implementacja przekazywała żądany nagłówek w opcji accept. Wspólna biblioteka pobierania oczekuje opcji kopfzeilen. Porównanie tych plików źródłowych potwierdza niezgodność interfejsu: błędna opcja nie przekazywała żądanego nagłówka. Test powinien zatem sprawdzać wychodzące żądanie, a nie tylko symulowaną odpowiedź. Jednakowe odpowiedzi same w sobie nie wykluczają negocjacji.
Wymiary, ładowanie i tekst alternatywny
Zapisana analiza HTML wykazała 783 z 1345 wpisów z brakiem co najmniej jednego prawidłowego wymiaru liczbowego. Nie jest to liczba obrazów bez obu atrybutów. Sześć badanych stron miało prawidłowe wymiary przy każdym wykrytym obrazie. W przypadku Heise pełnej poprawnej pary brakowało przy 423 z 426 wpisów.
Odpowiednie width i height pomagają zarezerwować proporcje przed załadowaniem obrazu. Miejsce może również rezerwować CSS. Brak atrybutów oznacza więc punkt do sprawdzenia, a nie zmierzone przesunięcie układu. Cumulative Layout Shift mierzy, jak bardzo widoczna treść niespodziewanie przesuwa się na stronie. Pomiar wymaga obserwacji faktycznie wyświetlanej strony.
Liczba 762 także wynika z przybliżenia: wpisy te występują po pierwszych trzech obrazach w kodzie źródłowym i nie mają loading="lazy". Nie mierzono obszaru widocznego ani układu CSS. Kolejność w HTML nie dowodzi niewidoczności; ważny obraz widoczny od początku nie powinien ładować się później tylko z powodu czwartej pozycji w kodzie.
W 27 wpisach brakuje atrybutu alt. Puste alt="" może być właściwe dla obrazów czysto dekoracyjnych albo informacji już przedstawionych w sąsiednim tekście. O zasadności decyduje funkcja obrazu w kontekście. Obrazy informacyjne i funkcjonalne wymagają odpowiedniego dostępnego odpowiednika.
Granice próby
Narzędzie wybierało najwyżej sześć różnych adresów obrazów na stronę z wykrytego HTML. Nie obejmowało to wszystkich teł CSS, obrazów tworzonych skryptem ani wariantów responsywnych faktycznie wybieranych przez przeglądarkę. Sześć próbek nie dowodzi również zachowania całej usługi dostarczania obrazów.
Trzy rekordy nie zawierają wykrytych obrazów: Stack Overflow odpowiedział kodem 429, Allegro kodem 403, a zapisana odpowiedź Bund nie dała wpisów obrazów. Nie dowodzi to braku obrazów na tych stronach ani zależności dwóch stron od JavaScriptu. Odmowa lub ograniczenie dostępu opisuje konkretną próbę żądania, a nie pełną wizytę w przeglądarce.
Porównanie jednego adresu z ograniczeniami pobierania
Poniższy przykład Bash wymaga curl od wersji 8.4, file i GNU coreutils. Przykładowy adres jest symbolem zastępczym. Oba żądania używają GET, przekierowania pozostają przy HTTPS, a każde pobranie ma limit 10 MiB i 30 sekund. Wyniki pozostają w nowo utworzonym katalogu tymczasowym do analizy.
#!/usr/bin/env bash
set -euo pipefail
url='https://example.com/image.png'
out=$(mktemp -d)
printf 'Output: %s\n' "$out"
for variant in modern baseline; do
  if [ "$variant" = modern ]; then
    accept='image/avif,image/webp,image/jpeg,image/png;q=0.8,*/*;q=0'
  else
    accept='image/jpeg,image/png,image/avif;q=0,image/webp;q=0,*/*;q=0'
  fi
  curl --silent --show-error --fail --location \
    --proto '=https' --proto-redir '=https' --max-redirs 3 \
    --connect-timeout 10 --max-time 30 --max-filesize 10485760 \
    -H "Accept: $accept" -D "$out/$variant.headers" \
    -o "$out/$variant.body" \
    -w "$variant status=%{http_code} type=%{content_type} url=%{url_effective}\n" \
    "$url"
  file --mime-type "$out/$variant.body"
  wc -c < "$out/$variant.body"
  sha256sum "$out/$variant.body"
done
printf 'Full response headers: %s/*.headers\n' "$out"
Pliki nagłówków zawierają także odpowiedzi przekierowań. Znaczenie mają Vary, Cache-Control i ewentualny ETag ostatniej odpowiedzi, wraz z wypisanym statusem i końcowym URL. file pomaga rozpoznać format, ale nie zastępuje pełnego testu dekodowania obrazu. Przypisanie różnicy wyłącznie Accept wymaga powtórzeń.
Audytor dostarczania obrazów i negocjacji formatów stanowi punkt wyjścia do analizy całych stron. Implementacja sprawdzona dla tego artykułu nadal używa porównania GET/HEAD i przybliżenia według kolejności w kodzie. Wynik nie odpowiada więc przykładowi z dwoma GET. Kontrola Vary wyszukuje ponadto fragment tekstu, przez co może błędnie sklasyfikować Accept-Encoding. Te ograniczenia wymagają uwzględnienia przed uznaniem negocjacji lub błędu cache za potwierdzone.
Pytania i odpowiedzi
Czy nowoczesne formaty mogą mieć osobne adresy?
Tak. Element picture może udostępniać źródła z typami oraz zapasowy element img. Wybór przeglądarki uwzględnia również warunki mediów, kandydatów responsywnych i wymagania wyświetlania. Jeżeli każdy adres dostarcza stały skonfigurowany format, wybór między adresami unika zmienności formatu według Accept pod jednym URL. Inne przyczyny stosowania Vary mogą nadal istnieć.
Czy każdy obraz po pierwszych trzech wymaga lazy loading?
Nie. Znaczenie mają wyrenderowany układ i początkowy obszar widoczny. Obrazy położone niżej mogą korzystać z opóźnionego ładowania. Obrazy widoczne od początku, zwłaszcza prawdopodobny obraz Largest Contentful Paint, nie powinny być opóźniane na podstawie samej pozycji w kodzie.
Źródła
- IETF RFC 9110: Znaczenie HTTP – Accept i Vary
- IETF RFC 9111: Pamięć podręczna HTTP – dopasowanie Vary
- Google web.dev: Ograniczanie nieoczekiwanych przesunięć układu
- Google web.dev: Opóźnione ładowanie obrazów w przeglądarce
- W3C WAI: Obrazy dekoracyjne
- WHATWG HTML: Obrazy i wybór źródeł
- curl: Dokumentacja poleceń
Powiązane artykuły


