

 English
 Deutsch
 Polski
Änderungen an einem GTM-Tag finden: Gespeicherte und veröffentlichte Versionen vergleichen

Management Summary
Google Tag Manager speichert Versionen der Einstellungen für die Websitemessung. Der Vergleich dieser Stände hilft herauszufinden, wann ein Messelement verändert wurde, auch bei späterer Umbenennung. Das ist nützlich, wenn Berichte nach einer Veröffentlichung plötzlich andere Werte zeigen. Eine gespeicherte Version ist jedoch nicht automatisch die tatsächlich eingesetzte Fassung; der Nutzungszeitraum zählt mit. Eine gefundene Änderung grenzt die Ursache ein, beweist aber noch nicht, dass genau diese Änderung die Kennzahlen verschoben hat.
Inhalt
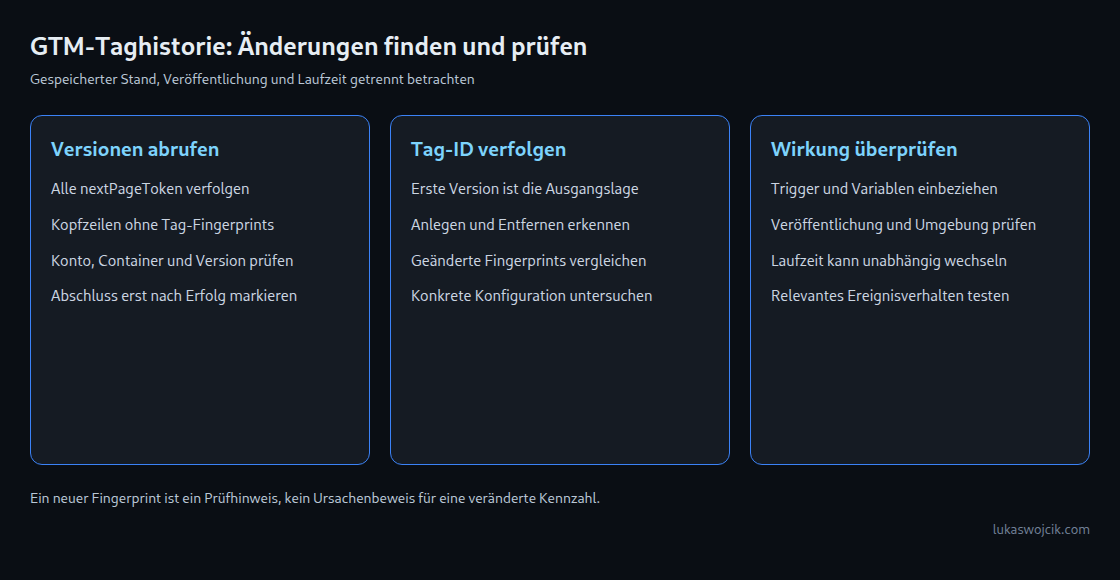
Eine Kennzahl verändert sich nach mehreren GTM-Veröffentlichungen. Für die Suche nach der Ursache helfen zwei getrennte Fragen: In welcher gespeicherten Version hat sich die Konfiguration eines Tags geändert? Und wann war diese Version tatsächlich auf der betroffenen Website aktiv? Ein Vergleich nach tagId beantwortet die erste Frage. Die Veröffentlichungshistorie und die verwendete Umgebung beantworten die zweite.
Der Ablauf: Versionen vollständig abrufen, den gleichen Tag über die Versionen verfolgen und auffällige Übergänge im Detail vergleichen. Anschließend folgen Trigger, Variablen und die Prüfung des tatsächlichen Verhaltens.
1. Gespeicherte Version und Veröffentlichung unterscheiden
Eine GTM-Version ist ein gespeicherter Konfigurationsstand. Eine Version kann ohne Veröffentlichung entstehen; außerdem kann eine ältere Version erneut veröffentlicht werden. Eine nach Versionsnummer sortierte Liste bildet deshalb keine lückenlose zeitliche Abfolge des Live-Betriebs ab. Für einen Vorfall sind Veröffentlichungszeitpunkt, Umgebung und tatsächlich eingebundener Container entscheidend. Die GTM-Oberfläche führt eine Veröffentlichungshistorie.
Ein aussagekräftiger Versionsname erleichtert die Orientierung. Die Detailansicht und der Vergleich von Änderungen bleiben trotzdem nötig. Seit September 2026 kann GTM eine KI-generierte Zusammenfassung vorschlagen; eine solche Zusammenfassung ersetzt keine Prüfung der Konfiguration.
2. Vollständige Versionen statt nur Kopfzeilen laden
Die API-Methode version_headers.list liefert unter anderem Versions-IDs, Namen und Elementzahlen. Einzelne Tag-Fingerprints stehen dort nicht. Für den Tagvergleich werden die vollständigen Antworten von versions.get benötigt. Ein nextPageToken bedeutet, dass weitere Kopfzeilen folgen. Ein einziger Listenaufruf ist daher kein verlässliches Archiv.
Voraussetzungen sind Python 3, eine aktivierte Tag Manager API und ein gültiges OAuth-Zugriffstoken mit https://www.googleapis.com/auth/tagmanager.readonly. Die authentifizierte Identität benötigt zusätzlich Zugriff auf den betreffenden GTM-Container. Die numerischen API-IDs sind keine öffentlichen Kennungen wie GTM-XXXX. Konfigurationen und Token gehören in einen geschützten Arbeitsbereich.
Das folgende Beispiel wird als archive.py gespeichert. Das Token liegt in der Umgebungsvariable GTM_ACCESS_TOKEN; keine Aufnahme in den Quelltext oder ein öffentliches Protokoll. Das Ausgabeverzeichnis muss neu sein. Der Code folgt allen Seiten, prüft Konto und Container und schreibt complete.json erst nach allen erfolgreichen Downloads. Gelöschte Versionen sind ausdrücklich ausgeschlossen.
import json
import os
import re
import sys
import time
from datetime import datetime, timezone
from pathlib import Path
from urllib.parse import urlencode
from urllib.request import Request, urlopen

BASE = "https://tagmanager.googleapis.com/tagmanager/v2/"


def check_version(data, account, container, version):
    expected = {"accountId": account, "containerId": container,
                "containerVersionId": version}
    if not isinstance(data, dict) or any(data.get(k) != v for k, v in expected.items()):
        raise ValueError("Unexpected container/version identity")
    if "error" in data or data.get("deleted", False) is not False:
        raise ValueError("Error response or deleted version")
    tags = data.get("tag", [])
    if not isinstance(tags, list):
        raise ValueError("Invalid tag list")
    ids = []
    for tag in tags:
        if not isinstance(tag, dict) or not isinstance(tag.get("tagId"), str):
            raise ValueError("Invalid tag")
        ids.append(tag["tagId"])
    if len(ids) != len(set(ids)):
        raise ValueError("Duplicate tag IDs")
    return data


def collect(account, container, output, get):
    if not all(re.fullmatch(r"[0-9]+", x) for x in (account, container)):
        raise ValueError("Numeric API account/container IDs required")
    output = Path(output)
    output.mkdir(mode=0o700)  # Existing directory is an error.
    parent = f"accounts/{account}/containers/{container}"
    versions, seen_tokens, token = set(), set(), ""
    while True:
        query = {"includeDeleted": "false"}
        if token:
            query["pageToken"] = token
        page = get(parent + "/version_headers?" + urlencode(query))
        if not isinstance(page, dict) or "error" in page:
            raise ValueError("Invalid headers response")
        headers = page.get("containerVersionHeader", [])
        if not isinstance(headers, list):
            raise ValueError("Invalid headers list")
        for item in headers:
            if not isinstance(item, dict):
                raise ValueError("Invalid header")
            version = item.get("containerVersionId", "")
            if (item.get("accountId") != account or item.get("containerId") != container
                    or not isinstance(version, str) or not re.fullmatch(r"[1-9][0-9]*", version)
                    or item.get("deleted", False) is not False or version in versions):
                raise ValueError("Unexpected or duplicate version header")
            versions.add(version)
        token = page.get("nextPageToken", "")
        if not isinstance(token, str) or token in seen_tokens:
            raise ValueError("Invalid/repeated page token")
        if not token:
            break
        seen_tokens.add(token)
    for version in sorted(versions, key=int):
        data = check_version(get(parent + "/versions/" + version), account, container, version)
        temporary = output / ("version-" + version + ".tmp")
        with temporary.open("x", encoding="utf-8") as handle:
            json.dump(data, handle, ensure_ascii=False, indent=2)
        temporary.replace(output / ("version-" + version + ".json"))
    manifest = {"accountId": account, "containerId": container,
                "versions": sorted(versions, key=int),
                "completedAt": datetime.now(timezone.utc).isoformat()}
    (output / "complete.json").write_text(json.dumps(manifest, indent=2), encoding="utf-8")
    return manifest


def main():
    account, container, output = sys.argv[1:]
    token = os.environ["GTM_ACCESS_TOKEN"]
    os.umask(0o077)
    def get(path):
        time.sleep(5)  # Other clients share the project's quota.
        request = Request(BASE + path, headers={"Authorization": "Bearer " + token})
        with urlopen(request, timeout=30) as response:
            return json.load(response)
    collect(account, container, output, get)


if __name__ == "__main__":
    main()
python3 archive.py 6000000001 7000000002 archive-20261024Ein HTTP-Fehler, ein abgelaufenes Token, ungültiges JSON oder eine unerwartete Identität beendet den Lauf. Bereits gespeicherte Dateien können dann vorhanden sein, aber ohne complete.json gilt das Archiv als unvollständig. Nach Behebung der Ursache beginnt ein neuer Lauf in einem neuen Verzeichnis. Ein unbekanntes Fehlerobjekt wird nicht als gültige Containerversion wiederverwendet.
Die dokumentierten Standardgrenzen betragen 10.000 Anfragen pro Projekt und Tag sowie 25 Anfragen in einem gleitenden Fenster von 100 Sekunden. Das Beispiel wartet fünf Sekunden vor jeder Anfrage. Andere Clients desselben Projekts verbrauchen dasselbe Kontingent; die Pause garantiert daher keinen Erfolg. Google dokumentiert bei Kontingentüberschreitung einen HTTP-403-Fehler. Der konkrete Fehlergrund entscheidet über die Behebung; eine pauschale Sperre bis zum Ende der Stunde ist nicht belegt.
3. Änderungen des gleichen Tags verfolgen
Eine Umbenennung verändert den Namen des bestehenden Tags; die Tag-ID bleibt gleich. Deshalb erfolgt die Auswahl nach tagId innerhalb desselben Kontos und Containers. Der API-Fingerprint ist eine von GTM berechnete Änderungskennung. Die Dokumentation beschreibt eine Neuberechnung bei Änderungen; eine kryptografische Prüfsumme oder ein Beweis für verändertes Messverhalten ist damit nicht zugesichert.
tag_history.py liegt neben archive.py. Der Aufruf unten untersucht beispielhaft Tag 25. Das Beispiel erwartet ausschließlich das Archivformat des vorherigen Scripts, keine anders verpackten JSON-Exporte aus der Oberfläche.
import difflib
import json
import sys
from pathlib import Path
from archive import check_version


def analyse(directory, tag_id):
    directory = Path(directory)
    manifest = json.loads((directory / "complete.json").read_text(encoding="utf-8"))
    versions = manifest["versions"]
    if not versions or len(set(versions)) != len(versions):
        raise ValueError("Empty or duplicate version manifest")
    previous, first, rows, diffs = None, True, [], []
    for version in sorted(versions, key=int):
        if not isinstance(version, str) or not version.isascii() or not version.isdecimal():
            raise ValueError("Invalid version ID")
        data = json.loads((directory / f"version-{version}.json").read_text(encoding="utf-8"))
        check_version(data, manifest["accountId"], manifest["containerId"], version)
        tag = next((t for t in data.get("tag", []) if t["tagId"] == tag_id), None)
        if tag is not None and (not isinstance(tag.get("fingerprint"), str) or not tag["fingerprint"]):
            raise ValueError("Missing tag fingerprint")
        state = ("BASELINE_PRESENT" if tag is not None else "BASELINE_ABSENT") if first else (
            "ADDED" if previous is None and tag is not None else
            "REMOVED" if previous is not None and tag is None else
            "ABSENT" if tag is None else
            "CHANGED" if previous["fingerprint"] != tag["fingerprint"] else "UNCHANGED")
        rows.append((version, state))
        if not first and state in {"ADDED", "REMOVED", "CHANGED"}:
            def normalise(value):
                if value is None:
                    return "null\n"
                metadata = {"path", "accountId", "containerId", "workspaceId", "fingerprint", "tagManagerUrl"}
                return json.dumps({k: v for k, v in value.items() if k not in metadata},
                                  ensure_ascii=False, sort_keys=True, indent=2) + "\n"
            diffs.append("".join(difflib.unified_diff(
                normalise(previous).splitlines(keepends=True),
                normalise(tag).splitlines(keepends=True),
                fromfile="previous saved version", tofile="version " + version)))
        previous, first = tag, False
    return rows, diffs


if __name__ == "__main__":
    rows, diffs = analyse(sys.argv[1], sys.argv[2])
    for version, state in rows:
        print(version, state)
    for diff in diffs:
        print(diff)
python3 tag_history.py archive-20261024 25BASELINE_PRESENT und BASELINE_ABSENT beschreiben nur den ersten untersuchten Stand. ADDED bezeichnet einen Übergang von abwesend zu vorhanden, REMOVED die Gegenrichtung. CHANGED kennzeichnet einen anderen Fingerprint; UNCHANGED einen gleichen. ABSENT bedeutet weiterhin nicht vorhanden. Damit bleibt auch eine spätere Wiederaufnahme mit gleichem Fingerprint sichtbar.
Ein Ergebnis wie „Version 44: CHANGED“ grenzt einen Übergang zwischen zwei gespeicherten Ständen ein. Fehlende Versionen, unsichtbare Zwischenänderungen oder ein nicht erfasster Beginn bleiben Grenzen der Aussage. Die erste vorhandene Version belegt nicht automatisch den Zeitpunkt der ursprünglichen Taganlage.
4. Den Unterschied fachlich lesen
Bei auffälligen Übergängen erzeugt das Script einen Textvergleich. Nur die ausdrücklich genannten Verwaltungsfelder auf der obersten Tag-Ebene werden ausgeblendet. Namen, Notizen und Parameter bleiben erhalten. Die Sortierung vereinheitlicht Objektschlüssel; die Reihenfolge von Arrays bleibt unverändert. Eine Umbenennung erscheint daher weiterhin als Konfigurationsunterschied. Ein leerer Textvergleich trotz neuem Fingerprint kann durch ausgeblendete Metadaten entstehen.
Wichtige Prüfpunkte sind Parameterwerte, auslösende und blockierende Trigger, Pausierung, Einwilligungseinstellungen und vor- oder nachgeschaltete Tags. Ein unveränderter Tag kann anders arbeiten, wenn eine referenzierte Variable, ein Trigger, eine Vorlage oder ein externer Datenwert verändert wurde. Die Suche darf deshalb nicht beim Fingerprint des Haupttags enden. Ein Vergleich vollständiger Container zeigt weitere geänderte Bestandteile. Ob diese Änderungen die Messung beeinflussen, muss anschließend geprüft werden.
Für umfangreichere Vergleiche ergänzt das Normalisieren zweier GTM-Exporte vor dem Vergleich den Ablauf. Unterschiedliche Exportformate und bedeutungsvolle Array-Reihenfolgen benötigen dabei besondere Aufmerksamkeit.
5. Konfigurationsänderung und Ursache trennen
Ein veränderter Parameter zur passenden Zeit ist ein Prüfhinweis. Ein ursächlicher Zusammenhang mit einer Kennzahl benötigt zusätzlich einen kontrollierten Funktionstest, beispielsweise in einer Testumgebung mit Tag Assistant, sowie passende Netzwerk- und Ereignisdaten. Veröffentlichende Person und Urheberschaft jeder einzelnen Änderung sind ebenfalls unterschiedliche Informationen.
Seit dem GTM-Update vom 8. Oktober 2026 können sichtbare gtag.config-Ereignisse Wildcard-Trigger erreichen; die Initialisierung erfolgt beim Laden des Containers. Solche Änderungen der Google-Laufzeit lassen sich nicht allein durch den Vergleich gespeicherter Tags erklären. Die separat angebotene Containeroptimierung kann dagegen Änderungen in den Workspace übernehmen. Dabei sind Berechtigungen laut Google nicht versioniert: Ein Rollback stellt frühere Zugriffsrechte nicht wieder her. Die Einordnung der GTM-/Google-Tag-Änderungen 2026 beschreibt diesen Unterschied näher.
Fragen und Antworten
Ist ein erfolgreicher Abruf ein vollständiges historisches Archiv?
Erfasst werden die zum Abrufzeitpunkt über diese Identität verfügbaren, nicht gelöschten Versionen. Die API-Aufrufe laufen nacheinander. Deshalb erfasst das Archiv nicht alle Versionen zum exakt gleichen Zeitpunkt. Gleichzeitige Änderungen oder Löschungen können zum Abbruch oder zu einem Bestand aus unterschiedlichen Zeitpunkten führen. Ein ruhiges Wartungsfenster und ein zusätzlicher Abgleich der Versionsliste verbessern die Nachvollziehbarkeit. Der Abschlusszeitpunkt im Manifest ist kein Veröffentlichungsdatum.
Kann eine vorhandene Datei dauerhaft als aktuell gelten?
Die Datei dokumentiert die Antwort zu einem bestimmten Abrufzeitpunkt. Versionsmetadaten können sich ändern; die API bietet beispielsweise eine Aktualisierung von Versionen. Ein Archiv sollte deshalb seine Herkunft und den Erfassungszeitpunkt behalten. Ein bloßer Dateiname belegt weder eine gültige Antwort noch einen vollständigen oder aktuellen Bestand.
Warum werden fehlende Dateien und fehlende Fingerprints nicht übersprungen?
Ein stilles Überspringen könnte aus einem unvollständigen Archiv eine scheinbar unveränderte Historie machen. Der Abbruch trennt einen technischen Fehler vom tatsächlichen Fehlen des gesuchten Tags. Die Prüfung validiert Identität und die für den Vergleich benötigte Struktur, nicht sämtliche möglichen GTM-Felder.
Beweist der gleiche Fingerprint identisches Verhalten?
Nein. Der Vergleich betrifft den gespeicherten Tag. Abhängigkeiten, Website-Code, Einwilligungszustand, Daten und nachgeladene Laufzeitsoftware können das Verhalten beeinflussen. Ein Fingerprint ersetzt weder die Prüfung dieser Einflüsse noch einen Funktionstest.
Quellen und weiterführende Dokumentation
- Veröffentlichung, Versionen und Freigaben
- version_headers.list
- ContainerVersionHeader
- versions.get
- ContainerVersion
- Tag
- API-Grenzen und Kontingente
- API-Zugriffsberechtigung
- versions.update
- GTM-Versionshinweise
- Containeroptimierung
- Vereinheitlichte Google-Tag-Konfiguration
- Unterstützte Google-Tag-Installation
- GTM-Initialisierung
- GTM Web
Passend dazu


