

 English
 Deutsch
 Polski
Warum eine Website bei Google fehlt: Canonical, Sprachverweise und noindex prüfen

Management Summary
Suchmaschinen brauchen Hinweise zur bevorzugten Seitenadresse, zu Sprachfassungen und zu Seiten, die nicht in Ergebnissen erscheinen sollen. Websites drücken diese Entscheidungen mit Canonical, hreflang und noindex aus. Widersprüchliche Angaben können erklären, warum eine Seite bei Google verschwindet oder unter einer anderen Adresse erscheint. Der Beitrag trennt die Aufgaben dieser Hinweise: Den Abruf einer Seite zu erlauben ist etwas anderes als die Aufnahme in Suchergebnisse zu wünschen.
Inhalt
Eine veröffentlichte Seite erscheint nicht automatisch in Suchergebnissen. Abrufbarkeit, Indexierungsanweisungen, doppelte Inhalte und Sprachzuordnung spielen unterschiedliche Rollen. Die folgenden Beispiele beziehen sich auf Google Search; andere Suchmaschinen können Signale anders auswerten.
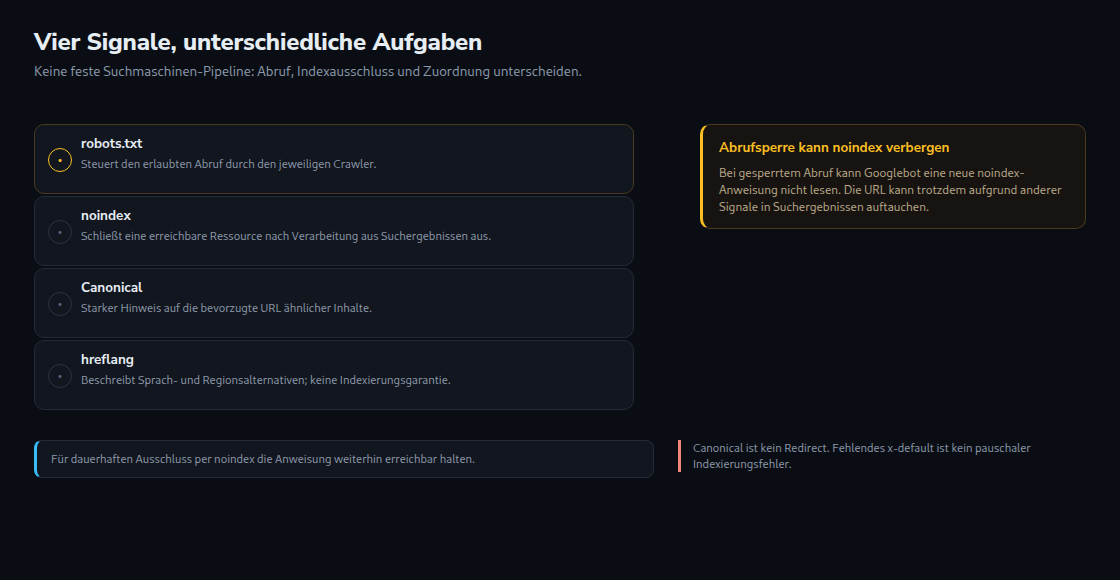
robots.txt steuert den Abruf, noindex den Ausschluss aus Suchergebnissen, Canonical die bevorzugte URL ähnlicher Inhalte und hreflang die Sprach- oder Regionsalternativen. Das ist keine starre vierstufige Verarbeitungskette. Fehlendes hreflang verhindert beispielsweise nicht grundsätzlich die Indexierung.
Canonical ist ein Hinweis, keine Weiterleitung
Mehrere URLs können denselben oder sehr ähnlichen Inhalt liefern, etwa ein Produkt mit und ohne Trackingparameter. Ein rel="canonical" zur bevorzugten Produktadresse kann dann genau richtig sein. Eine von der aktuellen Adresse abweichende Canonical-URL ist deshalb nicht automatisch ein Fehler.
Google behandelt die Angabe als starkes Signal und berücksichtigt weitere Hinweise. Erst die tatsächlich gewählte kanonische URL bestimmt die Zusammenfassung entsprechender Signale. Ein Canonical verschiebt nicht garantiert jede Bewertung und leitet den Browser nicht um.
Problematisch sind unbeabsichtigte Ziele, etwa ein stehen gebliebenes Testsystem oder eine völlig andere Seite. Canonical-Angaben, interne Links, Weiterleitungen und Sitemap sollten die beabsichtigte URL konsistent unterstützen. Google unterstützt relative Canonical-Adressen wie /produkt, empfiehlt aber vollständige URLs wie https://example.com/produkt. Bei der vollständigen Adresse bleibt eindeutig, welcher Host und Pfad gemeint sind.
noindex muss weiterhin abrufbar bleiben
Eine crawlbare HTML-Seite kann <meta name="robots" content="noindex"> im Head enthalten. Für PDF-Dateien und andere Ressourcen eignet sich X-Robots-Tag: noindex im Antwortheader. Eine robots.txt-Sperre verhindert, dass Googlebot eine neu gesetzte Anweisung dort liest.
Eine gesperrte URL kann trotzdem anhand externer Links in Suchergebnissen auftauchen. Für einen dauerhaften Ausschluss per noindex sollte die Anweisung erreichbar bleiben. Nach erfolgreicher Entfernung zusätzlich den Abruf zu sperren, ist daher keine verlässliche Fortsetzung dieses Verfahrens.
Änderungen wirken erst nach erneuter Verarbeitung; ein bestimmter Termin ist nicht garantiert. Vertrauliche Inhalte benötigen eine Zugangskontrolle. Weder robots.txt noch noindex ersetzt Anmeldung oder Berechtigungen.
hreflang beschreibt Alternativen, keine Zugangssperre
hreflang unterstützt die Auswahl passender Sprach- und Regionsfassungen. Ein Sprachcode wie pl bedeutet Polnisch, nicht pauschal jeden Besuch aus Polen. Die Angabe erzwingt weder eine Weiterleitung noch einen bestimmten Suchtreffer.
Bei HTML-Linkangaben sollte jede Fassung sich selbst und die zugehörigen Alternativen mit vollständigen URLs nennen. Gegenseitige Rückverweise sind nötig: Verweist Deutsch auf Englisch, muss Englisch zurück auf Deutsch verweisen. Fehler an einer Verbindung bedeuten jedoch nicht zwingend, dass alle übrigen gültigen Verbindungen der Gruppe verworfen werden.
x-default ist eine empfohlene Rückfallangabe für nicht passende Sprach- und Regionseinstellungen, beispielsweise eine Sprachauswahl. Das Fehlen allein macht eine Gruppe nicht ungültig. hreflang kann außerdem in HTTP-Link-Headern oder einer Sitemap stehen; eine reine HTML-Prüfung findet diese Angaben nicht vollständig.
Übersetzungen und Canonical zusammen prüfen
Vollständig übersetzte Hauptinhalte sind nicht allein aufgrund desselben Themas Dubletten. Für eigenständige deutsche, englische und polnische Fassungen ist jeweils eine passende kanonische URL derselben Sprache sinnvoll. Bei mehreren gleichsprachigen Dubletten kann diese URL von der gerade geprüften Adresse abweichen.
Die hreflang-Verweise sollten auf die vorgesehenen kanonischen Fassungen zeigen. Alle Übersetzungen pauschal auf Englisch zu kanonisieren, erzeugt widersprüchliche Signale und kann die gewünschte Sprachzuordnung beeinträchtigen. Eine automatische vollständige Übertragung aller Rankings lässt sich daraus nicht ableiten.
robots.txt: passende Gruppen und Regeln ermitteln
Für Google zählt die am spezifischsten passende User-Agent-Gruppe. Mehrere gleich spezifische Gruppen werden zusammengeführt. Die allgemeine Gruppe für * ergänzt eine passende spezifische Gruppe nicht automatisch.
Beispiel: Unter User-agent: * ist /intern/ gesperrt. Eine separate Googlebot-Gruppe enthält ausschließlich eine Regel für /test/. Dann übernimmt Googlebot die allgemeine Sperre für /intern/ nicht. Innerhalb der gewählten Regeln zählen Pfadübereinstimmung und Spezifität; bei gleichwertigem Konflikt hat Allow Vorrang.
Eine robots.txt gilt für den jeweiligen Host, das Protokoll und den Port. Die Datei einer Hauptdomain steuert deshalb nicht automatisch alle Subdomains. Eine Sperre schützt keine vertraulichen Dateien vor direktem Zugriff.
Was der Prüfer leisten kann
Der Indexierungs-Prüfer liefert eine erste Momentaufnahme. Die aktuelle Implementierung erfasst jedoch nicht alle gültigen Varianten: unter anderem fehlen Canonical-Link-Header, bestimmte crawlerbezogene Robots-Anweisungen und die korrekte Zusammenführung wiederholter robots.txt-Gruppen. Ein grünes Ergebnis beweist deshalb keine vollständige Indexierbarkeit.
Zur Diagnose gehören zusätzlich Statuscodes, Redirect-Kette, gerenderte Seite, alternative Sprachfassungen und gegebenenfalls Sitemap-Angaben. Die URL-Prüfung in Search Console zeigt Googles gespeicherten Stand und die ausgewählte kanonische URL. Ein Live-Test ersetzt diesen Indexstand nicht; selbst eine technisch zugängliche Seite hat keine Indexierungsgarantie.
Fragen und Antworten
Ist eine fehlende Selbstreferenz im Canonical immer ein Ausschlussgrund?
Nein. Eine Selbstreferenz ist auf der vorgesehenen kanonischen Seite empfehlenswert. Google kann auch ohne ausdrückliche Canonical-Angabe eine bevorzugte URL bestimmen. Entscheidend sind Inhalt und Gesamtheit der Signale.
Warum fehlen Rückverweise trotz korrekter Linkangabe?
Eine einzelne Antwort zeigt nur die Verweise dieser Seite. Die Zielseiten und das verwendete Verfahren müssen ebenfalls geprüft werden. Ein fehlender HTML-Verweis allein schließt eine korrekte Umsetzung über HTTP-Header oder Sitemap nicht aus.
Passend dazu


