

 English
 Deutsch
 Polski
Dlaczego witryny brakuje w Google: kontrola canonical, wersji językowych i noindex

Management Summary
Wyszukiwarki potrzebują wskazówek o głównym adresie treści, innych wersjach językowych i stronach, które nie powinny pojawiać się w wynikach. Witryny zapisują te wybory przez canonical, hreflang i noindex. Sprzeczne sygnały mogą wyjaśniać zniknięcie strony z Google lub obecność pod innym adresem. Artykuł rozdziela role tych ustawień: umożliwienie wyszukiwarce odczytu strony jest czymś innym niż prośba o uwzględnienie jej w wynikach wyszukiwania.
Spis treści
Opublikowana strona nie pojawia się automatycznie w wynikach wyszukiwania. Dostęp dla robota, instrukcje indeksowania, duplikaty treści i wersje językowe mają różne znaczenie. Poniższe przykłady dotyczą Google Search; inne wyszukiwarki mogą inaczej interpretować sygnały.
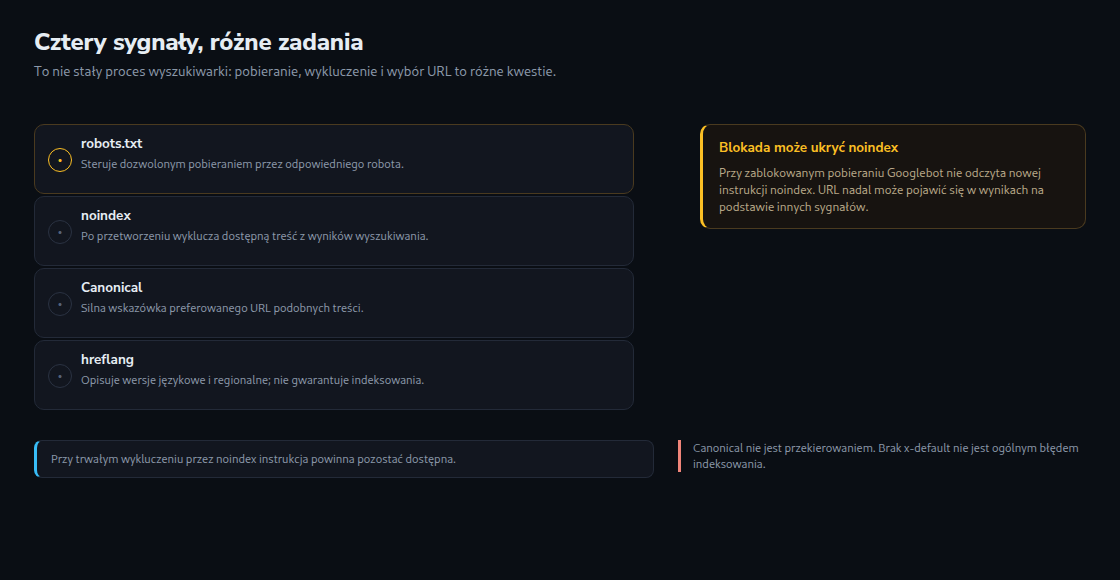
robots.txt steruje pobieraniem, noindex wyklucza treść z wyników, canonical wskazuje preferowany URL podobnych treści, a hreflang określa alternatywne wersje językowe lub regionalne. Nie jest to sztywny proces czterech kolejnych etapów. Brak hreflang na przykład zasadniczo nie uniemożliwia indeksowania.
Canonical to wskazówka, nie przekierowanie
Kilka adresów URL może udostępniać identyczną lub bardzo podobną treść, na przykład produkt z parametrami śledzenia i bez parametrów. rel="canonical" wskazujący preferowany adres produktu może być poprawny. Adres kanoniczny różny od bieżącego nie oznacza więc automatycznie błędu.
Google traktuje oznaczenie jako silny sygnał obok innych informacji. Łączenie sygnałów zależy od faktycznie wybranego adresu kanonicznego. Canonical nie gwarantuje przekazania każdej wartości rankingowej i nie przekierowuje przeglądarki.
Problemem są niezamierzone cele, na przykład pozostawiony adres testowy albo zupełnie inna strona. Canonical, odnośniki wewnętrzne, przekierowania i mapa witryny powinny spójnie wspierać zamierzony URL. Google obsługuje względne adresy canonical, takie jak /produkt, ale zaleca pełne adresy, na przykład https://example.com/produkt. Pełny adres jednoznacznie wskazuje host i ścieżkę.
noindex musi pozostać dostępne
Dostępna dla robota strona HTML może zawierać <meta name="robots" content="noindex"> w sekcji head. Dla PDF i innych zasobów odpowiedni jest nagłówek odpowiedzi X-Robots-Tag: noindex. Blokada robots.txt uniemożliwia Googlebotowi odczyt nowej instrukcji w tej odpowiedzi.
Zablokowany URL nadal może pojawić się w wynikach na podstawie zewnętrznych odnośników. Przy trwałym wykluczeniu przez noindex instrukcja powinna pozostać dostępna. Zablokowanie pobierania po skutecznym usunięciu nie jest więc niezawodną kontynuacją tej metody.
Zmiany działają po ponownym przetworzeniu, bez gwarancji konkretnego terminu. Treści poufne wymagają kontroli dostępu. Ani robots.txt, ani noindex nie zastępuje logowania i uprawnień.
hreflang opisuje alternatywy, nie ogranicza dostępu
hreflang pomaga wybrać odpowiednią wersję językową lub regionalną. Kod pl oznacza język polski, a nie każdą wizytę z Polski. Oznaczenie nie wymusza przekierowania ani konkretnego wyniku wyszukiwania.
Przy odnośnikach HTML każda wersja powinna wymieniać własny adres oraz powiązane alternatywy za pomocą pełnych URL. Potrzebne są odesłania zwrotne: odnośnik z niemieckiej wersji do angielskiej wymaga odpowiednika z angielskiej do niemieckiej. Błąd jednego połączenia nie musi unieważniać wszystkich pozostałych poprawnych połączeń grupy.
x-default to zalecany wariant awaryjny dla niedopasowanych ustawień języka i regionu, na przykład strona wyboru języka. Sam brak tej wartości nie unieważnia grupy. hreflang może też występować w nagłówkach HTTP Link lub mapie witryny; kontrola samego HTML nie wykrywa w pełni tych oznaczeń.
Tłumaczenia i canonical wymagają wspólnej kontroli
W pełni przetłumaczona główna treść nie jest duplikatem tylko dlatego, że dotyczy tego samego tematu. Osobne wersje niemiecka, angielska i polska powinny mieć odpowiednie adresy kanoniczne w tym samym języku. Przy kilku duplikatach w jednym języku taki adres może różnić się od właśnie sprawdzanego.
Odnośniki hreflang powinny wskazywać zamierzone wersje kanoniczne. Kierowanie canonical wszystkich tłumaczeń do wersji angielskiej tworzy sprzeczne sygnały i może utrudniać właściwy wybór języka. Nie wynika z tego automatyczne przekazanie wszystkich pozycji rankingowych.
robots.txt: właściwe grupy i reguły
Google wybiera najbardziej szczegółową pasującą grupę User-Agent. Grupy o tej samej szczegółowości są łączone. Ogólna grupa * nie uzupełnia automatycznie pasującej grupy szczegółowej.
Przykład: User-agent: * blokuje /wewnetrzne/. Osobna grupa Googlebot zawiera wyłącznie regułę dla /test/. Googlebot nie dziedziczy wtedy ogólnej blokady /wewnetrzne/. W wybranych regułach znaczenie mają dopasowanie ścieżki i szczegółowość; przy równoważnym konflikcie pierwszeństwo ma Allow.
Plik robots.txt dotyczy konkretnego hosta, protokołu i portu. Plik głównej domeny nie steruje automatycznie wszystkimi subdomenami. Blokada nie chroni poufnych plików przed bezpośrednim dostępem.
Co może ustalić inspektor?
Inspektor indeksowania przedstawia wstępny obraz sytuacji. Obecna implementacja nie obejmuje jednak wszystkich poprawnych form: brakuje między innymi nagłówków Link z canonical, części instrukcji robots dla konkretnych robotów oraz poprawnego łączenia powtarzanych grup robots.txt. Zielony wynik nie dowodzi więc pełnej możliwości indeksowania.
Diagnoza wymaga także kodów statusu, łańcucha przekierowań, wyrenderowanej strony, alternatywnych wersji językowych i ewentualnych oznaczeń w mapie witryny. Inspekcja URL w Search Console pokazuje zapisany stan Google oraz wybrany adres kanoniczny. Test na żywo nie zastępuje stanu indeksu; nawet technicznie dostępna strona nie ma gwarancji indeksowania.
Pytania i odpowiedzi
Czy brak canonical do własnego adresu zawsze wyklucza stronę?
Nie. Odesłanie do własnego adresu jest zalecane na zamierzonej stronie kanonicznej. Google może też wybrać preferowany URL bez jawnego canonical. Liczy się treść i łączny zestaw sygnałów.
Dlaczego brakuje odesłań zwrotnych mimo poprawnego oznaczenia?
Pojedyncza odpowiedź pokazuje tylko odnośniki danej strony. Sprawdzenia wymagają również strony docelowe i wybrana metoda wdrożenia. Sam brak oznaczenia HTML nie wyklucza poprawnej implementacji przez nagłówki HTTP lub mapę witryny.
Powiązane artykuły


