

 English
 Deutsch
 Polski
Sprawdzanie danych JSON przed wysyłką: błędy składni i nieprawidłowe wartości

Management Summary
JSON to popularny sposób wymiany opisanych danych między programami, na przykład kwot zakupu i informacji o produktach wysyłanych do analityki. Ładnie sformatowana wiadomość może nadal zawierać błędne wartości lub tracić informacje podczas przetwarzania. Artykuł wyjaśnia różnicę między czytelnym zapisem a danymi zgodnymi z oczekiwaniami odbiorcy. Powtórzone nazwy pól i bardzo długie identyfikatory liczbowe pokazują, dlaczego treść wymaga kontroli przed powstaniem raportu biznesowego.
Przejdź do interaktywnego przykładu ↓
Spis treści
Dane JSON mogą mieć poprawną składnię, a mimo to przekazywać niewłaściwą wartość. Pomagają trzy osobne kontrole: parsowanie oryginalnego tekstu, wykrywanie problemów wymiany danych oraz sprawdzanie reguł aplikacji odbierającej. Samo formatowanie nie obejmuje w pełni żadnego z tych zadań.
Poniższe przykłady działają lokalnie. Walidator przyjmuje dokładnie jedną wartość JSON, odrzuca powtórzone nazwy w obiektach i zachowuje wartości dziesiętne bez pośredniej konwersji do binarnej liczby zmiennoprzecinkowej. Nie łączy się z menedżerem tagów ani usługą analityczną.
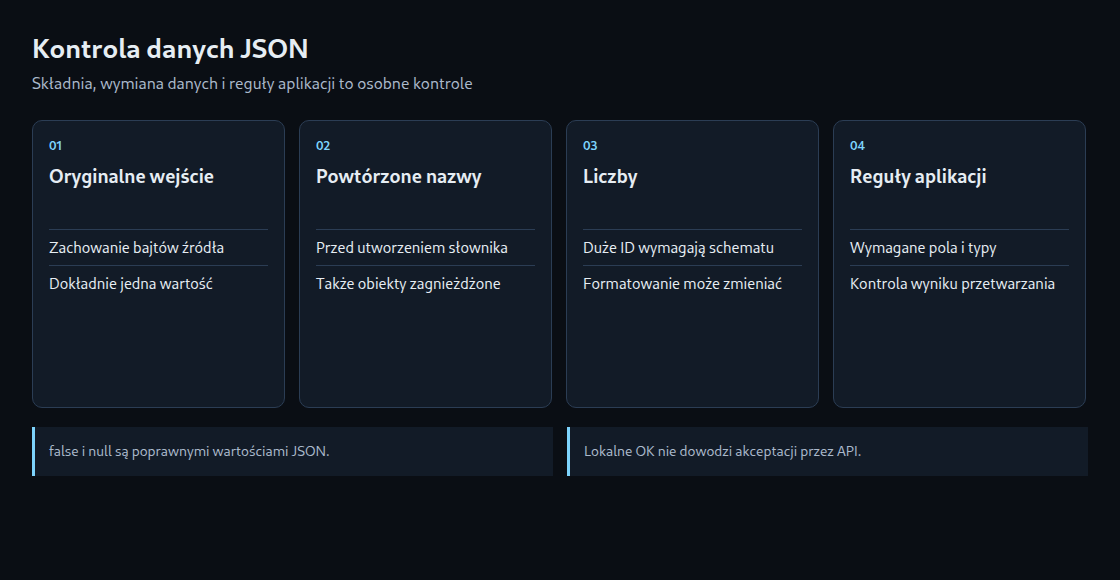
Punktem wyjścia jest rzeczywisty tekst JSON
JSON to format danych, a nie wykonywalny JavaScript. Nazwy w obiektach i ciągi znaków wymagają podwójnych cudzysłowów. Komentarze, końcowe przecinki, undefined, NaN oraz Infinity nie należą do gramatyki JSON. Kategorie wartości to obiekt, tablica, ciąg znaków, liczba, wartość logiczna i null. Dokument może również zawierać tylko pojedynczą wartość, na przykład false lub 42. Format dat i identyfikatorów wynika ze schematu aplikacji.
Apostrof wewnątrz ciągu ujętego w podwójne cudzysłowy jest poprawny. Surowy znak nowej linii wewnątrz ciągu nie jest poprawny; sekwencja \n reprezentuje nową linię. Parsery zwracają różne komunikaty, dlatego stała liczba błędów „głośnych” i „cichych” niewiele wyjaśnia.
Przed formatowaniem pozostaje zachowana oryginalna odpowiedź lub plik. Formater może odrzucić błędny JSON, usunąć powtórzone nazwy albo zmienić zapis liczb. Błąd na pozycji zero może wynikać ze znacznika kolejności bajtów, HTML zamiast JSON, pustego wejścia lub innego nieoczekiwanego pierwszego znaku. Sama pozycja nie potwierdza BOM.
Odrzucenie duplikatów przed utratą informacji
RFC 8259 zaleca unikalne nazwy w każdym obiekcie. Odbiorcy różnie obsługują duplikaty: często zachowują ostatnią wartość, ale możliwe jest także odrzucenie albo przekazanie wszystkich par. Po konwersji do zwykłego słownika odrzucona wartość może już być niedostępna.
Przykład {"a":{"x":1},"a":{"y":2}} powtarza nazwę a, choć ścieżki do końcowych wartości, a.x i a.y, są różne. Lista powtarzających się ścieżek liści ze strumienia nie wykrywa więc niezawodnie tego problemu. Ta sama nazwa w dwóch osobnych obiektach nie jest natomiast duplikatem w jednym obiekcie. Walidator używa object_pairs_hook Pythona przed utworzeniem każdego słownika, również dla obiektów zagnieżdżonych i nazw zapisanych sekwencjami ucieczki.
Identyfikatory zgodne ze schematem odbiorcy
JavaScript Number korzysta z binarnego zapisu zmiennoprzecinkowego. Każda liczba całkowita w domkniętym przedziale od −(2^53−1) do 2^53−1 jest bezpieczna. Poza nim niektóre liczby całkowite nadal dają się zapisać, ale nie wszystkie sąsiednie wartości pozostają rozróżnialne. Poniższy przykład Node.js pokazuje zmienioną ostatnią cyfrę.
const parsed = JSON.parse('{"id":9007199254740993}');
console.log(parsed.id); // 9007199254740992
console.log(Number.isSafeInteger(parsed.id)); // false
const exact = JSON.parse('{"id":"9007199254740993"}');
console.log(exact.id); // "9007199254740993" as a string
Ciąg znaków zachowuje ten identyfikator, jeśli API odbiorcy dopuszcza taki typ. Gdy API wymaga liczby, obowiązują udokumentowane zasady reprezentacji i limity. Bezwarunkowa zamiana każdego identyfikatora na tekst może unieważnić poprawne żądanie. Wyrażenie regularne liczące cyfry nie jest pełną kontrolą precyzji: może pomijać wartości ujemne i wykładniki oraz mylić ciągi cyfr z liczbami.
Lokalny walidator z jawnymi dodatkowymi regułami
Plik wymaga wyłącznie biblioteki standardowej Pythona. Po zapisaniu jako check_json.py uruchomienie ma postać python3 check_json.py payload.json. Kod wyjścia 0 oznacza przejście lokalnych kontroli, a 1 odrzucenie. Zawartość pliku nie jest wypisywana.
import json
import sys
from decimal import Decimal, InvalidOperation
from pathlib import Path

MAX_BYTES = 1_048_576  # Local example policy, not a JSON limit.

def unique_object(pairs):
    result = {}
    for key, value in pairs:
        if key in result:
            raise ValueError("duplicate object member")
        result[key] = value
    return result

def reject_constant(value):
    raise ValueError("non-JSON numeric constant")

def check(raw):
    if len(raw) > MAX_BYTES:
        raise ValueError("example size limit exceeded")
    # Strict UTF-8; this example also rejects a leading BOM.
    text = raw.decode("utf-8")
    if text.startswith("\ufeff"):
        raise ValueError("leading BOM rejected by local policy")
    value = json.loads(text, object_pairs_hook=unique_object,
                       parse_float=Decimal, parse_constant=reject_constant)
    # Reject lone UTF-16 surrogates for interoperable Unicode text.
    def visit(x):
        if isinstance(x, str):
            x.encode("utf-8")
        elif isinstance(x, dict):
            for key, item in x.items():
                visit(key)
                visit(item)
        elif isinstance(x, list):
            for item in x:
                visit(item)
    visit(value)
    return value

if __name__ == "__main__":
    if len(sys.argv) != 2:
        raise SystemExit("Usage: python3 check_json.py payload.json")
    try:
        with Path(sys.argv[1]).open("rb") as stream:
            raw = stream.read(MAX_BYTES + 1)
        check(raw)
    except json.JSONDecodeError as exc:
        print(f"Syntax error: line {exc.lineno}, column {exc.colno}",
              file=sys.stderr)
        raise SystemExit(1)
    except (OSError, ValueError, UnicodeError, RecursionError,
            InvalidOperation, OverflowError):
        print("Rejected: encoding, duplicate, value or resource policy",
              file=sys.stderr)
        raise SystemExit(1)
    print("OK: JSON plus the example's interoperability checks")
Limit jednego mebibajta, odrzucenie początkowego BOM i pojedynczych znaków surogatowych to jawne dodatkowe reguły wymiany danych oraz zużycia zasobów. Nie każde odrzucone przez nie wejście narusza gramatykę JSON. Parser ma również ograniczenia implementacyjne. Przykład nie jest kompletną ochroną przed złośliwym wejściem.
Domyślny dekoder Pythona akceptuje NaN i Infinity jako rozszerzenia; parse_constant wyłącza to zachowanie. Decimal zachowuje wejście dziesiętne do kontroli, a liczby całkowite pozostają liczbami całkowitymi Pythona. Żaden z tych wyborów nie dowodzi, że późniejszy odbiorca JavaScript lub zewnętrzne API reprezentuje tę samą wartość.
Odczyt diagnostyki z oryginału
Przy błędzie składni Python udostępnia numer linii i kolumny. Komunikaty JavaScript zależą od silnika i wersji; wyciąganie angielskiego słowa „position” nie stanowi przenośnego interfejsu. Pozycje znaków, jednostki UTF-16 i pozycje bajtów nie są zamienne. Tabulatory i nowe linie utrudniają także własne oznaczanie miejsca daszkiem.
Pomocna jest lokalna inspekcja otoczenia pierwotnej pozycji. Logi produkcyjne nie powinny wypisywać pełnych danych zawierających informacje osobowe lub dane dostępowe. Diagnostyka składni wskazuje miejsce przerwania parsowania; właściwa pomyłka może znajdować się wcześniej.
Co potwierdza jq
jq -e . nie jest czystym testem poprawności: poprawne wartości false i null dają niezerowy kod wyjścia. jq zwykle czyta również strumień wartości JSON, więc sukces nie potwierdza dokładnie jednego dokumentu. Puste wejście i rozszerzenia wymagają jawnych reguł. Powyższy walidator Pythona określa te reguły wprost.
Obsługa liczb zależy od wersji jq oraz opcji kompilacji. Zachowanie literału i konwersja podczas obliczeń to osobne kwestie. Ogólna gwarancja dla każdej kompilacji od wersji 1.7 jest błędna. Sformatowana kopia nie zastępuje oryginału przy analizie precyzji.
Następnie kontrola wymagań tagu lub API
Udana kontrola lokalna nie potwierdza wymaganych pól, nazw zdarzeń, waluty, dat ani reguł biznesowych. Wygenerowane dane wymagają również schematu i udokumentowanych narzędzi diagnostycznych platformy odbierającej. Potrzebna jest także obserwacja odpowiedzi i wyników przetwarzania. Sam status HTTP nie zawsze dowodzi poprawnych danych na kolejnych etapach.
Przy JSON-LD kontrola dotyczy wyrenderowanej strony i odpowiedniego typu danych strukturalnych. Jeden uszkodzony blok nie dowodzi nieczytelności wszystkich pozostałych. Poprawna składnia nie gwarantuje wyników rozszerzonych. W szablonach tagów walidacja importu i zachowanie podczas działania są osobnymi kontrolami; moment błędu zależy od formatu i platformy.
Pytania i odpowiedzi
Jak JSON.parse w przeglądarce traktuje powtórzone nazwy?
Nie zgłasza błędu i zachowuje ostatnią wartość. Z {"a":1,"a":2} powstaje obiekt z a = 2, a nic w wyniku nie wskazuje, że istniała pierwsza wartość. Tag odczytujący dane w przeglądarce nigdy więc nie zobaczy duplikatu, dlatego warto sprawdzać oryginalny tekst przed parsowaniem.
Które wartości JSON.stringify zmienia po cichu podczas tworzenia danych JSON?
Kilka, ale tylko w jednym przypadku pojawia się błąd. Kod składający dane w JavaScripcie, na przykład w zmiennej niestandardowej, może natrafić na takie przypadki:
NaN,Infinityi-Infinitystają się wartościąnull. Nieudana konwersja dociera więc jako poprawny JSON.- Właściwości, których wartością jest
undefined, funkcja lub symbol, znikają z obiektów, a w tablicach zamieniają się wnull. Wymagane pole może przez to zniknąć bez żadnego komunikatu. - Obiekt
Datestaje się ciągiem znaków w formacie ISO w UTC. Jeśli odbiorca oczekuje innego formatu daty lub czasu lokalnego, wartość nie pasuje. MapiSetstają się pustymi obiektami.BigIntwywołuje TypeError. To jedyny głośny przypadek.
Walidator z artykułu wykrywa z tego tylko to, co pozostaje widoczne w tekście. Brakujące pole albo null w niewłaściwym miejscu wychodzi na jaw dopiero przy porównaniu ze schematem odbiorcy.
Dlaczego walidator odczytuje liczby dziesiętne jako Decimal, a nie jako float?
Ponieważ float zamienia każdą liczbę dziesiętną na wartość binarną, a wiele ułamków dziesiętnych jest przy tym tylko przybliżanych. Zapisana jako float kwota 19,99 staje się wartością nieco mniejszą, która przy wypisaniu zwykle znów wygląda jak 19.99, ale w obliczeniach się różni; znanym przykładem jest 0.1 + 0.2, co daje 0.30000000000000004. Od 16 cyfr znaczących wartość binarna nie odtwarza już niezawodnie literału; identyfikator 9007199254740993 z artykułu pokazuje to w JavaScripcie.
Decimal zachowuje literał w zapisanej postaci. Pozwala to sprawdzać reguły na zapisanej wartości, na przykład najwyżej dwa miejsca po przecinku w kwocie; Decimal("19.990") ma trzy, choć opisuje tę samą wartość liczbową. Czy późniejszy odbiorca zachowa tę samą precyzję, pozostaje przy tym otwarte, na co zwraca uwagę artykuł.
Czy zbyt duży identyfikator da się jeszcze uratować po JSON.parse?
Nie z przetworzonego obiektu. Liczba jest w nim już zaokrąglona do najbliższej wartości, którą da się zapisać: z 9007199254740993 zrobiło się 9007199254740992, a żadna późniejsza konwersja nie zna pierwotnej cyfry. Wartość przetrwa tylko wtedy, gdy zostanie odczytana z oryginalnego tekstu przed parsowaniem albo gdy źródło od początku dostarczy ją jako ciąg znaków.
Źródła
Zrozum przez eksperyment
Jedna minuta: znajdziesz błąd?
Dlaczego ten JSON jest niepoprawny?
{"event":"page_view","value":42,}JSON nie dopuszcza końcowego przecinka. Usuń go. Poprawna składnia nie oznacza, że aplikacja oczekuje tych pól.
Jeden problem, konkretna droga do rozwiązania
Mój JSON sprawia problemy
- Zrozum: Sprawdź dane JSON
- Wypróbuj: Formatuj JSON
- Zacznij od małego przykładu i znajdź błędy składni. Następnie sprawdź, czy wartości i typy pasują do aplikacji – sama poprawna składnia tego nie gwarantuje.
Powiązane artykuły


