English
 Deutsch
Wie oft Crawler die robots.txt wirklich lesen: zwischen null und 44 Mal am Tag

Inhalt
Eine Zeile in der robots.txt ist kein Schalter. Die Datei muss erst wieder geholt werden, bevor sich etwas ändert – und bis dahin gelten die alten Regeln weiter.
Wie lange dieses „bis dahin” dauert, wurde an einem Server über vierzehn Tage gemessen, für jeden Crawler, der sich zu erkennen gab. Die Antwort reicht von sieben Minuten bis nie.
Warum die Lesehäufigkeit über die Wirkung entscheidet
Ein Crawler liest die robots.txt nicht vor jeder Anfrage; das verdoppelte den Verkehr auf beiden Seiten. Er holt die Datei, behält die Antwort und arbeitet eine Weile aus dieser Kopie.
Wie lang diese Weile ist, entscheidet der Crawler selbst. Eine Gewohnheit von etwa einem Tag ist weit verbreitet, und erzwungen wird sie von nichts.
Eine neue Regel hat damit zwei getrennte Anfänge. Auf dem Server gilt sie in dem Augenblick, in dem die Datei gespeichert wird. Für einen bestimmten Crawler gilt sie erst nach dessen nächstem Abruf. Zwischen diesen beiden Zeitpunkten verhält er sich genau wie vorher, und nichts auf dem Server kann ihm etwas anderes mitteilen.
Was gemessen wurde
Vierzehn aufeinanderfolgende Tage Zugriffsprotokoll, vom 22. August bis zum 4. September 2026, von einem kleinen Server, über beide Hostnamen, unter denen er antwortet.
Gezählt je Crawler-Kennung: jede Anfrage, und getrennt davon jede Anfrage nach robots.txt. Zwölf Kennungen tauchten im Zeitraum auf.
Bei der Auswertung ist ein Detail wichtig: Das Protokoll setzt für jeden Hostnamen ein anderes Präfix an den Zeilenanfang. Ein erster Durchgang erfasste nur eines dieser Präfixe und erzeugte eine scheinbar korrekte Tabelle, laut der mehrere Crawler die Regeln nie abgerufen hatten. Die Zahlen unten stammen aus einem Durchgang, der beide Präfixe berücksichtigt.
Von null bis vierundvierzig Mal am Tag
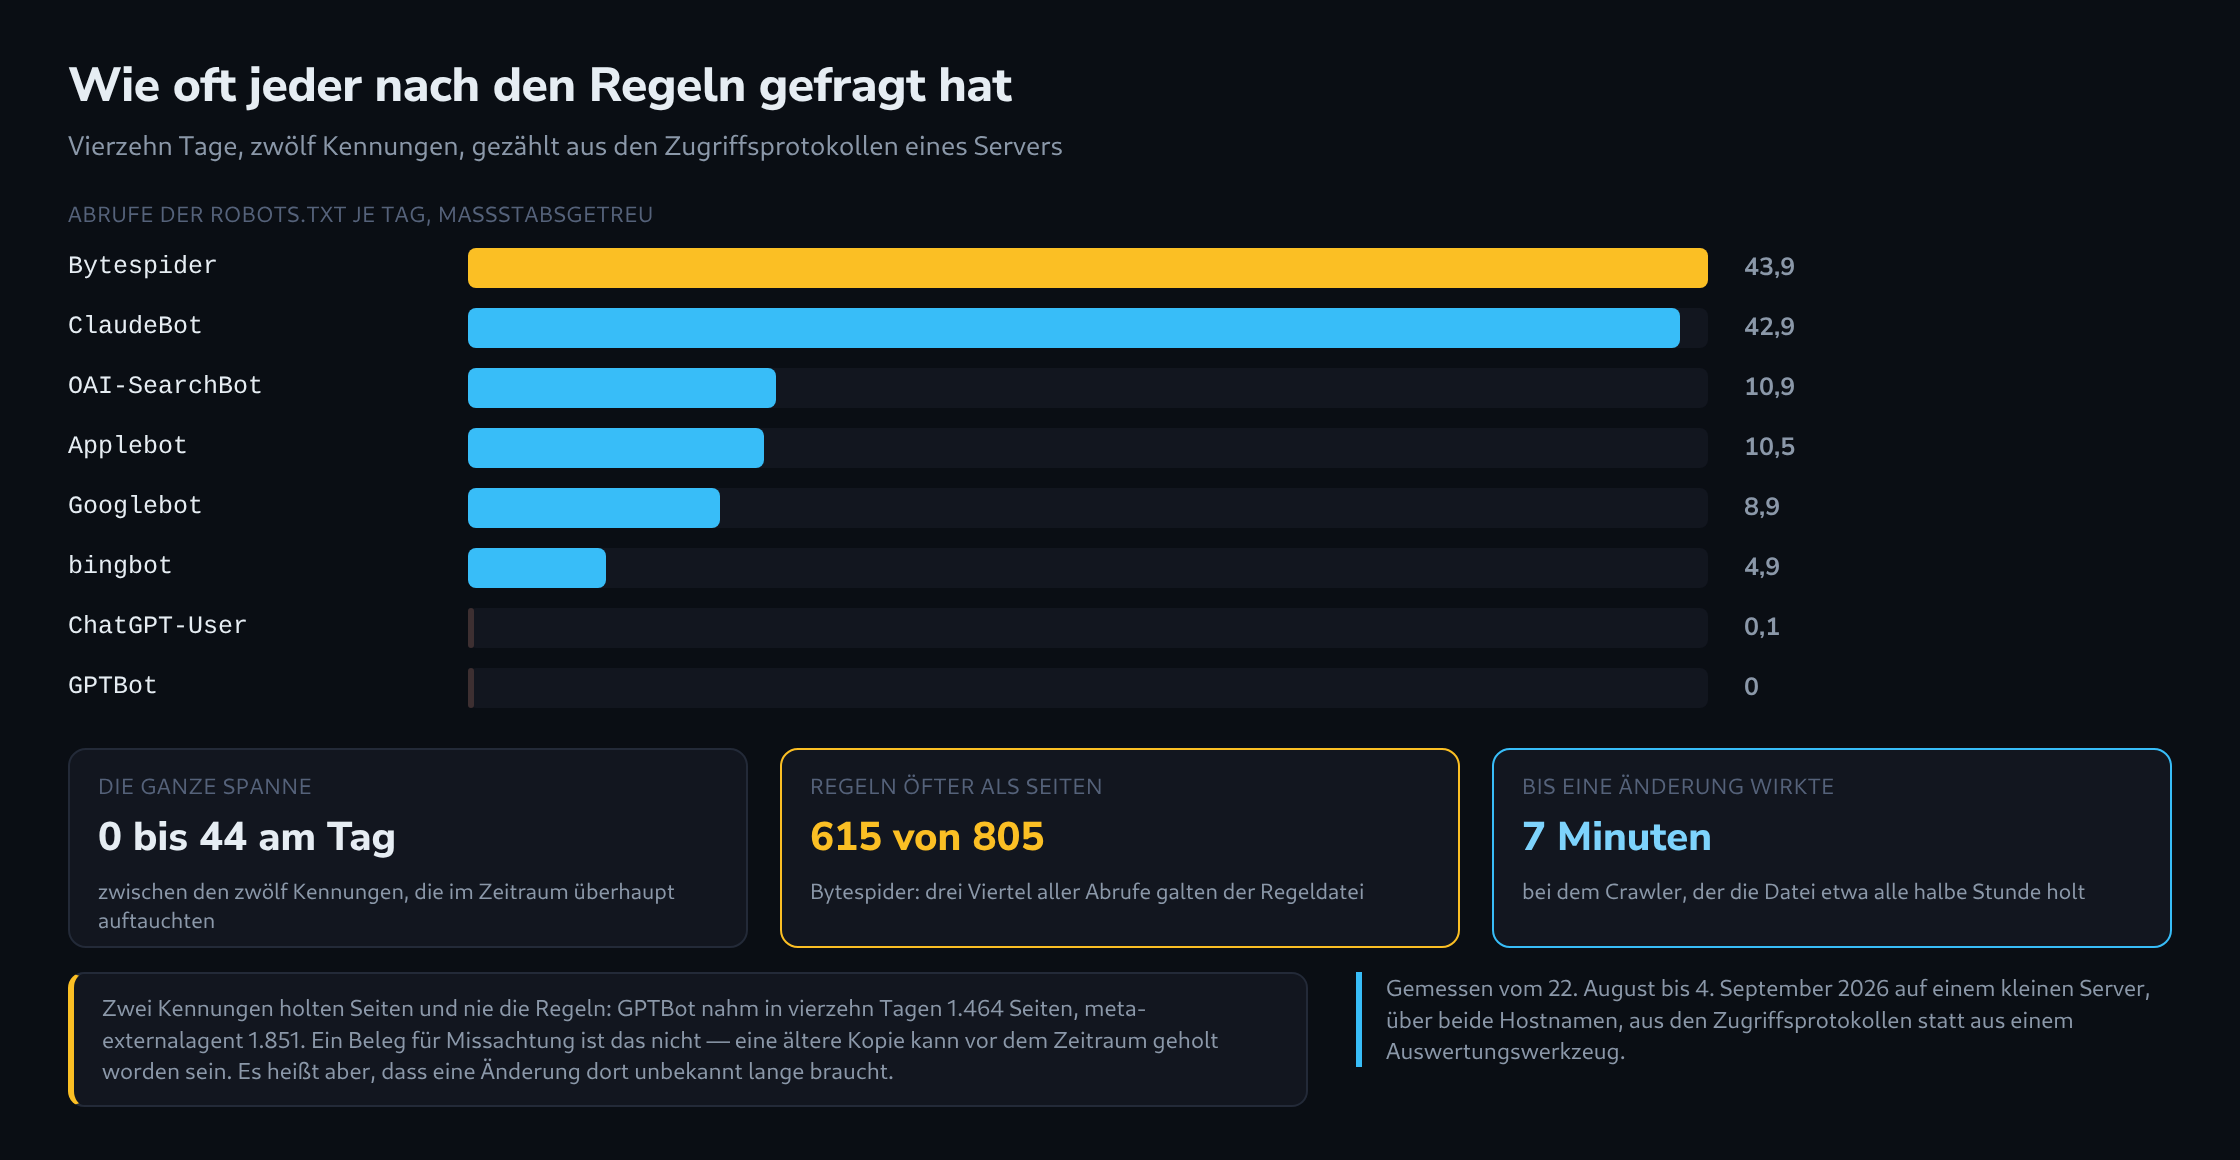
Bytespider holte die Datei 43,9 Mal am Tag. ClaudeBot 42,9 – also etwa alle vierunddreißig Minuten.
Dann ein weiter Abstand. OAI-SearchBot 10,9, Applebot 10,5, Googlebot 8,9, bingbot 4,9.
Danach ein langer Rest: CCBot 3,0, PerplexityBot 1,9, Amazonbot 0,6, ChatGPT-User 0,1.
Und zwei, die sie in vierzehn Tagen kein einziges Mal geholt haben.
Auf die Rangfolge kommt es nicht an. Es kommt darauf an, dass eine einzige Änderung an einer einzigen Datei den Anfang dieser Liste binnen einer Stunde erreicht und das Ende in einem Zeitraum, den auf dem Server niemand benennen kann.
Einer liest die Regeln öfter als die Seiten
Bytespider fällt heraus. Von 805 Anfragen in vierzehn Tagen galten 615 der robots.txt – drei Viertel von allem, wonach gefragt wurde.
Übrig bleiben 190 wirkliche Seiten in zwei Wochen, gegenüber 615 Nachfragen, ob das Holen erlaubt sei. Was auch immer dahintersteckt, die praktische Folge ist ungewöhnlich: Eine Regel für diesen Crawler wirkt fast sofort, weil er fast ununterbrochen nachfragt.
OAI-SearchBot zeigt eine mildere Fassung derselben Form: 152 von 477 Anfragen, knapp ein Drittel.
Zwei haben sie überhaupt nicht geholt
GPTBot forderte im Zeitraum 1.464 Seiten an und die Regeldatei null Mal. meta-externalagent forderte 1.851 Seiten an und die Regeldatei null Mal.
Das gehört vorsichtig gesagt. Ein Beleg dafür, dass etwas missachtet wurde, ist es nicht: Eine vor dem Zeitraum geholte Kopie gälte weiterhin, und vierzehn Tage sind nicht ewig. Die Messung sagt nur, was sie sagt – in diesem Fenster, auf diesem Server, haben diese beiden nie gefragt.
Was daraus folgt, betrifft allein den Zeitpunkt. Eine Regel, die für einen der beiden geschrieben wird, hat keinen benennbaren Augenblick, ab dem sie greift. Vielleicht greift sie seit Wochen, vielleicht erst nächsten Monat.
Was das für eine Änderung bedeutet
Drei Dinge, nach Gewicht geordnet.
Eine Änderung an der robots.txt ist kein Vorgang mit bekanntem Ende. Das Eintreffen verteilt sich über alle Crawler nach deren eigenen Gewohnheiten, und die hier gemessene Spanne umfasst drei Größenordnungen.
Wo eine Änderung dringend ist – ein Crawler nimmt zu viel Verkehr -, entscheidet die Häufigkeit, ob die robots.txt überhaupt das richtige Werkzeug ist. Gegen etwas, das sie jede halbe Stunde liest, ist sie ausgezeichnet: Eine solche Änderung wirkte auf diesem Server binnen sieben Minuten. Gegen etwas, das sie seit vierzehn Tagen nicht gelesen hat, bleibt eine Sperre auf dem Server das einzige Mittel mit benennbarem Anfang.
Und die Häufigkeit lässt sich auf jedem Server messen, der Protokolle führt. Ein Durchgang darüber beantwortet eine Frage, die kein fremdes Werkzeug beantworten kann: nicht, ob ein Crawler die Regeln befolgt, sondern wann er überhaupt bemerken würde, dass sie sich geändert haben.
Fragen und Antworten
Lässt sich ein Crawler dazu bringen, die robots.txt früher neu zu lesen?
Nur begrenzt. RFC 9309 erlaubt einem Crawler, die Datei nach den üblichen HTTP-Cache-Regeln zwischenzuspeichern, und empfiehlt, eine Kopie nicht länger als 24 Stunden zu verwenden, solange die Datei erreichbar ist. Eine kurze Angabe in Cache-Control kann ein Crawler beachten, verpflichtet ist er dazu nicht. Die Messung zeigt, wie weit die Gewohnheiten auseinanderliegen: von mehr als 40 Abrufen am Tag bis zu keinem in vierzehn Tagen.
Für Googlebot bietet die Search Console einen Weg, einen erneuten Abruf der robots.txt anzufordern. Für die übrigen Crawler gibt es keinen solchen Schalter. Wo eine Änderung sofort wirken muss, bleibt deshalb nur die Sperre auf dem Server.
Was gilt, wenn die robots.txt beim Abruf mit einem Fehler antwortet?
Dann entscheidet der Statuscode, und die beiden Fehlerklassen weisen in entgegengesetzte Richtungen. RFC 9309 unterscheidet zwei Fälle:
- Ein Code von 400 bis 499 bedeutet, dass keine Regeln vorliegen. Der Crawler darf dann alles holen, auch Bereiche, die in der letzten Fassung gesperrt waren.
- Ein Serverfehler von 500 bis 599 oder eine gar nicht erreichbare Datei bedeutet das Gegenteil: Der Crawler soll von einer vollständigen Sperre ausgehen. Hält der Zustand lange an, etwa 30 Tage, darf er auf eine zwischengespeicherte Kopie zurückgreifen oder die Datei als nicht vorhanden behandeln.
Google behandelt nach eigener Dokumentation den Code 429 wie einen Serverfehler und nicht wie die übrigen 4xx-Codes.
Im Betrieb liegt die Gefahr deshalb weniger in der Datei als in dem, was vor ihr steht. Eine Firewall-Regel, eine Ratenbegrenzung oder eine Sammelregel für abgeschaltete Pfade, die auch /robots.txt erfasst, ändert die Regeln, ohne dass jemand die Datei angefasst hat. Ein 403 öffnet dem Crawler die ganze Seite, ein 503 schließt sie. Die robots.txt sollte deshalb von solchen Regeln ausgenommen sein und stets mit 200 antworten, mit 404 nur dann, wenn es bewusst keine Regeln gibt.
Nimmt eine Disallow-Regel eine Seite aus dem Suchindex?
Nein. Die robots.txt steuert das Holen, nicht die Aufnahme in den Index: Eine gesperrte Adresse kann weiter im Index stehen, etwa weil andere Seiten auf sie verweisen, dann nur ohne Inhalt. Wer eine Seite aus dem Index nehmen will, braucht noindex, und das kann der Crawler nur lesen, wenn er die Seite holen darf.
Passend dazu