

 English
 Deutsch
 Polski
WAN-Failover: Was mit offenen Verbindungen bei der Umschaltung passiert

Management Summary
Eine automatische Internetumschaltung wechselt bei Ausfall der Hauptleitung auf einen Ersatzanschluss. Das verbessert die Erreichbarkeit eines Heim- oder Firmennetzes, erhält aber nicht zwingend laufende Gespräche, Downloads oder andere Aufgaben. Mit einer neuen öffentlichen Adresse können bestehende Verbindungen abbrechen. Deshalb kann trotz schneller Routerumschaltung eine spürbare Arbeitspause bleiben. Die Wiederaufnahme hängt auch von der Anwendung ab. Eine Ersatzleitung verbessert die Verfügbarkeit, garantiert aber keinen unterbrechungsfreien Ablauf.
Inhalt
WAN-Failover schaltet bei einer Störung auf einen anderen Internetanschluss um. Ein wieder nutzbarer Weg bedeutet jedoch nicht automatisch, dass offene Verbindungen weiterlaufen. Entscheidend sind die nach außen sichtbaren Adressen, die Zustände im Router, das verwendete Protokoll und die Wiederaufnahme durch die Anwendung.
Der typische Fall in diesem Artikel: zwei unabhängige Anschlüsse mit unterschiedlichen öffentlichen IPv4-Adressen und NAT. NAT übersetzt lokale Adressen in die im Internet verwendete öffentliche Adresse. Der Router speichert dazu, welche interne Verbindung zu welcher externen Adresse und Portzuordnung gehört. Ein Wechsel mit stabiler externer Adresse oder über einen geeigneten Tunnel hat andere Voraussetzungen. Eine generelle Aussage wie „jede Sitzung endet bei der Umschaltung“ wäre deshalb falsch.
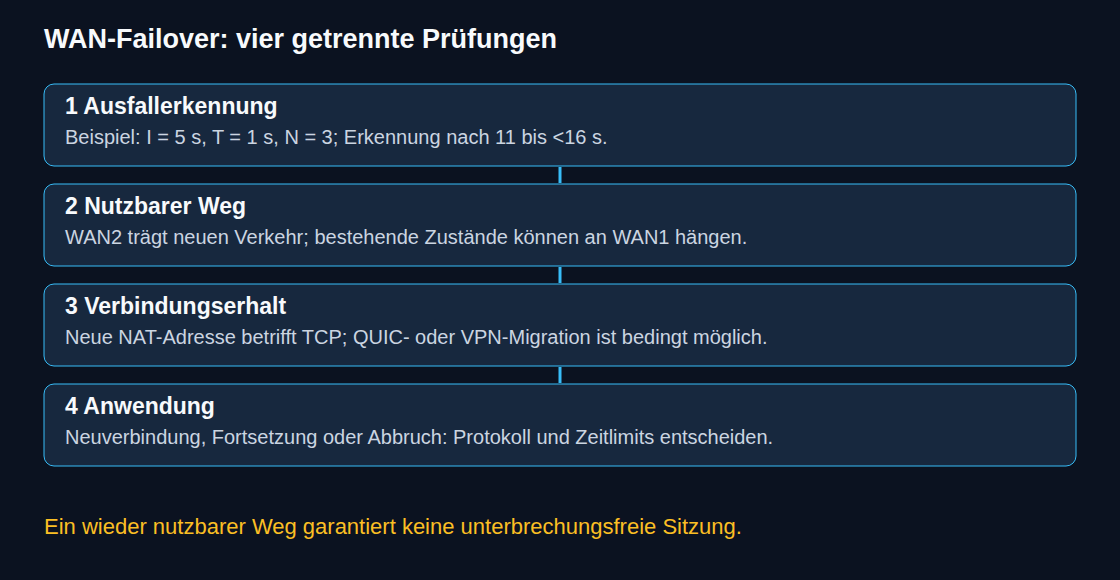
Warum ein Adresswechsel bestehendes TCP unterbricht
Eine gewöhnliche TCP-Verbindung ist durch Quell- und Zieladresse samt Ports bestimmt. Wird der Verkehr nach dem Wechsel auf eine andere öffentliche Quelladresse umgesetzt, gehört dieser Verkehr aus Sicht des Servers nicht mehr zur ursprünglichen Verbindung. Eine neue Route allein überträgt den TCP-Zustand nicht auf eine neue Adresse.
Der Fehler muss trotzdem nicht exakt im Umschaltmoment sichtbar werden. NAT-Zustände können zunächst an WAN1 gebunden bleiben; Anwendungen warten möglicherweise auf Wiederholungen oder brechen früher durch eigene Zeitlimits ab. Kehrt der ursprüngliche Weg rechtzeitig und mit erhaltenem Zustand zurück, kann eine Verbindung weiterlaufen. Beim normalen Wechsel auf eine andere Absenderadresse ist für SSH oder eine Datenbankverbindung dagegen meist eine Neuverbindung nötig.
Erkennungszeit, Umschaltung und Anwendung getrennt messen
Eine allgemeine Formel aus Intervall und Fehlerzahl reicht nicht für jeden Router. Ein einfaches Modell lässt sich aber sauber herleiten: Prüfungen starten im Abstand I, jeder erfolglose Versuch endet nach T, und genau N aufeinanderfolgende Fehlschläge lösen die Entscheidung aus. Dabei gilt T < I; der letzte Versuch vor dem Ausfall war erfolgreich. d ist die Wartezeit bis zum ersten Prüfstart nach dem Ausfall; D bezeichnet die Erkennungszeit.
I = 5 s, T = 1 s, N = 3
0 <= d < I
D = d + (N - 1) * I + T

11 s <= D < 16 s
Mittelwert D = 13,5 s  (gleichverteiltes d)
Der Mittelwert setzt voraus, dass ein Ausfall zu jedem Zeitpunkt zwischen zwei Prüfstarts gleich wahrscheinlich ist. Die Rechnung enthält weder die anschließende Routenänderung noch die Wiederaufnahme einer Anwendung. Eine anders definierte Fehlertoleranz, die Bewertung verlorener Pakete über einen laufend verschobenen Zeitraum, verzögerte Auswertung oder Prüfungen nach Abschluss des vorherigen Versuchs verändern das Modell. pfSense dokumentiert beispielsweise zusätzlich Verlustschwellen, Auswertungszeiträume und Alarmintervalle.
Welche Vorgänge weiterlaufen können
| Verkehr | Beim üblichen NAT-Adresswechsel |
|---|---|
| SSH, Datenbank über TCP | Bestehende Verbindung normalerweise nicht übertragbar; Neuverbindung und gegebenenfalls Anwendungswiederherstellung nötig. |
| HTTP/1.1- oder HTTP/2-Download | TCP-Verbindung betroffen. Fortsetzung kann mit Range-Unterstützung und Prüfung derselben Dateiversion gelingen; die Anwendung muss das umsetzen. |
| HTTP/3 über QUIC | Ein Pfadwechsel ist möglich, aber von Implementierung, Verbindungszustand, Pfadprüfung und Zeitlimits abhängig. |
| Telefonie und Videokonferenz | Medien können aussetzen. Ob das Gespräch endet oder einen neuen Medienpfad findet, hängt unter anderem von Signalisierung und ICE-Unterstützung ab. |
| DNS | Eine UDP-Anfrage kann verloren gehen und später wiederholt werden. DNS nutzt auch TCP und andere verbindungsorientierte Transporte; „überlebt immer“ trifft nicht zu. |
| VPN | Erhalt innerer Verbindungen ist unter passenden Bedingungen möglich; eine automatische Tunnel-Neuverbindung allein garantiert das nicht. |
QUIC kann Pakete über Connection IDs einer Verbindung zuordnen. Die neue Route muss dennoch funktionieren und geprüft werden. Aktive Migration ist erst nach bestätigtem Handshake möglich und kann eingeschränkt sein; ein durch NAT verursachter Adresswechsel ist davon gesondert zu betrachten. Die bloße Nutzung von HTTP/3 garantiert keine unterbrechungsfreie Anwendung.
Bei einem VPN müssen innere Adressen und relevante Zustände erhalten bleiben. Für Internetverkehr über einen entfernten VPN-Ausgang muss auch dessen externe Zuordnung stabil bleiben. WireGuard unterstützt Roaming, IKEv2 kann MOBIKE nutzen. Dauert die Unterbrechung länger als das Zeitlimit einer inneren Anwendung, hilft die stabile Adresse allein nicht.
Rückschaltung ohne unnötige zweite Unterbrechung
Die Rückkehr zu WAN1 muss bestehende Verbindungen über WAN2 nicht sofort verschieben. Ein Router kann neue Verbindungen wieder bevorzugt über WAN1 aufbauen und bestehende Zustände auf WAN2 auslaufen lassen. Erzwungenes Umleiten oder Löschen dieser Zustände kann dagegen erneut unterbrechen. Das konkrete Verhalten ist eine Konfigurationsfrage.
Eine Wartezeit vor der Rückkehr und getrennte Kriterien für Ausfall und Erholung begrenzen häufiges Hin- und Herschalten. Ein festes Verhältnis der Timer ist keine allgemeine Lösung. Maßgeblich sind die Stabilität der Leitung, die Anforderungen der Anwendungen und die gewählte Zustandsbehandlung.
Eine belastbare Prüfung der Ausfallsicherung
Prüfverkehr muss nachweislich über den jeweils überwachten Anschluss laufen. Ein erreichbares Modem beweist keine funktionierende Internetroute; ein einzelnes ausgefallenes Prüfziel beweist keinen Anschlussausfall. Mehrere geeignete Signale oder Ziele können die Beurteilung verbessern, soweit der Router das unterstützt. Bei pfSense sind unterschiedliche Monitor-IP-Adressen je Gateway vorgesehen.
Ein geplanter Test erfasst getrennt Ausfallzeitpunkt, Gateway-Entscheidung, erfolgreichen neuen Verbindungsaufbau und Wiederaufnahme laufender Anwendungen. Dazu gehören auch Rückschaltung, eingehende Telefonie und die tatsächlich verwendeten Protokolle. Wiederaufnehmbare Downloads und wiederaufnehmbare Sicherungen reduzieren Folgen, ohne eine Garantie für jede Sitzung zu versprechen.
Fragen und Antworten
Warum kann ein IP-Telefon nach dem Wechsel unerreichbar bleiben?
Eine Registrierung oder ein bestehender SIP-Verbindungsweg kann noch auf den alten Anschluss zeigen. Dazu können NAT- oder Firewallzustände kommen, die Verkehr weiter an WAN1 binden. SIP-Anbieter unterscheiden sich in Registrierung, Flow-Nutzung, Keep-alives und Wiederanmeldung; eine kürzere Registrierungszeit allein löst deshalb nicht jeden Fall.
Gezieltes Löschen betroffener Zustände kann helfen. Ein globales Leeren der Zustandstabelle kann aber auch funktionierende Verbindungen unterbrechen, selbst wenn ein Fehlalarm den Eingriff ausgelöst hat. Änderungen gehören zur konkret getesteten Router- und Telefoniekonfiguration.
Beschleunigt ein kürzeres Prüfintervall die Umschaltung?
Im beschriebenen Modell sinkt der Erkennungsanteil. Bei I=1 s, T=0,2 s und N=3 liegt dieser zwischen 2,2 und knapp 3,2 Sekunden. Andere Routermodelle können anders reagieren. Zu empfindliche Schwellen können bei Last oder einzelnen verlorenen Prüfpaketen unnötige Umschaltungen auslösen.
Hilft die gleichzeitige Nutzung beider Anschlüsse?
Verbindungsbasierte Lastverteilung verteilt neue Verbindungen auf mehrere Wege. Beim Ausfall eines Anschlusses können Verbindungen auf dem anderen Weg weiterlaufen, sofern die Zustandsbehandlung keine zusätzliche Unterbrechung auslöst. Das unterscheidet sich von einer Bündelung, die einzelne Verbindungen über mehrere Wege trägt.
IP-gebundene Anmeldungen können bei wechselnden Ausgangsadressen Probleme bekommen. Bei pfSense halten Sticky Connections einen Quellrechner am selben Gateway, solange die Zuordnung gilt. Andere Produkte können anders gruppieren. Das reduziert die Verteilungsmöglichkeiten eines einzelnen Geräts und ersetzt keine Migration offener Verbindungen.
Quellen
- IETF RFC 9293: Transmission Control Protocol
- IETF RFC 9000: Verbindungswechsel mit QUIC
- IETF RFC 4555: Mobilität und mehrere Netzanbindungen bei IKEv2 (MOBIKE)
- WireGuard: eingebauter Netzwechsel
- IETF RFC 8445: ICE-Neustarts
- IETF RFC 7766: DNS über TCP
- IETF RFC 9110: HTTP-Anfragen für Dateibereiche
- IETF RFC 5626: vom Client aufgebaute SIP-Verbindungen
- Netgate: Gateway-Einstellungen und Überwachung
- Netgate: Verbindungszustände bei Gateway-Ausfall und Rückkehr
- Netgate: Lastverteilung und Ausfallsicherung
Passend dazu


