English
 Deutsch
gzip, Brotli und zstd: Womit zwanzig große Webseiten wirklich komprimieren

Inhalt
Eine Webseite, die im Browser ankommt, ist meist nicht die Seite, die auf dem Server liegt, sondern eine gepackte Fassung davon – und das Entpacken geschieht so früh, dass weiter hinten nichts mehr davon merkt.
Welches Verfahren dabei packt, wird zwischen Browser und Server bei jeder einzelnen Anfrage neu ausgehandelt. Drei davon sind im Umlauf, und eine Messung an zwanzig großen Startseiten zeigt, dass eines fast die ganze Arbeit macht.
Zwei Header regeln es
Der Browser macht den Anfang mit einer Liste. Seine Anfrage trägt eine Zeile namens Accept-Encoding, und darin steht alles, was der Browser entpacken kann – heute meist gzip, deflate, br, zstd.
Der Server sucht sich eines davon aus, packt die Antwort und nennt seine Wahl in einer Zeile namens Content-Encoding. Wählt er nichts, fehlt diese Zeile schlicht, und der Inhalt reist genau so, wie er auf der Platte liegt.
Eine weitere Zeile zählt überall dort, wo ein Zwischenspeicher im Weg sitzt. Vary: Accept-Encoding sagt diesem Speicher, dass die Antwort von der Frage abhängt – damit eine gepackte Kopie nie an ein Programm weitergereicht wird, das sie nicht entpacken kann.
Nichts an diesem Austausch ist eine feste Einstellung auf einer der beiden Seiten. Er wird für jede Datei neu geführt, jedes Mal.
Die drei Verfahren
gzip ist das älteste und das sicherste. Es steckt seit Jahrzehnten in jedem Browser und jedem Kommandozeilenwerkzeug, und nirgends verweigert es jemand.
br, kurz für Brotli, ist jünger und packt Text im Allgemeinen dichter als gzip, bei vergleichbarer Lesegeschwindigkeit. Browser bieten es nur über HTTPS an.
zstd ist noch jünger. Sein Argument ist Tempo statt Dichte: Es packt und entpackt schneller bei ähnlichem Verhältnis, was vor allem dort zählt, wo für jede einzelne Anfrage frisch gepackt wird.
deflate steht meist aus Gewohnheit mit in der Liste. Es ist derselbe Algorithmus wie gzip in einer anderen Verpackung und wird weit häufiger angeboten als je genutzt.
Was zwanzig Startseiten tatsächlich senden
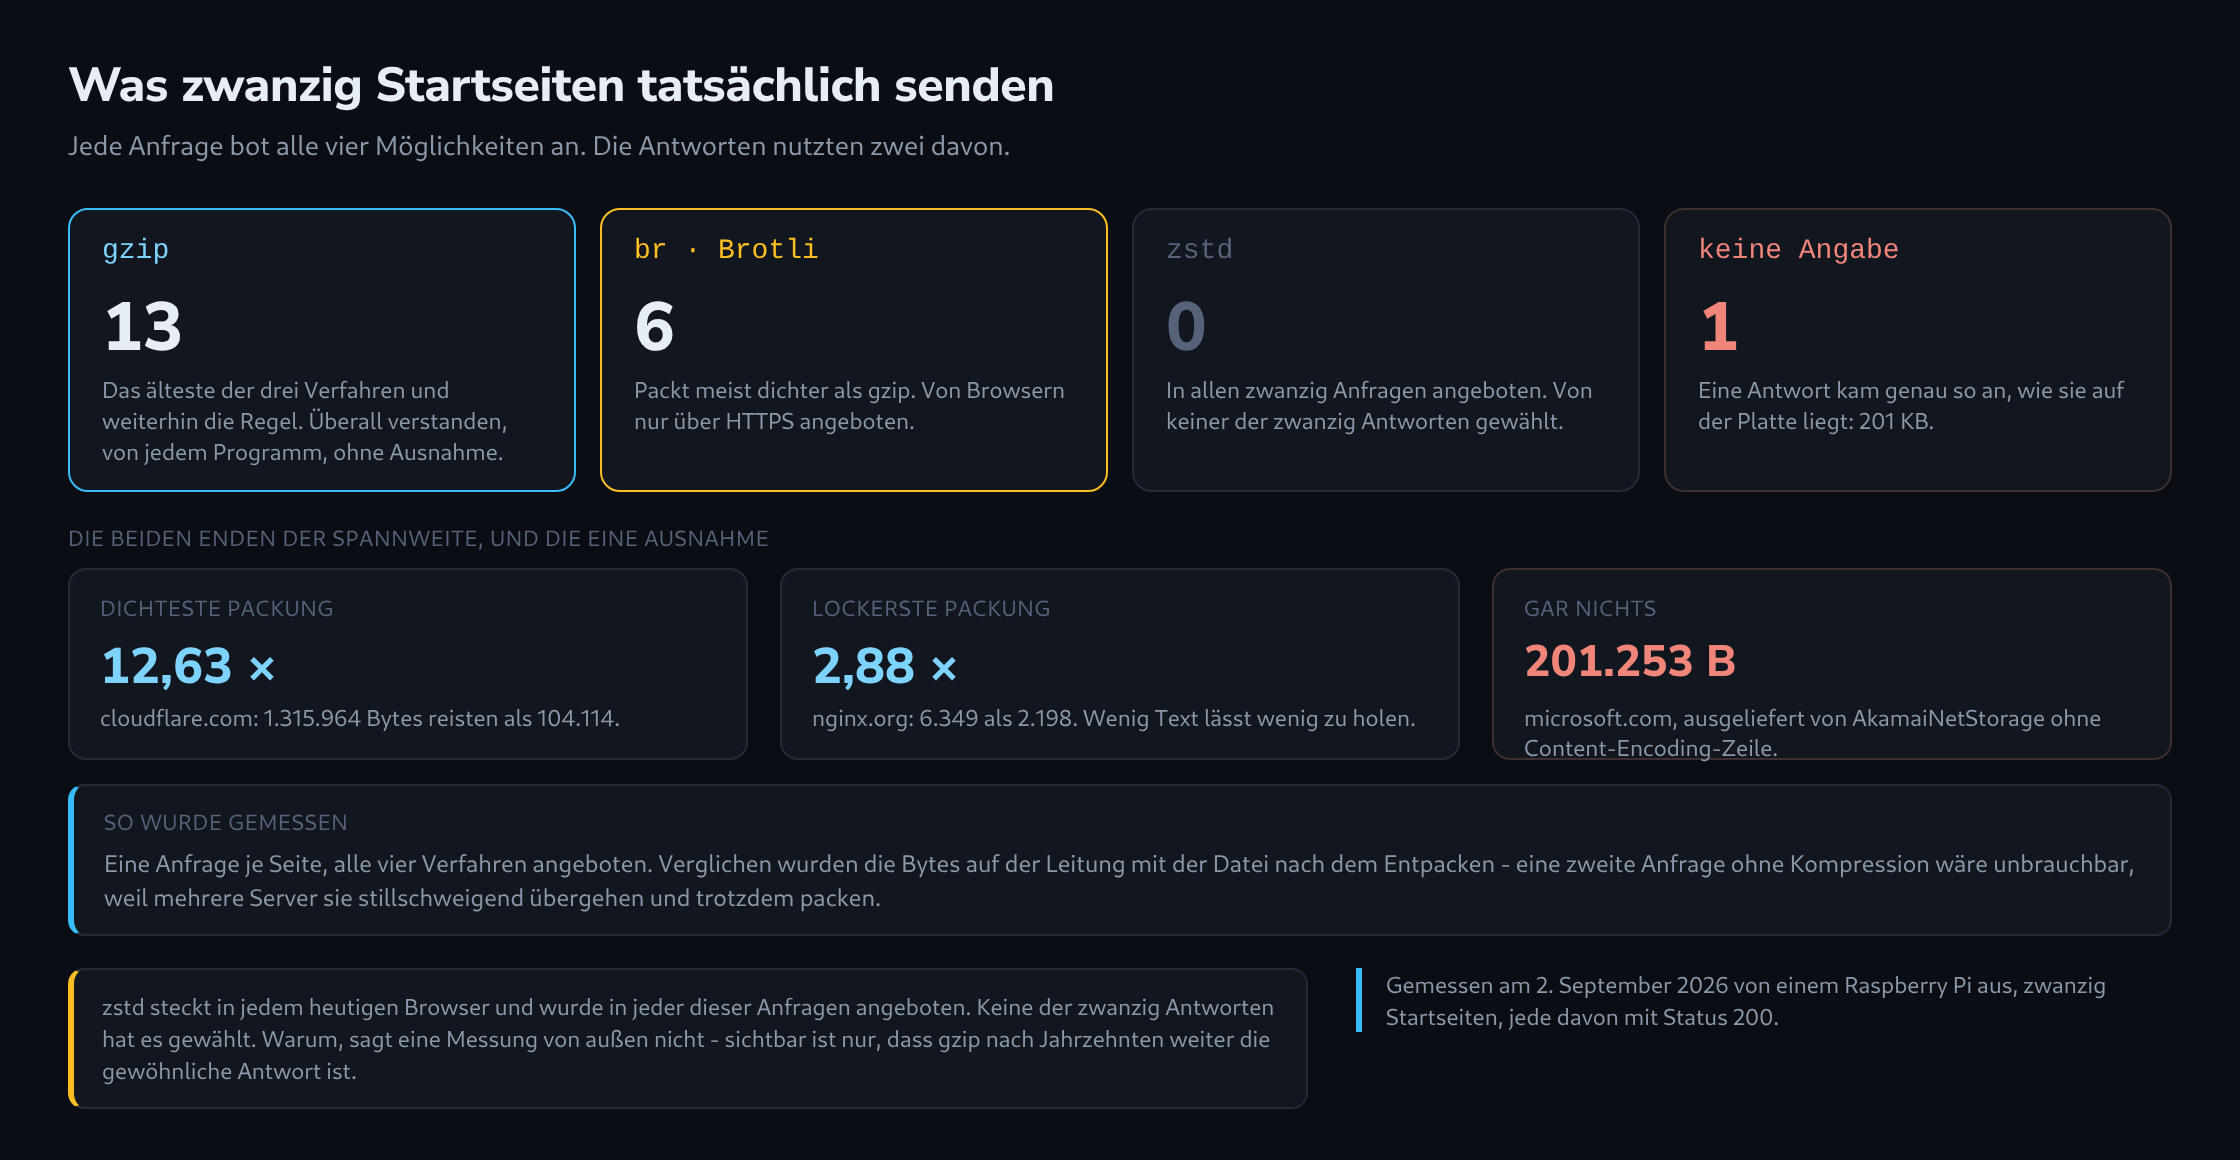
Zwanzig große Seiten wurden am 2. September 2026 je einmal gefragt, jede Anfrage mit allen vier Verfahren im Angebot. Alle zwanzig antworteten mit Status 200.
Dreizehn antworteten mit gzip: Wikipedia, GitHub, die BBC, die New York Times, Apple, Spiegel, Heise, python.org, debian.org, kernel.org, gnu.org, nginx.org und postgresql.org.
Sechs antworteten mit br: cloudflare.com, mozilla.org, w3.org, zeit.de, tagesschau.de und php.net.
Eine antwortete mit gar nichts.
Und zstd, in allen zwanzig Anfragen angeboten, wurde von keiner gewählt. Warum, ist von außen nicht zu sehen. Zu sehen ist, dass gzip nach drei Jahrzehnten weiterhin die gewöhnliche Antwort bleibt.
Wie viel es wirklich spart
Die gemessenen Verhältnisse reichen von 2,88 bis 12,63.
Am dichtesten packte cloudflare.com: 1.315.964 Bytes Auszeichnung reisten als 104.114. Am lockersten nginx.org mit 2,88, und das ist kein Versagen – die Seite ist kurz und schlicht, und eine kleine Datei trägt schlicht weniger Wiederholung, aus der sich schöpfen ließe.
Größe hilft also. Große, von einem Baukasten zusammengesetzte Seiten lassen sich weit besser packen als kleine handgeschriebene, denn Kompression lebt von Wiederholung, und eine erzeugte Seite ist voll davon.
Brotli gewinnt auch nicht von allein. tagesschau.de erreichte damit 11,99, während zeit.de mit demselben Verfahren auf 3,38 kam. Was gepackt wird, zählt mehr als womit.
Die eine, die nichts sendet
microsoft.com lieferte die einzige Antwort ohne Content-Encoding-Zeile: 201.253 Bytes HTML, genau wie gespeichert.
Die Antwort nennt ihre Herkunft deutlich genug – server: AkamaiNetStorage, ein nacktes content-length, kein vary. Kompression hätte davon rund neun Zehntel entfernt.
Das gehört genau gesagt, denn eine Messung ist eine Messung: Was hier, zu dieser Stunde, über diesen Weg ankam, war unkomprimiert. Ein anderer Knoten oder ein anderer Weg antwortet vielleicht anders. Die Antwort war trotzdem echt, und 201 KB sind über die Leitung gegangen.
Der Messfehler, der ein Ergebnis erfindet
Der naheliegende Weg zu einem Verhältnis ist, zweimal anzufragen: einmal mit Accept-Encoding: identity und einmal mit allen Verfahren im Angebot. Dann teilt man die Größe der ersten Antwort durch die der zweiten.
Diese Methode lieferte hier ein scheinbar eindeutiges, aber falsches Ergebnis. python.org lieferte beide Male 11.672 Bytes, also ein Verhältnis von genau 1,00. Das erweckt den Eindruck, die Seite komprimiere überhaupt nicht.
Der Eindruck täuscht. Der Server überging die Bitte um keine Kompression und schickte trotzdem gzip, also war beide Male die gepackte Größe gemeint. Richtig gemessen packt python.org 52.820 Bytes auf 11.672 herunter – ein Verhältnis von 4,52.
Der Weg, der sich nicht täuschen lässt, braucht nur eine Anfrage: die Bytes zählen, die auf der Leitung ankommen, und sie mit der Datei nach dem Entpacken vergleichen. Beide Zahlen stammen aus derselben Antwort, also bekommt kein Server die Gelegenheit, eine zweite Frage anders zu beantworten.
Fragen und Antworten
Lohnt sich Kompression auch für Bilder und Schriftdateien?
Kaum. JPEG, PNG, WebP und WOFF2 sind bereits in sich komprimiert, und gzip oder Brotli finden darin kaum noch Wiederholung, aus der sich schöpfen ließe; manchmal wird die Datei sogar ein wenig größer. Server beschränken die Kompression deshalb üblicherweise auf Textformate wie HTML, CSS, JavaScript, JSON und SVG.
Kostet Brotli auf dem Server mehr Rechenzeit als gzip?
Das hängt an der Stufe. Brotli kennt Qualitätsstufen von 0 bis 11, und die obersten packen deutlich langsamer als gzip. Für Antworten, die bei jeder Anfrage frisch entstehen, etwa HTML aus WordPress, sind deshalb mittlere Stufen üblich, bei denen der Zeitbedarf in der Größenordnung von gzip liegt und das Ergebnis trotzdem dichter ausfällt.
Bei statischen Dateien fällt die Rechnung anders aus. CSS und JavaScript lassen sich einmal beim Ausrollen mit der höchsten Stufe vorpacken und als fertige Datei neben das Original legen; der Server reicht dann nur noch die passende Fassung aus. Die langsame Stufe kostet so einmal Zeit statt bei jedem Abruf. Genau auf den umgekehrten Fall, das Packen bei jeder Anfrage, zielt das Tempo-Argument von zstd.
Ist Kompression über HTTPS ein Sicherheitsrisiko?
In einem eng umrissenen Fall. Der Angriff BREACH nutzt, dass eine komprimierte Antwort kürzer wird, wenn ein vom Angreifer eingeschleuster Text mit einem Geheimnis in derselben Antwort übereinstimmt. Nötig sind drei Dinge zugleich: ein Geheimnis im Antworttext, etwa ein CSRF-Token, eine Eingabe des Angreifers, die in derselben Antwort wieder erscheint, und die Möglichkeit, sehr viele Anfragen auszulösen und die Länge der verschlüsselten Antworten zu beobachten.
Die übliche Abwehr lässt die Kompression eingeschaltet und nimmt stattdessen eine der Bedingungen weg: Tokens, die bei jeder Auslieferung anders maskiert werden, oder keine ungefilterte Wiedergabe von Eingaben auf Seiten mit Geheimnissen. Die Kompression auf TLS-Ebene, gegen die sich der ältere Angriff CRIME richtete, gibt es in TLS 1.3 nicht mehr; sie hat mit Content-Encoding nichts zu tun.
Wie sieht die Messung mit nur einer Anfrage auf der Kommandozeile aus?
Am einfachsten mit curl ohne automatisches Entpacken: Die Anfrage bietet nur gzip an, und die Antwort landet genau so in einer Datei, wie sie über die Leitung kam.
curl -s -D - -H "Accept-Encoding: gzip" -o seite.gz https://example.com/
Die ausgegebenen Header zeigen, ob der Server tatsächlich Content-Encoding: gzip gesetzt hat. Danach liefert wc -c < seite.gz die Größe des gepackten Inhalts, wie er übertragen wurde, und gzip -dc seite.gz | wc -c die Größe nach dem Entpacken; das Verhältnis beider Zahlen ist der gesuchte Wert. Beide stammen aus derselben Antwort, und genau darauf kommt es an.
Fehlt die Zeile Content-Encoding, ist die Datei gar nicht gepackt, und gzip bricht mit einer Fehlermeldung ab. Auch das ist ein Befund, der Fall von microsoft.com. Für Brotli gilt dasselbe mit br im Angebot und dem Programm brotli zum Entpacken, sofern es installiert ist.
Passend dazu