English
 Deutsch
410 Gone auf die robots.txt: Wie eine 4xx-Antwort auf die Regeldatei das Crawler-Verhalten verändert

Inhalt
Eine Absage soll ein Gespräch beenden. Die deutlichste, die das Web kennt, ist 410 Gone: nicht „später noch einmal”, nicht „umgezogen”, sondern „das gab es, und es gibt es nicht mehr”.
Ein kleiner Server hat diese Absage an einem einzigen Tag 732.498-mal geschickt. Der Crawler, der die meisten davon bekam, wurde nicht langsamer – und war es seit elf Tagen nicht geworden.
Was ein 410 wirklich sagt
Mehrere Antworten decken ab, auf welche Weise eine Seite nicht verfügbar ist, und sie sagen recht Verschiedenes.
404 Not Found heißt: Hier ist nichts. Ob hier früher etwas war oder morgen etwas sein wird, bleibt offen. Ein Crawler behandelt das als vorläufig und kommt wieder.
410 Gone heißt: Hier war etwas, es wurde absichtlich entfernt, und es gibt keine neue Adresse. Das ist die stärkste Art zu sagen, dass eine Seite erledigt ist, und Suchmaschinen lassen solche Adressen schneller fallen als ein 404.
Tausende tote Adressen mit 410 zu beantworten, ist also die richtige Wahl. Der Fehler lag an ganz anderer Stelle.
Die Regel traf die eine Datei, die es hätte beenden können
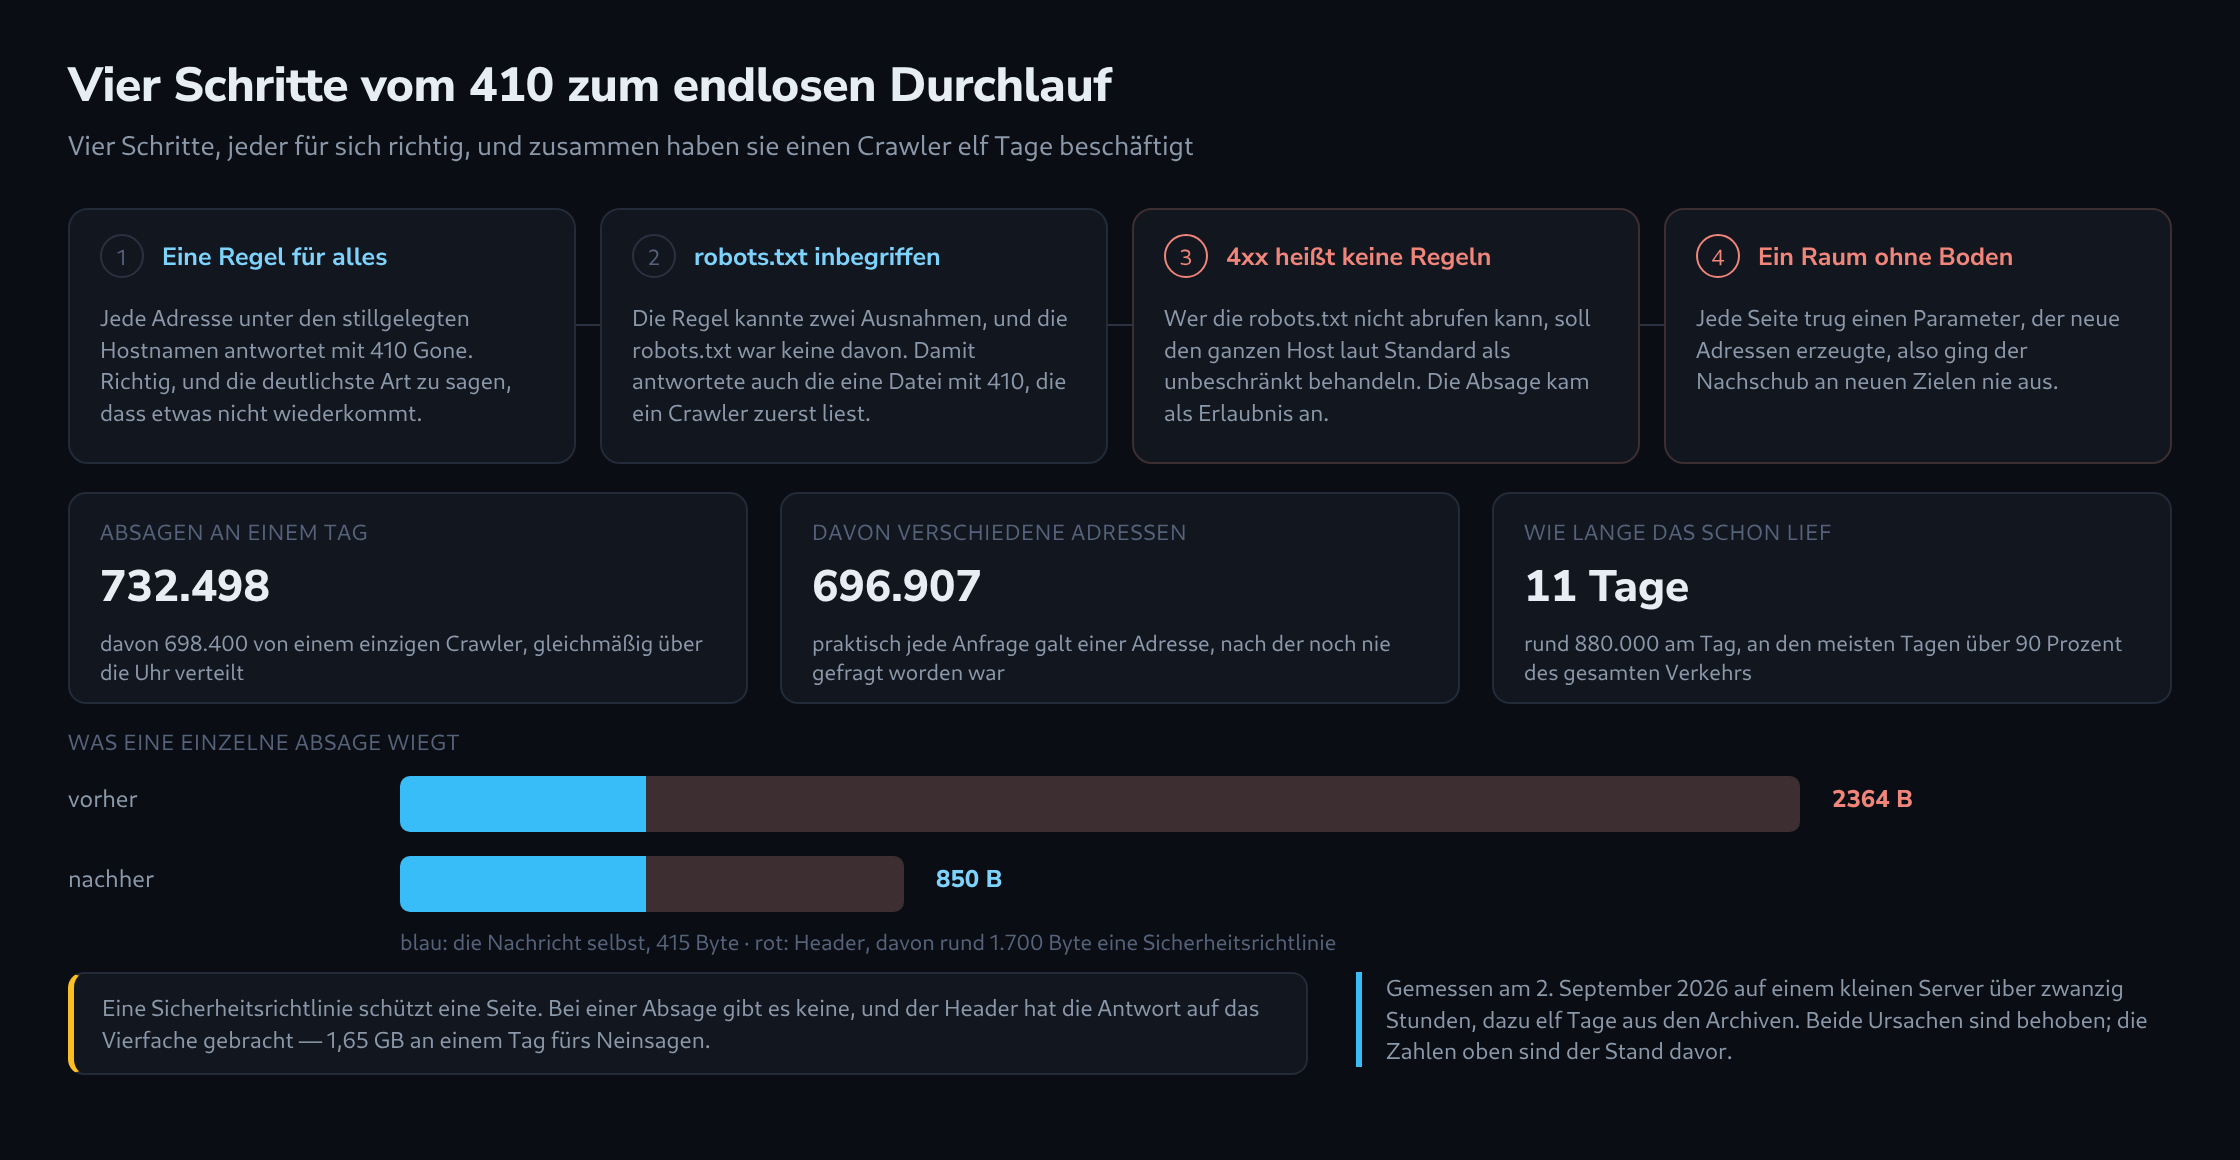
Die Absage steckte in einer einzigen Regel: Jede Adresse unter den stillgelegten Hostnamen antwortet mit 410. Zwei Ausnahmen waren herausgeschnitten, beide bewusst und beide eng.
Die robots.txt war keine davon.
Das lässt sich leicht übersehen: Die robots.txt enthält Regeln für Crawler, ist aber selbst keine Inhaltsseite. Eine Regel nach dem Muster „hier ist alles weg“ erfasst trotzdem auch ihre Adresse. Deshalb antwortete sie ebenso wie alle anderen Adressen mit 410.
Warum eine 4xx-Antwort keine Einschränkung bedeutet
Hier wird aus einem Versehen eine Einladung.
Der Standard ist eindeutig, was gilt, wenn die robots.txt nicht abrufbar ist. Eine 5xx-Antwort – der Server ist kaputt – bedeutet: Die ganze Seite gilt als gesperrt, später noch einmal versuchen. Eine 4xx-Antwort bedeutet das Gegenteil: Auf diesem Host gibt es keine Regeln, alles darf geholt werden.
Die Überlegung dahinter trägt. Eine fehlende robots.txt hieß immer schon „keine Einschränkung”, und nichts unterscheidet „dieser Host hatte nie Regeln” von „dieser Host hat sie entfernt”. 404 und 410 landen in derselben Schublade.
Die Absage kam also genau verkehrt herum an. Statt eines klaren Wegbleibens sagte sie in dem einen Satz, den ein Crawler liest, bevor er irgendetwas entscheidet, dass hier nichts gesperrt sei.
Ein Adressraum ohne Boden
Eine falsche Antwort wird erst teuer, wenn es etwas gibt, wofür sie sich ausgeben lässt.
Die angefragten Adressen trugen einen Parameter, der festhielt, woher der Crawler gekommen war. Jede Seite verwies damit auf Adressen, die es vorher nie gegeben hatte, und die verwiesen weiter. Der Nachschub ging nie aus.
Die Zahlen zeigen es deutlich: Von 698.400 Anfragen an einem Tag galten 696.907 verschiedenen Adressen – zwei von tausend waren Wiederholungen. Ein Crawler, der einen solchen Raum abarbeitet, macht nichts falsch; er folgt Verweisen, und das ist seine ganze Aufgabe. Fertig wird er nie.
Was eine einzelne Absage wiegt
Die letzte Überraschung steckte in der Größe.
Die Nachricht selbst ist klein: 415 Byte schlichter Text, der mitteilt, dass die Ressource fort ist. Die Header darum kamen auf 1.949 Byte, und rund 1.700 davon waren eine Sicherheitsrichtlinie für Inhalte.
Diese Richtlinie regelt, was eine Seite laden darf. Bei einer Absage gibt es keine Seite – nichts zu laden, nichts zu regeln, nichts, was der Header schützen könnte. Angehängt war sie trotzdem an jede der 732.498 Antworten, weil sie auf „immer” gestellt war, was für echte Seiten genau richtig ist.
Das Ergebnis: 2.364 Byte fürs Neinsagen, und 1,65 GB an einem Tag dafür.
Was daraus folgt
Drei Dinge, nach Wirkung geordnet.
Eine Regel, die einen Host verschwinden lässt, braucht eine Ausnahme für die Datei, die den Host beschreibt. Die robots.txt und alles andere, was ein Crawler liest, um zu entscheiden, muss lesbar bleiben, auch wenn alles Beschriebene fort ist. Eine erreichbare robots.txt mit einem einzigen Disallow: / beendet den Verkehr an der Quelle, statt ihn aufzufangen.
Header für Seiten gehören nicht auf Absagen. Auf die Hosts beschränkt, die tatsächlich Seiten ausliefern, sank jede Antwort von 2.364 auf 850 Byte – dieselbe Absage bei ungefähr einem Drittel des Gewichts.
Und ein Parameter, der neue Adressen erzeugt, macht aus jedem Durchlauf einen endlosen. Wo hinter entfernten Inhalten ein solcher Raum liegt, ist das Entfernen nicht das Ende der Arbeit.
Fragen und Antworten
Nimmt ein Disallow: / die alten Adressen auch aus dem Suchindex?
Nicht unmittelbar. Ein Disallow verbietet das Abrufen, nicht die Aufnahme in den Index. Eine gesperrte Adresse wird nicht mehr geholt, und damit sieht der Crawler auch ihr 410 nicht mehr. Adressen, die bereits bekannt sind oder von anderswo verlinkt werden, können deshalb als bloße Adresse ohne Inhalt im Index bleiben. Ein noindex hilft hier ebenso wenig, denn auch das stünde auf einer Seite, die nicht mehr abgerufen wird.
Wer beides will, muss sich für eine Reihenfolge entscheiden: Zuerst müssen die wichtigen Adressen ihr 410 ausliefern können, danach beendet die Sperre den Verkehr. Bei einem Adressraum ohne Boden wie dem im Artikel geht diese Rechnung allerdings nicht auf, denn die Absagen würden nie fertig. Dort ist die Sperre die bessere Wahl, auch wenn einzelne Adressen noch eine Weile im Index stehen.
Warum nicht die robots.txt mit 503 beantworten, damit die ganze Seite als gesperrt gilt?
Weil diese Sperre nur auf Zeit gilt. RFC 9309 behandelt einen Serverfehler bei der robots.txt zunächst als vollständiges Verbot, erlaubt einem Crawler aber, nach längerer Zeit ohne erreichbare Datei (der Standard nennt 30 Tage als Beispiel) so zu verfahren, als gäbe es keine robots.txt, oder eine zwischengespeicherte Fassung weiterzuverwenden. Im ersten Fall stünde der Host wieder ohne Regeln da, genau wie mit dem 410. Eine erreichbare Datei mit Disallow: / ist die Form, die dauerhaft gilt.
Wie schnell wirkt eine korrigierte robots.txt?
Mit bis zu einem Tag Verzögerung. RFC 9309 sieht vor, dass ein Crawler eine zwischengespeicherte robots.txt nicht länger als 24 Stunden verwenden soll; bis dahin kann er noch nach der alten Antwort arbeiten, hier also so, als gäbe es keine Regeln. Ob die Korrektur greift, zeigt sich deshalb erst im Verkehr des folgenden Tages, nicht in der ersten Stunde.
Passend dazu