

 English
 Deutsch
 Polski
Fehlende Seiten richtig behandeln: 404-Fehler und andere Serverantworten prüfen

Management Summary
Eine nicht vorhandene Websiteadresse sollte zu einer verständlichen Fehlermeldung führen statt einen scheinbaren Erfolg zu zeigen. Zufällige Adressen machen sichtbar, wie eine Website solche Fälle behandelt, einschließlich Weiterleitungen. Das ist für Besucher mit defekten Links und für automatisch auswertende Dienste wichtig. Die Stichprobe mit sechzig Antworten erklärt, warum Status, endgültiger Inhalt und Navigation zusammen betrachtet werden müssen. Eine Weiterleitung ist nicht automatisch falsch; die Antwortgröße allein beweist keine richtige Behandlung.
Inhalt
Eine fehlende Seite sollte eine verständliche Fehlermeldung und einen passenden HTTP-Status liefern. Zufällige Testpfade zeigen, wie eine Website solche Anfragen behandelt. Routingregeln bestimmen, welche Datei oder Anwendung einen angeforderten Pfad bearbeitet. Unterschiedliche Antworten können auf verschiedene Routingregeln hinweisen; ein Widerspruch oder eine Fehlkonfiguration ist damit noch nicht bewiesen.
Am 6. September 2026 wurden zwanzig Domains mit jeweils drei Pfadformen geprüft. Die gespeicherten sechzig Antworten bilden eine historische Stichprobe ab, keinen aktuellen Zustandsbericht.
Drei Pfadformen, begrenzte Aussagekraft
Ein zufälliger Name wurde ohne Endung, mit .html und mit abschließendem Schrägstrich angefragt. Dadurch werden möglicherweise unterschiedliche Regeln für Dateien, Verzeichnisse und Anwendungen erreicht. Der Zufall verringert die Wahrscheinlichkeit eines Treffers auf vorhandene Inhalte. Eine Garantie für Nichtexistenz oder eine ungecachte Antwort entsteht daraus nicht: Anwendungen können beliebige Pfade dynamisch beantworten.
Was die sechzig Antworten zeigen
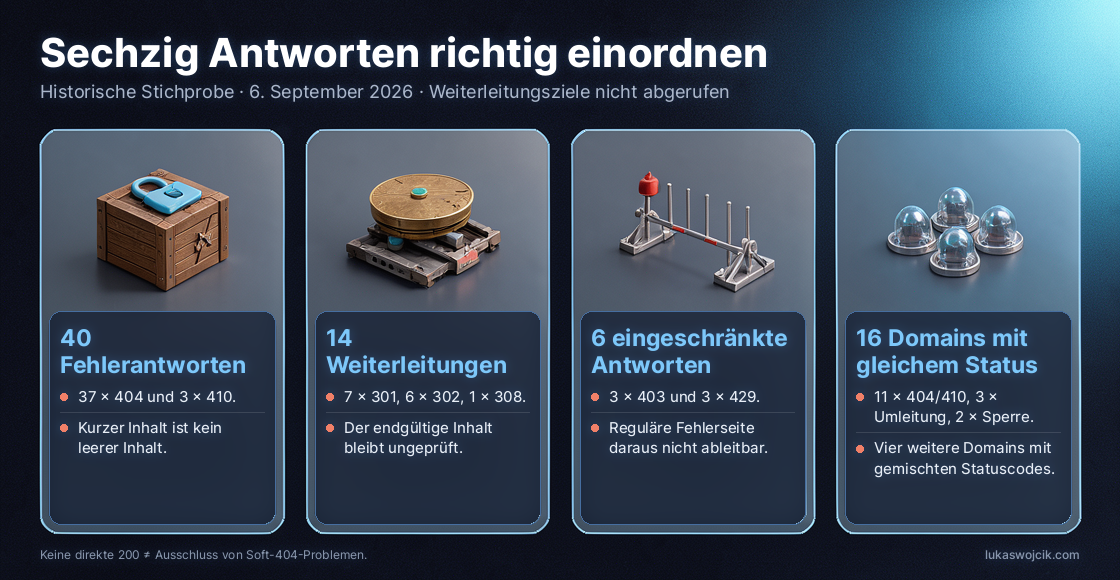
Die Rohdaten enthalten 37 Antworten mit 404, drei mit 410 und vierzehn Weiterleitungen: siebenmal 301, sechsmal 302 und einmal 308. Hinzu kommen drei Antworten mit 403 und drei mit 429. Eine Zugriffssperre oder Ratenbegrenzung beschreibt die Bedingungen dieser Messung; daraus folgt keine sichere Ursache und keine Aussage über die reguläre Fehlerseite.
Sechzehn Domains lieferten für alle drei Pfade denselben Status. Davon antworteten elf durchgehend mit 404 oder 410, drei durchgehend mit Weiterleitungen und zwei durchgehend mit 403 beziehungsweise 429. Vier Domains lieferten unterschiedliche Statuscodes.
Bei den drei vollständig weiterleitenden Domains zeigen die gespeicherten Ziele unterschiedliche Fälle: Wikipedia leitete auf den englischen Host um, Mozilla auf einen Sprachpfad und PHP auf eine Suche. Die Behauptung von zwei Suchseiten ist durch diese Rohdaten nicht gedeckt. Die Ziele wurden bei den Fehlerproben nicht weiter abgerufen.
Kein direkter Status 200 ist kein Soft-404-Ausschluss
Keine der sechzig direkten Antworten hatte Status 200. Das schließt Soft-404-Probleme hinter Weiterleitungen nicht aus. Eine Soft-404 liegt beispielsweise vor, wenn eine Antwort Erfolg meldet, der Inhalt aber eine fehlende Seite beschreibt. Google prüft den Inhalt; Status 200 garantiert keine Indexierung.
Der Wortschatzvergleich des Werkzeugs ist lediglich ein Hinweis auf ähnliche Inhalte. Gemeinsame Navigation kann die Ähnlichkeit erhöhen; eine eigenständige Fehlerseite kann wenig Ähnlichkeit zur Startseite haben. Im geprüften Werkzeugstand wird jede direkte 200-Antwort als Soft-404-Verdacht ausgegeben, unabhängig vom Ähnlichkeitswert. Eine fachliche Bestätigung erfordert die Prüfung von Inhalt und Weiterleitungsziel.
404 und 410 richtig unterscheiden
404 bedeutet, dass keine aktuelle Darstellung gefunden wurde oder die Existenz nicht offengelegt werden soll. Der Status legt nicht fest, ob dieser Zustand dauerhaft ist. 410 kennzeichnet eine nicht mehr verfügbare Ressource, deren Ausfall voraussichtlich dauerhaft ist. Bei unbekannter Dauerhaftigkeit empfiehlt RFC 9110 den Status 404.
Google behandelt 404 und 410 für die hier beschriebene Verarbeitung gleich. Eine allgemeine Zusage, dass große Crawler bei 410 schneller aufhören, ist deshalb nicht belastbar. In der Stichprobe antwortete diese Website dreimal mit 410 und jeweils 408 Byte Inhalt. Das ist kurz, aber nicht leer. Die Werkzeugschwelle von weniger als 512 Byte beweist weder fehlenden Inhalt noch fehlende Navigation.
Größe und Indexierung getrennt beurteilen
Sechzehn der vierzig 404-/410-Antworten lagen laut Auswertung über 100 KiB. Vier Antworten wurden mit gerundet 256 KiB gespeichert, passend zur Lesegrenze von 262.144 Byte. Ohne vollständige Antwortdaten und gespeicherte Kürzungsmarkierung lässt sich daraus keine exakte Gesamtgröße ableiten. Erfasst wurde der gelesene Antwortkörper, nicht der vollständige Seitenaufwand einschließlich Bildern, Skripten und Stylesheets.
Eine hilfreiche Fehlerseite kann Navigation oder eine Suche anbieten. Der Umfang sollte zum Nutzen passen. Die Aussage, jeder Crawler lese ausschließlich den Statuscode, wäre zu pauschal.
Das Werkzeug erkannte bei keiner dieser Antworten noindex. Der einfache HTML-Abgleich übersieht jedoch unter anderem vertauschte Meta-Attribute. Das Ergebnis beweist daher keine vollständige Abwesenheit. Für tatsächlich fehlende Seiten ist der passende Fehlerstatus entscheidend; noindex ersetzt diese Semantik nicht. Bei gültigen Seiten, die nicht in Suchergebnissen erscheinen sollen, kann noindex dagegen sinnvoll sein.
Die geprüfte Basisadresse offenlegen
Der Prüfer folgt zunächst den Weiterleitungen der Vergleichsseite und bildet aus dem Endziel eine Basis aus Schema, Host und Port. Die zufälligen Pfade beginnen anschließend direkt unter dem Hostnamen: Aus einer Vergleichsseite unter /de/ entsteht beispielsweise /probe-123 statt /de/probe-123. Das gilt auch für andere Sprach- oder Anwendungspfade. Das vermeidet bestimmte vorgelagerte Hostweiterleitungen, untersucht aber nicht automatisch jeden Bereich der Website.
Der frühere Vergleich „49 statt 11 Weiterleitungen“ ist mit dem vorhandenen Messprotokoll nicht reproduzierbar. Dieses Protokoll enthält vierzehn Weiterleitungen. Vergleichbare Wiederholungen benötigen denselben Prüfbereich, dieselben Abrufbedingungen und gespeicherte Zwischenziele.
Ein begrenzter Test mit curl
Das folgende Bash-Beispiel benötigt curl und OpenSSL. Die Beispieldomain dient als Platzhalter. Ein neuer Zufallsname wird in drei Formen angefragt; Antwortheader zeigen auch ein mögliches Location-Ziel. Weiterleitungen werden bewusst zunächst nicht verfolgt. Abruffehler erscheinen separat und dürfen nicht als HTTP-Status 000 interpretiert werden.
base="https://www.example.com"
name="probe-$(openssl rand -hex 12)" || exit 1
for path in "$name" "$name.html" "$name/"; do
  printf '\n%s\n' "$path"
  if ! curl --silent --show-error --connect-timeout 5 --max-time 15 \
      --dump-header - --output /dev/null \
      --write-out 'HTTP %{http_code}; body bytes %{size_download}\n' \
      "$base/$path"; then
    printf 'Retrieval failed\n' >&2
  fi
done
Der Soft-404- und Fehlerseiten-Prüfer ergänzt solche Proben um Größen- und Textvergleiche. Die beschriebenen Grenzen bleiben bei der Bewertung relevant.
Fragen und Antworten
Ist jede Weiterleitung eines Zufallspfads fehlerhaft?
Nein. Eine Host- oder Sprachweiterleitung kann regulär sein. Entscheidend sind Ziel, endgültiger Status und Inhalt. Ein pauschaler Sprung auf eine inhaltlich unpassende Startseite behebt eine fehlende Ressource nicht zuverlässig.
Was bedeutet eine länger anhaltende 429?
Google behandelt 429 ähnlich wie Serverfehler und reduziert vorübergehend die Abrufrate. Länger anhaltende Fehler können zur Entfernung betroffener URLs aus dem Index führen. Ein einzelner Messwert belegt weder dieses Ergebnis noch eine dauerhafte Sperre.
Passend dazu


