

 English
 Deutsch
 Polski
Poprawna obsługa brakujących stron: kontrola błędów 404 i innych odpowiedzi serwera

Management Summary
Nieistniejący adres witryny powinien prowadzić do zrozumiałego komunikatu o brakującej stronie zamiast pozornego sukcesu. Losowe adresy pokazują, jak strona obsługuje takie sytuacje, również przez przekierowania. Ma to znaczenie dla odwiedzających korzystających z błędnych linków i usług automatycznie interpretujących odpowiedź. Próba sześćdziesięciu odpowiedzi wyjaśnia potrzebę wspólnej oceny statusu, końcowej treści i nawigacji. Przekierowanie nie jest automatycznie błędem, a sam rozmiar odpowiedzi nie dowodzi poprawności.
Spis treści
Brakująca strona wymaga zrozumiałego komunikatu i odpowiedniego statusu HTTP. Losowe ścieżki testowe pokazują sposób obsługi takich żądań. Reguły routingu określają, który plik lub aplikacja obsługuje żądaną ścieżkę. Różne odpowiedzi mogą wynikać z różnych reguł routingu; sama różnica nie dowodzi sprzeczności ani błędu konfiguracji.
6 września 2026 r. sprawdzono dwadzieścia domen, każdą za pomocą trzech form ścieżki. Sześćdziesiąt zapisanych odpowiedzi stanowi historyczną próbę, a nie opis aktualnego działania witryn.
Trzy formy ścieżki i granice pomiaru
Losową nazwę pobrano bez rozszerzenia, z końcówką .html oraz z ukośnikiem na końcu. Poszczególne formy mogą trafiać do różnych reguł obsługi plików, katalogów lub aplikacji. Losowość zmniejsza szansę trafienia na istniejącą treść. Nie gwarantuje jednak nieistnienia zasobu ani pominięcia pamięci podręcznej: aplikacja może generować treść dla dowolnych ścieżek.
Co pokazuje sześćdziesiąt odpowiedzi
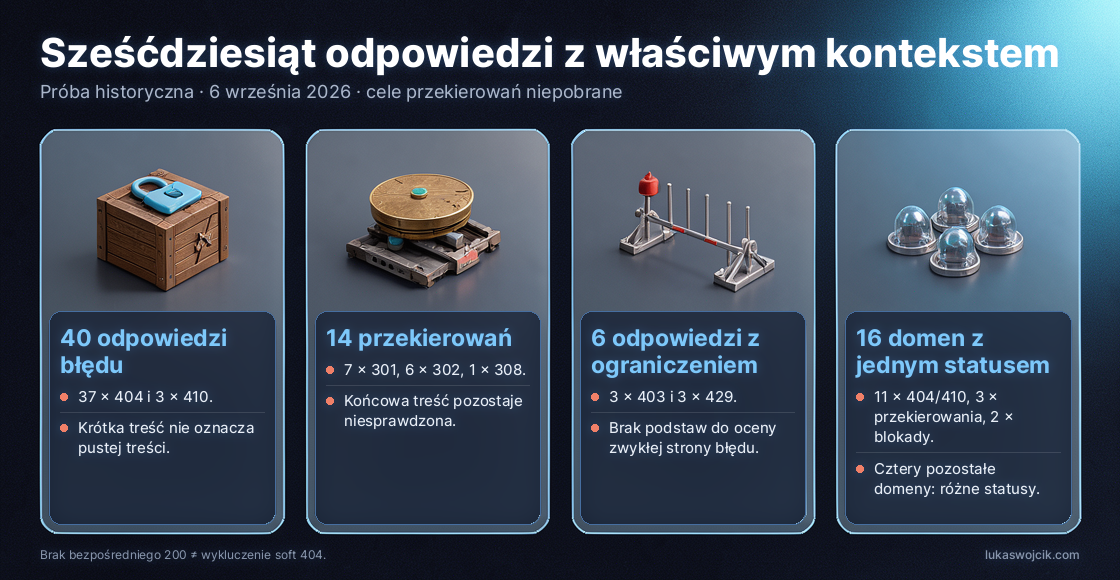
Dane źródłowe zawierają 37 odpowiedzi 404, trzy odpowiedzi 410 oraz czternaście przekierowań: siedem 301, sześć 302 i jedno 308. Dodatkowo wystąpiły trzy odpowiedzi 403 i trzy odpowiedzi 429. Ograniczenie dostępu lub liczby żądań opisuje warunki tego pomiaru; sam status nie wyjaśnia dokładnej przyczyny ani zwykłej odpowiedzi na brakującą stronę.
Szesnaście domen zwróciło ten sam status dla wszystkich trzech ścieżek. Jedenaście konsekwentnie zwracało 404 lub 410, trzy przekierowywały wszystkie żądania, a dwie konsekwentnie zwracały 403 albo 429. Cztery domeny zwróciły różne statusy zależnie od formy ścieżki.
Zapisane cele rozróżniają trzy domeny przekierowujące każdą sondę: Wikipedia kierowała na angielski host, Mozilla do ścieżki językowej, a PHP do wyszukiwania. Dane nie potwierdzają wcześniejszego stwierdzenia o dwóch stronach wyszukiwania. Sondy brakujących stron nie pobierały celów przekierowań.
Brak bezpośredniej odpowiedzi 200 nie wyklucza soft 404
Żadna z sześćdziesięciu bezpośrednich odpowiedzi nie miała statusu 200. Nie wyklucza to problemów soft 404 za przekierowaniami. Soft 404 może wystąpić, gdy odpowiedź sygnalizuje sukces, ale treść opisuje brak strony. Google ocenia treść; status 200 nie gwarantuje indeksowania.
Porównanie słownictwa w narzędziu jest jedynie wskazówką podobieństwa treści. Wspólna nawigacja może zwiększać wynik, a osobna strona błędu może mieć niewiele wspólnych słów ze stroną główną. Sprawdzona wersja narzędzia oznacza każdą bezpośrednią odpowiedź 200 jako podejrzenie soft 404, niezależnie od podobieństwa. Potwierdzenie wymaga oceny treści oraz celu ewentualnego przekierowania.
Różnica między 404 a 410
404 oznacza brak aktualnej reprezentacji albo brak zgody serwera na ujawnienie istnienia zasobu. Status nie określa trwałości tego stanu. 410 opisuje zasób już niedostępny, prawdopodobnie trwale. Przy nieznanej trwałości RFC 9110 zaleca 404.
Google traktuje 404 i 410 jednakowo w opisanym tutaj przetwarzaniu. Ogólna obietnica szybszego zakończenia odwiedzin przez duże roboty po 410 nie ma więc podstaw. Ta witryna zwróciła w próbie trzy odpowiedzi 410, każdą z treścią o długości 408 bajtów. Krótka odpowiedź nie jest pusta. Próg narzędzia poniżej 512 bajtów nie dowodzi braku treści ani nawigacji.
Rozmiar i indeksowanie wymagają osobnej oceny
Szesnaście z czterdziestu odpowiedzi 404/410 przekroczyło 100 KiB według zapisanej analizy. Cztery miały zapisany zaokrąglony rozmiar 256 KiB, odpowiadający limitowi odczytu 262 144 bajtów. Bez pełnych odpowiedzi i zachowanej informacji o przycięciu nie da się ustalić dokładnego rozmiaru całkowitego. Pomiar obejmował odczytaną treść odpowiedzi, a nie koszt całej strony wraz z obrazami, skryptami i arkuszami stylów.
Przydatna strona błędu może oferować nawigację lub wyszukiwanie. Rozmiar powinien odpowiadać tej korzyści. Twierdzenie, że każdy robot czyta wyłącznie kod stanu, byłoby zbyt szerokie.
Narzędzie nie wykryło w tych odpowiedziach znaczników noindex. Proste sprawdzenie HTML pomija jednak między innymi odwrotną kolejność atrybutów meta. Brak wykrycia nie dowodzi więc nieobecności znacznika. Faktycznie brakująca strona wymaga odpowiedniego statusu błędu; noindex nie zastępuje tego znaczenia. Poprawna strona przeznaczona do wykluczenia z wyników wyszukiwania może natomiast zasadnie korzystać z noindex.
Jawny adres bazowy pomiaru
Narzędzie najpierw podąża za przekierowaniami strony porównawczej, a następnie tworzy bazę ze schematu, hosta i portu końcowego adresu. Losowe ścieżki zaczynają się bezpośrednio pod nazwą hosta: dla strony porównawczej pod /pl/ powstaje na przykład /probe-123 zamiast /pl/probe-123. Dotyczy to także innych ścieżek językowych i aplikacyjnych. Pozwala to ominąć niektóre wstępne przekierowania hosta, ale nie oznacza sprawdzenia wszystkich części witryny.
Wcześniejszego porównania 49 przekierowań z 11 nie da się odtworzyć z dostępnego pliku pomiarowego. Ten plik zawiera czternaście przekierowań. Porównywalne powtórzenia wymagają tego samego zakresu i warunków pobierania oraz zachowania celów pośrednich.
Ograniczony test za pomocą curl
Poniższy przykład dla Bash wymaga curl i OpenSSL. Przykładowa domena jest symbolem zastępczym. Nowa losowa nazwa jest pobierana w trzech formach; nagłówki odpowiedzi pokazują również ewentualny cel Location. Przekierowania początkowo nie są śledzone. Błędy pobierania pojawiają się osobno i nie stanowią statusu HTTP 000.
base="https://www.example.com"
name="probe-$(openssl rand -hex 12)" || exit 1
for path in "$name" "$name.html" "$name/"; do
  printf '\n%s\n' "$path"
  if ! curl --silent --show-error --connect-timeout 5 --max-time 15 \
      --dump-header - --output /dev/null \
      --write-out 'HTTP %{http_code}; body bytes %{size_download}\n' \
      "$base/$path"; then
    printf 'Retrieval failed\n' >&2
  fi
done
Kontrola soft 404 i stron błędu dodaje porównania rozmiaru i słownictwa. Przy interpretacji wyników nadal obowiązują opisane ograniczenia.
Pytania i odpowiedzi
Czy każde przekierowanie losowej ścieżki jest błędem?
Nie. Przekierowanie hosta lub języka może być prawidłowe. Znaczenie zależy od celu, końcowego statusu i treści. Przekierowanie wszystkich żądań na niepowiązaną stronę główną nie rozwiązuje niezawodnie problemu brakującego zasobu.
Co oznacza długotrwały status 429?
Google obsługuje 429 podobnie do błędów serwera i tymczasowo zmniejsza częstotliwość pobierania. Długotrwałe błędy mogą doprowadzić do usunięcia dotkniętych adresów z indeksu. Pojedynczy pomiar nie dowodzi takiego skutku ani trwałej blokady.
Powiązane artykuły


