

 English
 Deutsch
 Polski
Strukturierte Website-Daten mit JSON-LD prüfen: Was Suchmaschinen auslesen können

Management Summary
Strukturierte Daten beschreiben Website-Inhalte für Suchmaschinen, etwa als Artikel, Organisation oder Bild. JSON-LD ist ein Format, das solche Angaben neben dem sichtbaren Seiteninhalt bereitstellt. Das kann besondere Suchdarstellungen unterstützen, garantiert diese jedoch nicht. Der Beitrag erklärt, warum das Zählen von Datenblöcken keine Qualitätsbewertung ersetzt. Die Angaben müssen zum Inhalt und zum empfangenden Dienst passen; eine begrenzte Untersuchung kann zudem Teile der Informationen übersehen.
Inhalt
JSON-LD ergänzt HTML um maschinenlesbare Angaben, etwa zu Artikeln, Organisationen oder Bildern. Ein solcher Datenblock wird im Browser nicht als JavaScript ausgeführt. Suchmaschinen können die Angaben auswerten; eine Nutzung durch sämtliche Vorschau- oder Assistenzdienste ist damit nicht zugesichert.
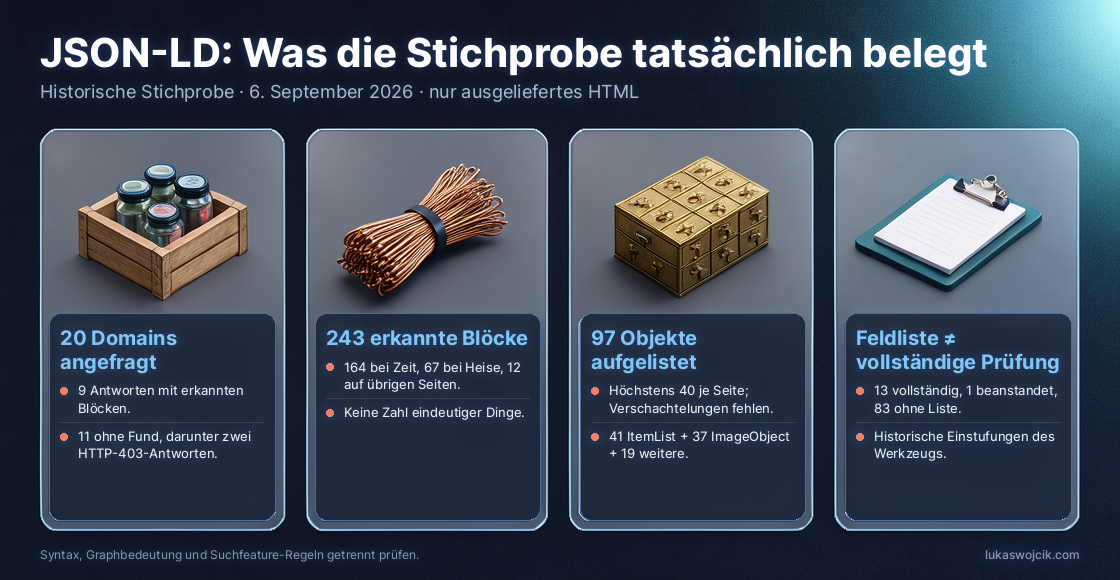
Die historische Messung vom 6. September 2026 untersuchte das ausgelieferte HTML von zwanzig Domains ohne JavaScript-Ausführung. Gefunden wurden 243 JSON-LD-Blöcke. Der begrenzte Auswerter führte daraus 97 Objekte auf.
Was ein Nichtfund bedeutet
Neun Antworten enthielten erkannte JSON-LD-Blöcke, elf nicht. Unter den elf Nichtfunden waren jedoch zwei Antworten mit HTTP 403: Stack Overflow und Allegro. Diese Sperrantworten erlauben keine Aussage über das JSON-LD der regulären Startseiten. Für die übrigen neun Antworten gilt lediglich: Im gelesenen HTML erkannte das Werkzeug keinen passenden Block.
Auch ein erfolgreicher Abruf ohne JSON-LD beweist keine fehlende Maschinenlesbarkeit. Microdata, RDFa und andere Metadaten wurden nicht untersucht. Ob JSON-LD sinnvoll ist, hängt von Inhalt und gewünschter Nutzung ab. Korrekte Strukturdaten können bestimmte Suchdarstellungen ermöglichen, garantieren aber weder eine solche Darstellung noch einen Rankingvorteil.
243 Blöcke sind keine 243 eindeutigen Dinge
Ein Block ist hier ein erkanntes <script type="application/ld+json">-Element. Ein Block kann mehrere Objekte enthalten, beispielsweise in @graph. Umgekehrt können mehrere Blöcke dasselbe Objekt über dieselbe Kennung beschreiben.
Die Zeit-Seite lieferte 164 erkannte Blöcke, Heise 67; die übrigen sieben Antworten zusammen zwölf. Der Auswerter listete pro Seite höchstens vierzig Objekte. Zeit und Heise erreichten beide diese Grenze. Verschachtelte Objekte in Eigenschaften wie author werden nicht vollständig durchlaufen; gleiche Kennungen werden nicht zusammengeführt. Die 97 Einträge sind deshalb ein Werkzeugzähler, keine vollständige Zahl eindeutiger JSON-LD-Knoten.
Welche Typen der Auswerter auflistete
Die 97 Einträge umfassen 41 ItemList, 37 ImageObject, sechs WebSite, drei Organization, drei NewsMediaOrganization, vier WebPage sowie jeweils eine CollectionPage, ProfilePage und Person. Listen und Bilder stellen damit 78 der 97 Einträge. Die Begrenzung auf frühe Objekte kann diese Verteilung erheblich beeinflussen.
ItemList beschreibt eine Liste, ImageObject ein Bild. Der Typ allein beweist weder eine festgelegte Reihenfolge noch vollständige Bildmaße oder die Zulassung zu einem Nachrichtenkarussell. Solche Aussagen benötigen passende Eigenschaften und die Regeln des konkreten Empfängers.
Drei Ebenen der Prüfung
Eine belastbare Prüfung trennt gültiges JSON, die Bedeutung nach JSON-LD und Schema.org sowie zusätzliche Anforderungen eines Suchfeatures. Die damalige Werkzeugliste meldete dreizehn Einträge als vollständig, einen Eintrag mit fehlenden Feldern und 83 ohne eigene Feldliste. Beim betroffenen WebSite-Eintrag wurden name und url beanstandet. Diese Zähler sind keine allgemeine Qualitätsfreigabe.
Die eingebauten Listen entsprechen nicht durchgehend aktuellen Google-Anforderungen. Beispielsweise nennt Google für Article derzeit empfohlene Eigenschaften und ausdrücklich keine Pflichtfelder. Das Werkzeug verlangt trotzdem unter anderem Autor, Bild und Veröffentlichungsdatum. Ein solcher Hinweis sollte gegen die aktuelle Feature-Dokumentation geprüft werden.
Kennungen, Kontext und Typen
Relative Kennungen sind in JSON-LD erlaubt. Bei der Dokumentadresse https://example.com/about verweist "@id": "#organization" auf https://example.com/about#organization, sofern keine abweichende Basis gilt. Für seitenübergreifend stabile Referenzen sind bewusst gewählte absolute Kennungen oft übersichtlicher; Fragmente sind jedoch kein grundsätzlicher Fehler.
Ein Kontext legt fest, was Feldnamen bedeuten, etwa aus welchem Begriffssystem das Feld name stammt. Der Kontext kann für enthaltene Objekte gelten und muss nicht an jedem Objekt wiederholt werden. Auch ein Objekt ohne ausdrücklichen Typ kann gültige JSON-LD-Daten enthalten. Spezielle Suchdarstellungen können trotzdem einen bestimmten Typ verlangen. Ein vollständiger JSON-LD-Prozessor löst solche Zusammenhänge auf; der einfache Werkzeugabgleich auf die Zeichenfolge schema.org ersetzt diese Verarbeitung nicht.
Datums- und Brotkrumenhinweise richtig bewerten
Datumswerte benötigen die zum Feld passende Form und bei Zeitangaben eine eindeutige Zeitzone. Ein frühes Änderungsdatum kann etwa durch Planung, Import oder falsch interpretierte Zeitzonen entstehen. Sachlich richtige Zeitpunkte sollten erhalten bleiben; ein Datum allein zur Beruhigung eines Prüfers nach vorn zu setzen wäre keine Korrektur. Der vorhandene Parser akzeptiert zudem manche ungültigen Kalendertage.
Brotkrumen zeigen die Einordnung einer Seite, etwa Startseite → Artikel → Aktueller Artikel. Für diese Angaben verlangt Google unter anderem Namen und Positionen. Beim letzten Eintrag darf das Ziel item fehlen. Eine Nummerierungslücke verdient Prüfung, beweist aber nicht, dass jeder Empfänger alle folgenden Einträge verwirft. HTML innerhalb eines Textwerts muss ebenfalls nach Eigenschaft und Empfänger beurteilt werden; eine universelle Darstellungsregel existiert nicht.
HTML auslesen, ohne Validierung vorzutäuschen
Das folgende Python-3-Beispiel liest eine lokal gespeicherte HTML-Datei in UTF-8. Ein HTML-Parser erkennt mehrzeilige Blöcke und unterschiedliche Attributreihenfolgen. Fehlerhaftes JSON wird gemeldet; spätere Blöcke werden weiter gelesen. Das Beispiel prüft nur die JSON-Syntax, führt kein JavaScript aus und verarbeitet weder Kontexte noch den vollständigen JSON-LD-Graphen.
import json
import sys
from html.parser import HTMLParser
from pathlib import Path

class Blocks(HTMLParser):
    def __init__(self):
        super().__init__(convert_charrefs=False)
        self.active = False
        self.parts = []
        self.blocks = []

    def handle_starttag(self, tag, attrs):
        if tag == "script":
            kind = dict(attrs).get("type") or ""
            self.active = kind.strip().lower() == "application/ld+json"
            self.parts = []

    def handle_data(self, data):
        if self.active:
            self.parts.append(data)

    def handle_endtag(self, tag):
        if tag == "script" and self.active:
            self.blocks.append("".join(self.parts))
            self.active = False
            self.parts = []

def invalid_constant(value):
    raise ValueError(f"Not a JSON constant: {value}")

parser = Blocks()
parser.feed(Path(sys.argv[1]).read_text(encoding="utf-8"))
parser.close()
failed = False
for number, raw in enumerate(parser.blocks, 1):
    print(f"Block {number}")
    try:
        data = json.loads(raw, parse_constant=invalid_constant)
    except ValueError as error:
        print(f"Invalid JSON: {error}", file=sys.stderr)
        failed = True
        continue
    print(json.dumps(data, ensure_ascii=False, indent=2))
print(f"Complete JSON-LD script blocks: {len(parser.blocks)}")
raise SystemExit(1 if failed else 0)
Aufruf: python3 jsonld-read.py page.html. Die Datei page.html enthält zuvor gespeichertes HTML. Nicht abgeschlossene Script-Elemente werden nicht als vollständige Blöcke ausgegeben.
Der Strukturdaten-Prüfer für JSON-LD liefert einen ersten Überblick mit den beschriebenen Grenzen. In der historischen Messung wurde außerdem die Spiegel-Antwort am HTML-Limit von 1,5 MiB gekürzt. Nachgeladene Daten fehlen in dieser Sicht grundsätzlich.
Fragen und Antworten
Müssen zusammengehörige Daten in einem einzigen Block stehen?
Nein. Die JSON-LD-Spezifikation verlangt bei der allgemeinen Verarbeitung eingebetteter Daten die Zusammenführung aller passenden Script-Blöcke. Ein gemeinsamer Graph kann die Pflege erleichtern, ist aber keine Voraussetzung für gültige Verknüpfungen. Einschränkungen einzelner Verbraucher müssen gesondert geprüft werden.
Blockiert eine strenge CSP JSON-LD?
Ein korrekt als application/ld+json deklarierter Datenblock wird nicht als Script ausgeführt und benötigt dafür keinen Script-Nonce oder Hash. JavaScript, das den Block erst erzeugt, unterliegt dagegen weiterhin der CSP.
Welche Inhalte dürfen ausgezeichnet werden?
Für Google-Suchdarstellungen müssen die Angaben relevant sein und den tatsächlichen Seiteninhalt korrekt wiedergeben. Irreführende oder versteckte ausgezeichnete Inhalte können die Eignung verhindern. Die JSON-LD-Syntax allein bewertet diese inhaltliche Übereinstimmung nicht.
Sind dynamisch erzeugte Blöcke grundsätzlich unsichtbar?
Nein. Google unterstützt auch per JavaScript erzeugte Strukturdaten. Entscheidend ist die erfolgreiche Verarbeitung beim Rendering. Ein Abruf ohne JavaScript zeigt nur den ausgelieferten Zustand; das Verhalten anderer Empfänger muss gesondert geprüft werden.
Passend dazu


