

 English
 Deutsch
 Polski
Kontrola danych strukturalnych witryny w JSON-LD: co mogą odczytać wyszukiwarki

Management Summary
Dane strukturalne opisują zawartość witryny w postaci czytelnej dla wyszukiwarek, na przykład jako artykuł, organizację lub obraz. JSON-LD to format dodawania takich opisów obok widocznej treści. Może wspierać rozszerzone wyniki wyszukiwania, ale ich nie gwarantuje. Artykuł wyjaśnia, dlaczego liczba bloków danych nie ocenia jakości. Opisy muszą odpowiadać stronie i wymaganiom odbiorcy, a ograniczone badanie może dodatkowo pominąć część informacji.
Spis treści
JSON-LD uzupełnia HTML o opisy czytelne maszynowo, na przykład artykułów, organizacji lub obrazów. Przeglądarka nie wykonuje takiego bloku danych jako JavaScript. Wyszukiwarki mogą korzystać z tych informacji; nie oznacza to obsługi przez każdy generator podglądu lub asystenta.
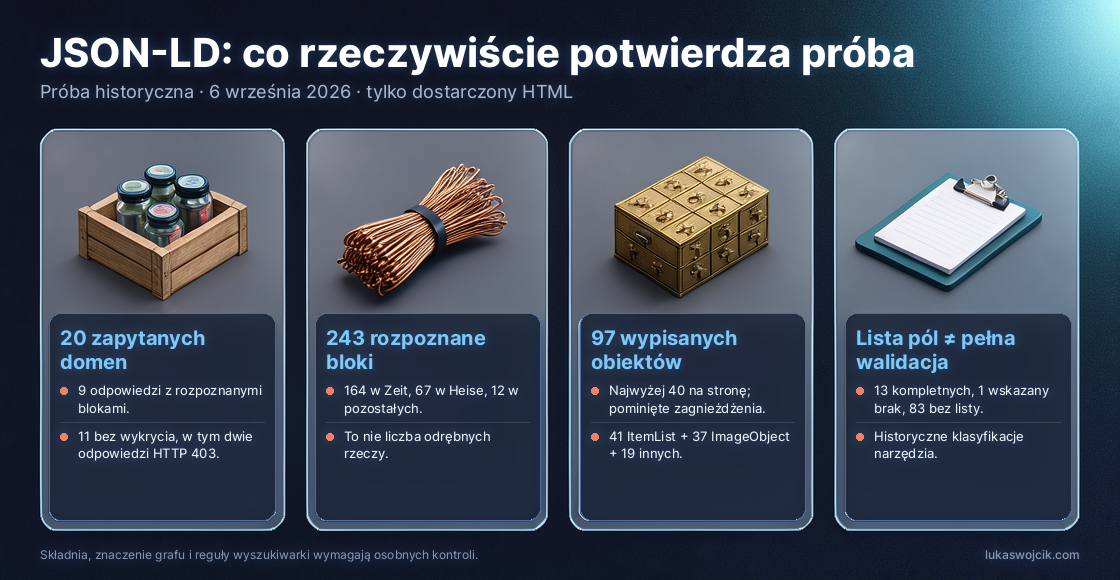
Historyczny pomiar z 6 września 2026 r. objął dostarczony HTML z dwudziestu domen, bez uruchamiania JavaScript. Wykryto 243 bloki JSON-LD. Ograniczony analizator wypisał 97 obiektów z tych bloków.
Co oznacza brak wykrycia
Dziewięć odpowiedzi zawierało rozpoznane bloki JSON-LD, a jedenaście nie. Wśród jedenastu braków znalazły się jednak odpowiedzi HTTP 403 ze Stack Overflow i Allegro. Odpowiedzi blokujące dostęp nie pozwalają określić oznaczeń na zwykłych stronach głównych. Dla pozostałych dziewięciu odpowiedzi wynik oznacza tylko brak rozpoznanego bloku w odczytanym HTML.
Nawet udane pobranie bez JSON-LD nie dowodzi braku informacji czytelnych maszynowo. Microdata, RDFa i inne metadane pozostawały poza zakresem testu. Przydatność JSON-LD zależy od treści i odbiorcy. Poprawne dane strukturalne mogą umożliwić określone formy wyników wyszukiwania, ale nie gwarantują takiej prezentacji ani poprawy pozycji.
243 bloki nie oznaczają 243 odrębnych rzeczy
Blok oznacza tutaj rozpoznany element <script type="application/ld+json">. Jeden blok może zawierać kilka obiektów, na przykład w @graph. Kilka bloków może też opisywać ten sam obiekt za pomocą wspólnego identyfikatora.
Odpowiedź Zeit zawierała 164 rozpoznane bloki, a Heise 67; pozostałe siedem odpowiedzi dostarczyło łącznie dwanaście. Analizator wypisywał najwyżej czterdzieści obiektów na stronę. Zarówno Zeit, jak i Heise osiągnęły ten limit. Obiekty zagnieżdżone we właściwościach takich jak author nie są przeglądane w pełni, a powtórzone identyfikatory nie są scalane. Liczba 97 oznacza zatem licznik narzędzia, a nie pełną liczbę odrębnych węzłów JSON-LD.
Typy w ograniczonym wyniku
Wśród 97 wpisów znajduje się 41 ItemList, 37 ImageObject, sześć WebSite, trzy Organization, trzy NewsMediaOrganization, cztery WebPage oraz po jednym CollectionPage, ProfilePage i Person. Listy i obrazy stanowią 78 z 97 wpisów. Ograniczenie odczytu do początkowych obiektów może istotnie zniekształcać ten rozkład.
ItemList opisuje listę, a ImageObject obraz. Sam typ nie dowodzi ustalonej kolejności, kompletnych wymiarów obrazu ani kwalifikacji do karuzeli wiadomości. Takie wnioski wymagają odpowiednich właściwości oraz reguł konkretnego odbiorcy.
Trzy osobne warstwy walidacji
Rzetelna kontrola rozróżnia poprawny JSON, znaczenie według JSON-LD i Schema.org oraz dodatkowe wymagania funkcji wyszukiwarki. Historyczna lista narzędzia oznaczyła trzynaście wpisów jako kompletne, jeden jako niekompletny, a 83 jako pozbawione osobnej listy kontrolnej. We wskazanym wpisie WebSite zgłoszono brak name i url. Te liczniki nie stanowią ogólnego potwierdzenia jakości.
Wbudowane listy nie odpowiadają w pełni aktualnym wymaganiom Google. Na przykład dokumentacja Article podaje obecnie właściwości zalecane i wyraźnie stwierdza brak właściwości wymaganych. Narzędzie mimo to żąda między innymi autora, obrazu i daty publikacji. Takie wskazanie wymaga porównania z aktualną dokumentacją funkcji.
Identyfikatory, konteksty i typy
JSON-LD dopuszcza identyfikatory względne. Przy adresie dokumentu https://example.com/about zapis "@id": "#organization" wskazuje https://example.com/about#organization, o ile nie obowiązuje inna baza. Świadomie wybrane identyfikatory bezwzględne często upraszczają trwałe odwołania między stronami; sam fragment nie jest jednak błędem.
Kontekst określa znaczenie nazw pól, na przykład wskazuje słownik definiujący pole name. Może obejmować zawarte obiekty bez powtarzania przy każdym obiekcie. Obiekt bez jawnego typu również może zawierać poprawne dane JSON-LD, choć konkretna prezentacja w wyszukiwarce może wymagać określonego typu. Pełny procesor JSON-LD rozwiązuje te zależności; proste wyszukiwanie ciągu schema.org w narzędziu nie zastępuje takiego przetwarzania.
Ocena dat i ostrzeżeń o okruszkach
Daty wymagają formatu właściwego dla pola, a znaczniki czasu także jednoznacznej strefy czasowej. Wcześniejsza data zmiany może wynikać z planowania publikacji, importu lub błędnej interpretacji stref. Prawdziwe daty powinny pozostać prawdziwe; przesunięcie daty tylko w celu usunięcia ostrzeżenia nie jest naprawą. Obecny parser akceptuje ponadto niektóre niepoprawne daty kalendarzowe.
Okruszki nawigacyjne pokazują miejsce strony w hierarchii, na przykład Strona główna → Artykuły → Bieżący artykuł. Wymagania Google obejmują między innymi nazwy i pozycje tych elementów. Ostatni wpis może pomijać cel item. Luka w numeracji wymaga sprawdzenia, ale nie dowodzi odrzucania wszystkich dalszych wpisów przez każdego odbiorcę. HTML w wartości tekstowej również wymaga oceny zależnej od właściwości i odbiorcy, zamiast uniwersalnej reguły prezentacji.
Odczyt HTML bez pozorowania pełnej walidacji
Poniższy przykład dla Python 3 czyta lokalnie zapisany plik HTML w UTF-8. Parser HTML obsługuje bloki wielowierszowe i różną kolejność atrybutów. Niepoprawny JSON jest zgłaszany, a kolejne bloki nadal przetwarzane. Przykład sprawdza wyłącznie składnię JSON: nie wykonuje JavaScript i nie przetwarza kontekstów ani pełnego grafu JSON-LD.
import json
import sys
from html.parser import HTMLParser
from pathlib import Path

class Blocks(HTMLParser):
    def __init__(self):
        super().__init__(convert_charrefs=False)
        self.active = False
        self.parts = []
        self.blocks = []

    def handle_starttag(self, tag, attrs):
        if tag == "script":
            kind = dict(attrs).get("type") or ""
            self.active = kind.strip().lower() == "application/ld+json"
            self.parts = []

    def handle_data(self, data):
        if self.active:
            self.parts.append(data)

    def handle_endtag(self, tag):
        if tag == "script" and self.active:
            self.blocks.append("".join(self.parts))
            self.active = False
            self.parts = []

def invalid_constant(value):
    raise ValueError(f"Not a JSON constant: {value}")

parser = Blocks()
parser.feed(Path(sys.argv[1]).read_text(encoding="utf-8"))
parser.close()
failed = False
for number, raw in enumerate(parser.blocks, 1):
    print(f"Block {number}")
    try:
        data = json.loads(raw, parse_constant=invalid_constant)
    except ValueError as error:
        print(f"Invalid JSON: {error}", file=sys.stderr)
        failed = True
        continue
    print(json.dumps(data, ensure_ascii=False, indent=2))
print(f"Complete JSON-LD script blocks: {len(parser.blocks)}")
raise SystemExit(1 if failed else 0)
Wywołanie: python3 jsonld-read.py page.html. Plik page.html zawiera wcześniej zapisany HTML. Niedomknięte elementy script nie są wypisywane jako kompletne bloki.
Walidator danych strukturalnych JSON-LD na żywo zapewnia wstępny przegląd z opisanymi ograniczeniami. W historycznym pomiarze odpowiedź Spiegel została dodatkowo przycięta przy limicie HTML wynoszącym 1,5 MiB. Dane dodane po załadowaniu pozostają poza tym widokiem.
Pytania i odpowiedzi
Czy powiązane dane muszą znajdować się w jednym bloku?
Nie. Ogólne przetwarzanie osadzonych danych według specyfikacji JSON-LD wymaga połączenia wszystkich pasujących bloków script. Wspólny graf może ułatwiać utrzymanie, ale nie jest warunkiem poprawnych powiązań. Ograniczenia poszczególnych odbiorców wymagają osobnej kontroli.
Czy restrykcyjna CSP blokuje JSON-LD?
Blok danych poprawnie oznaczony jako application/ld+json nie jest wykonywany jako skrypt i nie wymaga w tym celu nonce ani skrótu skryptu. JavaScript tworzący taki blok nadal podlega CSP.
Jaką treść wolno oznaczać?
Dla funkcji wyszukiwarki Google opisy muszą być istotne i poprawnie odzwierciedlać rzeczywistą zawartość strony. Myląca lub ukryta oznaczona treść może wykluczyć kwalifikację. Sama składnia JSON-LD nie potwierdza takiej zgodności.
Czy bloki generowane dynamicznie zawsze pozostają niewidoczne?
Nie. Google obsługuje również dane strukturalne tworzone przez JavaScript. Znaczenie ma skuteczne przetwarzanie podczas renderowania. Pobranie bez JavaScript pokazuje tylko stan dostarczony przez serwer; działanie innych odbiorców wymaga osobnego sprawdzenia.
Powiązane artykuły


