

 English
 Deutsch
 Polski
Dobór rozmiaru fragmentów do wyszukiwania AI: testowanie na przykładowych pytaniach

Management Summary
Wyszukiwanie dokumentów przez AI korzysta z fragmentów tekstu zamiast koniecznie czytać cały zbiór przy każdym pytaniu. Rozmiar fragmentów i powtarzanie treści między sąsiadami wpływają na odnajdywanie wyjaśnień, szybkość oraz koszty. Porównanie podziałów za pomocą typowych pytań pomaga znaleźć równowagę dla rzeczywistych dokumentów. Duże fragmenty mogą zawierać zbędne informacje, a powtórzenia zwiększają pracę. Znalezienie właściwego źródła nadal nie oznacza automatycznie poprawnej odpowiedzi.
Spis treści
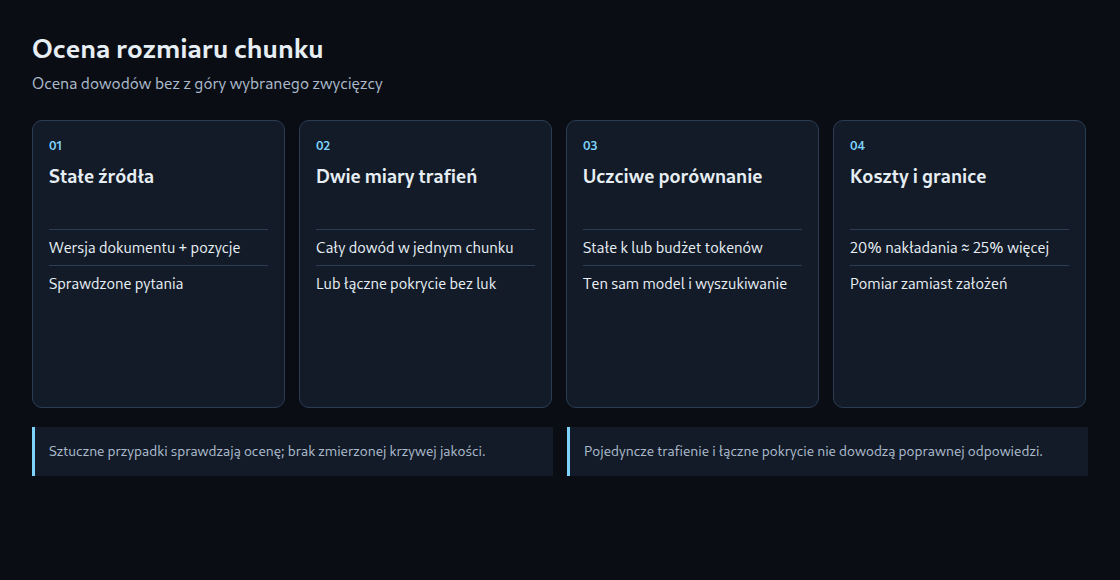
Chunk to fragment źródła przechowywany jako jednostka wyszukiwania. Nakładanie oznacza, że sąsiednie chunki powtarzają część tego samego tekstu źródłowego. Rozmiar chunku wpływa na ilość przydatnych dowodów i pobocznego tekstu przekazywanego do modelu odpowiedzi. Nie istnieje uniwersalnie najlepszy rozmiar ani stopień nakładania. Porównanie wymaga stałych źródeł, sprawdzonych pytań i jasno określonego kryterium sukcesu.
Ten poradnik ocenia znalezione dowody bez generowania odpowiedzi. Modele embeddingowe, budowa indeksu i wyszukiwanie nadal zużywają zasoby i mogą kosztować. Przykład w Pythonie działa lokalnie na sztucznych listach wyników. Jest modułem oceny, a nie kompletnym systemem osadzania tekstu.
Utrwalenie źródeł i oznaczenie dowodów
Każde pytanie otrzymuje identyfikator, treść, identyfikator niezmiennej wersji dokumentu oraz sprawdzony zakres dowodu. Zakres używa pozycji znaków Pythona: początek włącznie, koniec wyłącznie. Zapisany cytat musi dokładnie odpowiadać temu wycinkowi utrwalonego źródła. Pozycje bajtów, UTF-16 i tokenów są innymi układami współrzędnych.
Pozycje powstają po ekstrakcji i normalizacji tekstu, lecz przed podziałem. Każdy chunk zachowuje identyfikator wersji dokumentu i zakres źródłowy. Wyszukiwanie samego cytatu mogłoby uznać identyczne zdanie z innego dokumentu lub innego miejsca. Dalsze zmiany tekstu wymagają wiarygodnego odwzorowania na te współrzędne.
Pytania syntetyczne mogą uzupełniać pierwszy zestaw. Generowanie z całych dokumentów nie usuwa jednak podobieństwa do słownictwa źródła. Ręczna kontrola sprawdza możliwość udzielenia odpowiedzi, dowód, parafrazę i pokrycie zadań. Rzeczywiste zapytania dodają przydatne przypadki, z uwzględnieniem prywatności i jakości oznaczeń. Pytania bez odpowiedzi lub wymagające kilku dokumentów potrzebują osobnych reguł. Poniższy przykład obejmuje jeden ciągły zakres dowodu na pytanie z odpowiedzią.
Wybór miary przed porównaniem
Single-span hit@k oznacza tutaj udział pytań, których pełny dowód mieści się w co najmniej jednym z pierwszych k chunków. Union hit@k dopuszcza kilka wyników z tej samej wersji dokumentu, jeśli ich zakresy pokrywają dowód bez luk. Druga miara wykrywa rozdzielone dowody, ale nie potwierdza prawidłowej rekonstrukcji przez model odpowiedzi.
Single-span MRR@k to średnia odwrotność pozycji pierwszego chunku zawierającego cały dowód, z zerem przy braku trafienia. Pełne trafienie na pozycji 1 wnosi 1, na pozycji 2 wartość 0,5, a na pozycji 4 wartość 0,25. Są to jawnie zdefiniowane miary dla tego schematu oznaczeń. Recall ogólnie opisuje, jaka część wszystkich istotnych jednostek została znaleziona. Trafienie w jedną jednostkę nie oznacza odzyskania kilku wymaganych fragmentów dowodowych.
Trzydzieści lub pięćdziesiąt pytań może służyć jako pilotaż, ale nie jest uniwersalnie wystarczającą próbą. Zmiana jednego wyniku oznacza 3,33 punktu procentowego przy 30 pytaniach i 2 punkty przy 50. Małe różnice wymagają większej liczby dowodów, porównań dla poszczególnych pytań i właściwej analizy niepewności. Odłożony zestaw testowy oddziela wielokrotne strojenie od niezależnej oceny.
Niewielki działający moduł oceny
Plik korzysta wyłącznie z biblioteki standardowej Pythona i uruchamia się poleceniem python3 evaluate.py. Wyniki zachowują kolejność wyszukiwania. Pusta lista oznacza zakończone wyszukiwanie bez wyników, natomiast brak listy jest błędem. Powtórzone zakresy, nieprawidłowe pozycje i cytaty niezgodne ze źródłem są odrzucane.
def evaluate(questions, rankings, corpus, k=5):
    # corpus keys identify immutable document versions.
    if type(k) is not int or k < 1 or not questions:
        raise ValueError("positive k and nonempty questions required")
    def valid_span(s):
        doc, start, end = s
        if (doc not in corpus or type(start) is not int
                or type(end) is not int
                or not 0 <= start < end <= len(corpus[doc])):
            raise ValueError("invalid source span")
        return doc, start, end
    hits, union_hits, reciprocal = 0, 0, 0.0
    seen = set()
    for q in questions:
        if q["id"] in seen:
            raise ValueError("duplicate question id")
        seen.add(q["id"])
        doc, start, end = valid_span(q["evidence"])
        if q["quote"] != corpus[doc][start:end]:
            raise ValueError("quote does not match the source span")
        # A missing result is not silently treated as an empty ranking.
        rows = rankings[q["id"]]
        if len({tuple(c) for c in rows}) != len(rows):
            raise ValueError("duplicate retrieved span")
        rows = [valid_span(c) for c in rows]
        top = rows[:k]
        rank = next((n for n, (d, a, b) in enumerate(top, 1)
                     if d == doc and a <= start and b >= end), None)
        if rank is not None:
            hits += 1
            reciprocal += 1 / rank
        # Union coverage: adjacent intervals may cover a split sentence.
        cursor = start
        spans = sorted((max(a, start), min(b, end)) for d, a, b in top
                       if d == doc and a < end and b > start)
        for a, b in spans:
            if a > cursor:
                break
            cursor = max(cursor, b)
        union_hits += cursor >= end
    n = len(questions)
    return {"single_hit_at_k": hits / n,
            "union_hit_at_k": union_hits / n,
            "single_mrr_at_k": reciprocal / n}

if __name__ == "__main__":
    corpus = {"manual-v1": "AA BBBB CC", "other-v1": "AA BBBB CC"}
    questions = [{"id": "q1", "evidence": ["manual-v1", 3, 7],
                  "quote": "BBBB"}]
    rankings = {"q1": [("other-v1", 0, 10),
                       ("manual-v1", 0, 5),
                       ("manual-v1", 5, 10)]}
    print(evaluate(questions, rankings, corpus, k=3))
    # single_hit_at_k: 0.0, union_hit_at_k: 1.0, single_mrr_at_k: 0.0
Sztuczny przykład zwraca Single-span hit 0, Union hit 1 oraz Single-span MRR 0. Pierwszy wynik zawiera ten sam tekst w innym dokumencie i nie jest zaliczany. Kolejne dwa wyniki wspólnie pokrywają właściwy zakres. Te wartości sprawdzają moduł oceny, a nie jakość modelu embeddingowego.
Podłączenie rzeczywistego wyszukiwania
Dla każdej konfiguracji system dzieli ten sam utrwalony zbiór, tworzy embeddingi, buduje osobny indeks i zwraca uporządkowane zakresy źródłowe dla każdego pytania. Adapter musi odwzorować każdy znaleziony chunk na pierwotny zakres. Przykład nie dostarcza tokenizera, mechanizmu dzielenia, klienta embeddingów ani indeksu wyszukiwania.
Cztery przykładowe rozmiary: 256, 512, 1024 i 2048 tokenów, każdy bez nakładania lub z nakładaniem 20%, dają osiem konfiguracji. Rozmiary muszą mieścić się w limitach wybranego modelu i tokenizera. Ciche obcięcie wejścia może sprawić, że wektor reprezentuje mniej tekstu niż zapisany chunk. Takie obcinanie wymaga wyłączenia, jeśli jest to obsługiwane, albo wykrycia i uznania konfiguracji za nieudaną.
Wersja modelu, ustawienia dla pytania i dokumentu, ekstrakcja, funkcja podobieństwa, filtry i parametry wyszukiwania pozostają stałe. Embeddingi pytań można wykorzystać ponownie przy identycznych pełnych wejściach i ustawieniach modelu. Ta sama zasada dotyczy dokumentów. Zmiana modelu wymaga nowego porównania.
Porównanie jakości, kontekstu i kosztu
Przy stałym k większe chunki mogą przekazać więcej tekstu. Iloczyn k × rozmiar chunku to tylko nominalna granica dla pełnych fragmentów. Krótkie końcówki, dodatkowe opisy, usuwanie powtórzeń i obcinanie zmieniają długość promptu. Porównanie ze stałym budżetem liczy gotowy kontekst tokenizerem modelu odpowiedzi i stosuje taką samą regułę pakowania dla każdej konfiguracji.
Dla długiego tekstu dzielonego stałymi oknami mnożnik liczby tokenów przy udziale nakładania r zbliża się do 1 / (1 - r). Przy r = 0,20 daje to 1,25: około 25% dodatkowych tokenów, a nie 20%. Cztery przebiegi bez nakładania i cztery z nakładaniem 20% dla dwóch milionów tokenów dają więc około 18 milionów tokenów dokumentów do osadzenia. Granice dokumentów i zaokrąglenia zmieniają dokładny wynik. Embeddingi pytań, indeks, przechowywanie i praca przy ocenie to dodatkowe koszty.
Przydatna tabela wyników obejmuje konfigurację, liczbę pytań, obie miary trafień, MRR, rzeczywiste tokeny kontekstu, tokeny embeddingów, rozmiar indeksu i opóźnienie. Ten poradnik nie przedstawia zmierzonej krzywej jakości. Rekomendacji 512 tokenów nie da się uzasadnić bez identyfikowalnego zbioru, oznaczeń i wyników przebiegu. Podział według struktury jest kolejnym kandydatem, a nie automatycznym zwycięzcą.
Osobna ocena całego procesu odpowiedzi
Przy ponownym rankingowaniu pokrycie dowodów ma znaczenie zarówno w zbiorze kandydatów, jak i po zmianie kolejności oraz spakowaniu kontekstu. Wysoki wynik pierwszego etapu nie gwarantuje zachowania dowodu w końcowych pięciu chunkach. Gotowa odpowiedź wymaga również sprawdzenia warunków, źródeł i niepopartych twierdzeń.
Ponowna ocena następuje po istotnych zmianach dokumentów, pytań, modeli lub przetwarzania. Ani coroczny termin, ani z góry ustalony czas kontroli nie gwarantuje pokrycia. Wersjonowane pytania i wyniki dla każdego zapytania ułatwiają wykrywanie pogorszenia.
Pytania i odpowiedzi
Dlaczego nakładanie 20% kosztuje o jedną czwartą więcej tokenów, a nie o jedną piątą?
Ponieważ nakładanie skraca krok, a nie wydłuża okno. Okno o rozmiarze w przesuwa się przy udziale nakładania r za każdym razem tylko o w × (1 − r). Tekst o długości L wymaga więc około L / (w × (1 − r)) okien, a każde z nich zawiera w tokenów. Łącznie daje to L / (1 − r) tokenów.
Przy r = 0,2 współczynnik wynosi 1,25. Narzut rośnie szybciej niż nakładanie: przy 50% liczba tokenów się podwaja, a przy 75% rośnie czterokrotnie. Dla rachunku z artykułu oznacza to, że cztery przebiegi bez nakładania osadzają 8 milionów tokenów, a cztery z nakładaniem 20% po 2,5 miliona, czyli 10 milionów; łącznie około 18 milionów.
Kiedy przewagę jednej konfiguracji w zestawie testowym da się odróżnić od przypadku?
Decydują o tym pytania, przy których obie konfiguracje dają różny wynik, a nie różnica wskaźników trafień. Pytania, przy których obie znajdują dowód albo obie go nie znajdują, nic nie mówią o różnicy.
Przyjęty przykład z 50 pytaniami: konfiguracja A znajduje dowód przy czterech pytaniach, przy których B go nie znajduje, a B przy jednym pytaniu, przy którym zawodzi A. A prowadzi więc o trzy pytania, czyli o 6 punktów procentowych. Gdyby obie były równie dobre, każde z tych pięciu pytań z jednakowym prawdopodobieństwem przypadłoby A lub B. Wynik co najmniej 4 do 1 dla A ma wtedy prawdopodobieństwo 6/32, czyli nieco poniżej 19 procent; po uwzględnieniu równie wyraźnego wyniku na korzyść B jest to 37,5 procent. Taką przewagę łatwo wyjaśnić przypadkiem.
Ten rachunek to test znaków na rozbieżnych pytaniach. Zakłada on, że pytania są od siebie niezależne. Jeśli wiele pytań pochodzi z tego samego dokumentu, rzeczywista niepewność jest większa, niż pokazuje rachunek. Wykazanie małych różnic wymaga znacznie większej liczby rozbieżnych pytań.
Co dzieje się z zestawem testowym, gdy zmienia się dokument źródłowy?
Pytania, których to dotyczy, potrzebują nowych zakresów dowodu w nowej wersji, która otrzymuje własny identyfikator wersji dokumentu. Jeśli natomiast tekst zostanie podmieniony pod starym identyfikatorem, zapisane pozycje wskażą inny tekst, a skrypt z artykułu przerwie działanie komunikatem „quote does not match the source span”, zamiast po cichu liczyć błędnie. Wyniki są porównywalne tylko wtedy, gdy wszystkie konfiguracje działają na tym samym stanie zbioru.
Źródła
Powiązane artykuły


