English
 Deutsch
 Polski
Conversational Analytics in Looker: Tokenpool und Kostenplanung

Inhalt
Conversational Analytics beantwortet Fragen zu Looker-Daten in natürlicher Sprache. Die Kosten lassen sich nicht allein aus der sichtbaren Antwortlänge ableiten. Ausgangspunkt sind die gemessenen Eingabe- und Ausgabetoken der Instanz sowie die geltenden Vertrags- und Abrechnungsbedingungen. Ein Token ist eine Verarbeitungseinheit für Text oder Daten und entspricht keiner festen Wortzahl.
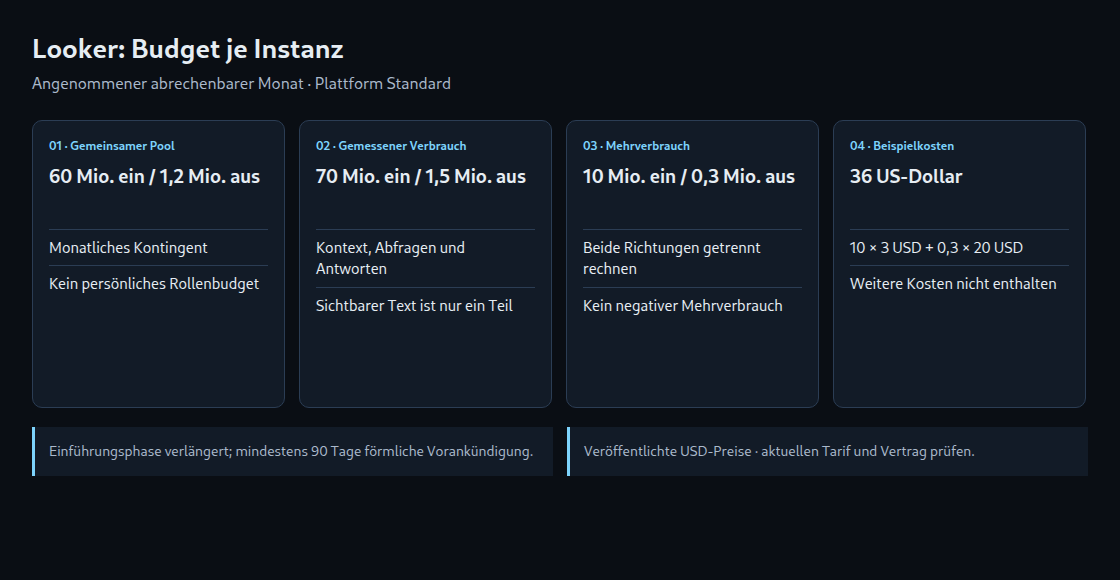
Aktualisiert am 24. Oktober 2026: Google hat den Einführungszeitraum ohne Mehrverbrauchsgebühren innerhalb der Fair-Use-Grenzen verlängert. Die aktuelle Preisseite sagt mindestens 90 Tage förmliche Vorankündigung vor Kontingentdurchsetzung und Abrechnung zu. Der zuvor genannte feste Start am 1. Oktober ist deshalb keine belastbare Planungsgrundlage mehr.
Ein gemeinsames Kontingent je Instanz
Das veröffentlichte Monatskontingent steht den angemeldeten Nutzern einer Instanz gemeinsam zur Verfügung. Es ist kein persönliches Viewer-, Standard- oder Developer-Kontingent. Unverbrauchte Mengen werden weder in den nächsten Monat noch auf andere Data-Cloud-Produkte übertragen.
| Plattform / Instanz | Eingabe / Monat | Ausgabe / Monat |
|---|---|---|
| Standard | 60 000 000 | 1 200 000 |
| Enterprise / Advanced | 300 000 000 | 6 000 000 |
| Embed / Elite | 1 200 000 000 | 24 000 000 |
| Nichtproduktion / Zusatzinstanz | 6 000 000 | 120 000 |
Standard bezeichnet in dieser Tabelle die Plattformstufe, nicht die Standard-Nutzerlizenz. Ein zusätzlicher Nutzer oder eine geänderte Nutzerrolle vergrößert diesen Pool nicht automatisch. Berechtigungen sollten zur jeweiligen Aufgabe passen.
Was die Messwerte enthalten
Zur Eingabe zählen Frage, Gesprächsverlauf und bereitgestellter Kontext. Die Ausgabe kann erzeugte SQL- oder API-Aufrufe, Diagramme und weitere Inhalte neben Fließtext enthalten. Eine sichtbare Zusammenfassung mit 300 Token belegt deshalb keine Gesamtausgabe von 300 Token.
Der Reiter Token usage in System Activity zeigt geschätzte Ein- und Ausgabemengen, aufgeschlüsselt nach Agent, Nutzer und Gespräch. Die aktuelle Dokumentation nennt sechs Stunden Synchronisationsverzug. Die Kennzeichnung der Gesprächsoberfläche beginnt mit der aktivierten Funktion in Looker 26.14 und erfolgt nicht rückwirkend. Eine ältere Zeile ohne diese Kennzeichnung beweist keinen fehlenden Verbrauch.
Eine Kostenrechnung mit klaren Annahmen
Die veröffentlichten Mehrverbrauchspreise betragen 3 US-Dollar je Million Eingabetoken und 20 US-Dollar je Million Ausgabetoken. Die folgende Rechnung beschreibt einen angenommenen abrechenbaren Monat nach Beginn der Kontingentdurchsetzung. Das ist weder eine aktuelle Rechnung noch eine vollständige Looker-Kostenschätzung.
Mehrverbrauch Eingabe = max(0, Monatseingabe - Eingabekontingent)
Mehrverbrauch Ausgabe = max(0, Monatsausgabe - Ausgabekontingent)
Mehrkosten in USD     = 3 × Mehrverbrauch Eingabe / 1.000.000
                      + 20 × Mehrverbrauch Ausgabe / 1.000.000
Eine Standard-Instanz verbraucht angenommen 70 Millionen Eingabe- und 1,5 Millionen Ausgabetoken. Über dem Kontingent liegen 10 Millionen Eingabe- und 300.000 Ausgabetoken: 30 plus 6 ergibt 36 US-Dollar. Plattform- und Nutzerlizenzen, Datenbankkosten sowie weitere getrennt berechnete Dienste sind darin nicht enthalten.
Zwanzig Zusammenfassungen täglich über 30 Tage mit angenommenen 300 gesamten Ausgabetoken je Zusammenfassung ergeben 180.000 Ausgabetoken. Das sind 15 Prozent des Standard-Ausgabepools, nicht automatisch 3,20 Dollar persönlicher Mehrverbrauch. Ohne sonstigen Verbrauch bleibt die Ausgabe unter dem Kontingent. Bei bereits verbrauchten 1,1 Millionen Ausgabetoken erreicht dieselbe Routine insgesamt 1,28 Millionen und damit 1,60 Dollar Ausgabemehrkosten. Die Eingabe benötigt weiterhin eine eigene Rechnung.
Die Aufgabe optimieren, nicht nur die Textlänge
Eine kurze Frage kann umfangreichen Kontext und erzeugte Abfragen benötigen. Eine lange Antwort ist nicht automatisch der größte Kostenfaktor. Aus dem Kontingentverhältnis 50:1 folgt nicht, welcher Pool zuerst erschöpft wird. Dafür zählt der tatsächliche Verbrauch.
Klare Felddefinitionen, fachlich eingegrenzte Explores und knappe Agentenanweisungen können unnötigen Kontext und Mehrdeutigkeit reduzieren. Die Optimierung von Datenbankabfragen bleibt für Laufzeit und Datenbankaufwand relevant. Der Einfluss auf Datentoken benötigt eine Messung; „Abfrageoptimierung ändert nichts“ ist zu pauschal.
Für Explore-Gespräche empfiehlt Google überwiegend den Fast-Modus. Thinking benötigt zusätzliche Token für sichtbare Denkschritte, ohne einen dokumentierten Genauigkeitsvorteil gegenüber Fast. Die Auswahl sollte dem Untersuchungszweck folgen; eine ausführlichere Antwort ist nicht zwangsläufig richtiger.
Fragen und Antworten
Sind regelmäßige Zusammenfassungen grundsätzlich Verschwendung?
Nein. Ein fester Bericht oder eine Vorlage passt zu stabilen, vorab definierten Ausgaben. Eine anpassungsfähige Zusammenfassung kann bei wechselnden Auffälligkeiten oder Fragestellungen nützlich sein. Looker dokumentiert geplante Agentenabläufe als Vorschaufunktion. Ein sinnvoller Vergleich berücksichtigt nachgewiesenen Nutzen, Tokenverbrauch, Wartung und menschlichen Prüfaufwand.
Bringt eine höhere Nutzerrolle mehr Token?
Das veröffentlichte Modell weist den Pool nach Instanz und Plattformabonnement zu. Ein Rollenwechsel ist deshalb keine Tokensparstrategie. Individuelle Vertragsbedingungen sind zusätzlich zu prüfen.
Was gehört in die Budgetgrundlage?
Instanz und Tarifstufe, Messzeitraum, getrennte Eingabe- und Ausgabesummen, verzögerte oder fehlende Messwerte, geplante Abläufe und die maßgebliche förmliche Abrechnungsankündigung. Ein repräsentativer Testlauf ist belastbarer als eine aus geschätzten Wortzahlen abgeleitete Garantie kostenloser Antworten.
Passend dazu