English
 Deutsch
Mac Studio M5 als AI-Schmiede: M5 Max, M5 Ultra und Mac mini M6 im LLM-Vergleich

Inhalt
Ein Mac Studio kann eine lokale AI-Workstation sein, wenn große Modelle, ein kompakter Arbeitsplatz und ein passender Apple-Backend wichtiger sind als austauschbare Grafikkarten. Die Entscheidung beginnt beim Speicherbudget, nicht beim neuesten Chipnamen.
Apples aktuelle Produktzuordnung ist eindeutig: Mac Studio mit M5 Max oder M5 Ultra, Mac mini mit M6 beziehungsweise M5 Pro. Ein Mac Studio M6 ist damit kein dokumentiertes Vergleichsgerät. Die folgenden Daten sind Spezifikationen, keine eigenen Inferenzbenchmarks.
Drei konkrete Apple-Profile
| Gerät | Unified Memory | Dokumentierte Bandbreite |
|---|---|---|
| Mac mini M6 | 16 bis 32 GB | 153 beziehungsweise 170 GB/s |
| Mac Studio M5 Max | 36 bis 128 GB | 460 beziehungsweise 614 GB/s |
| Mac Studio M5 Ultra | 96 bis 512 GB | 1,2 TB/s |
Die Werte gehören zu unterschiedlichen Konfigurationen; Maximalwerte sind nicht in jeder Grundausführung enthalten. Der jüngere M6-Name macht den kleinen Mac mini deshalb nicht zur größeren Modellplattform. Für Modellgewichte zählt zunächst die tatsächlich bestellte Kapazität.
Unified Memory ist ein gemeinsames Budget
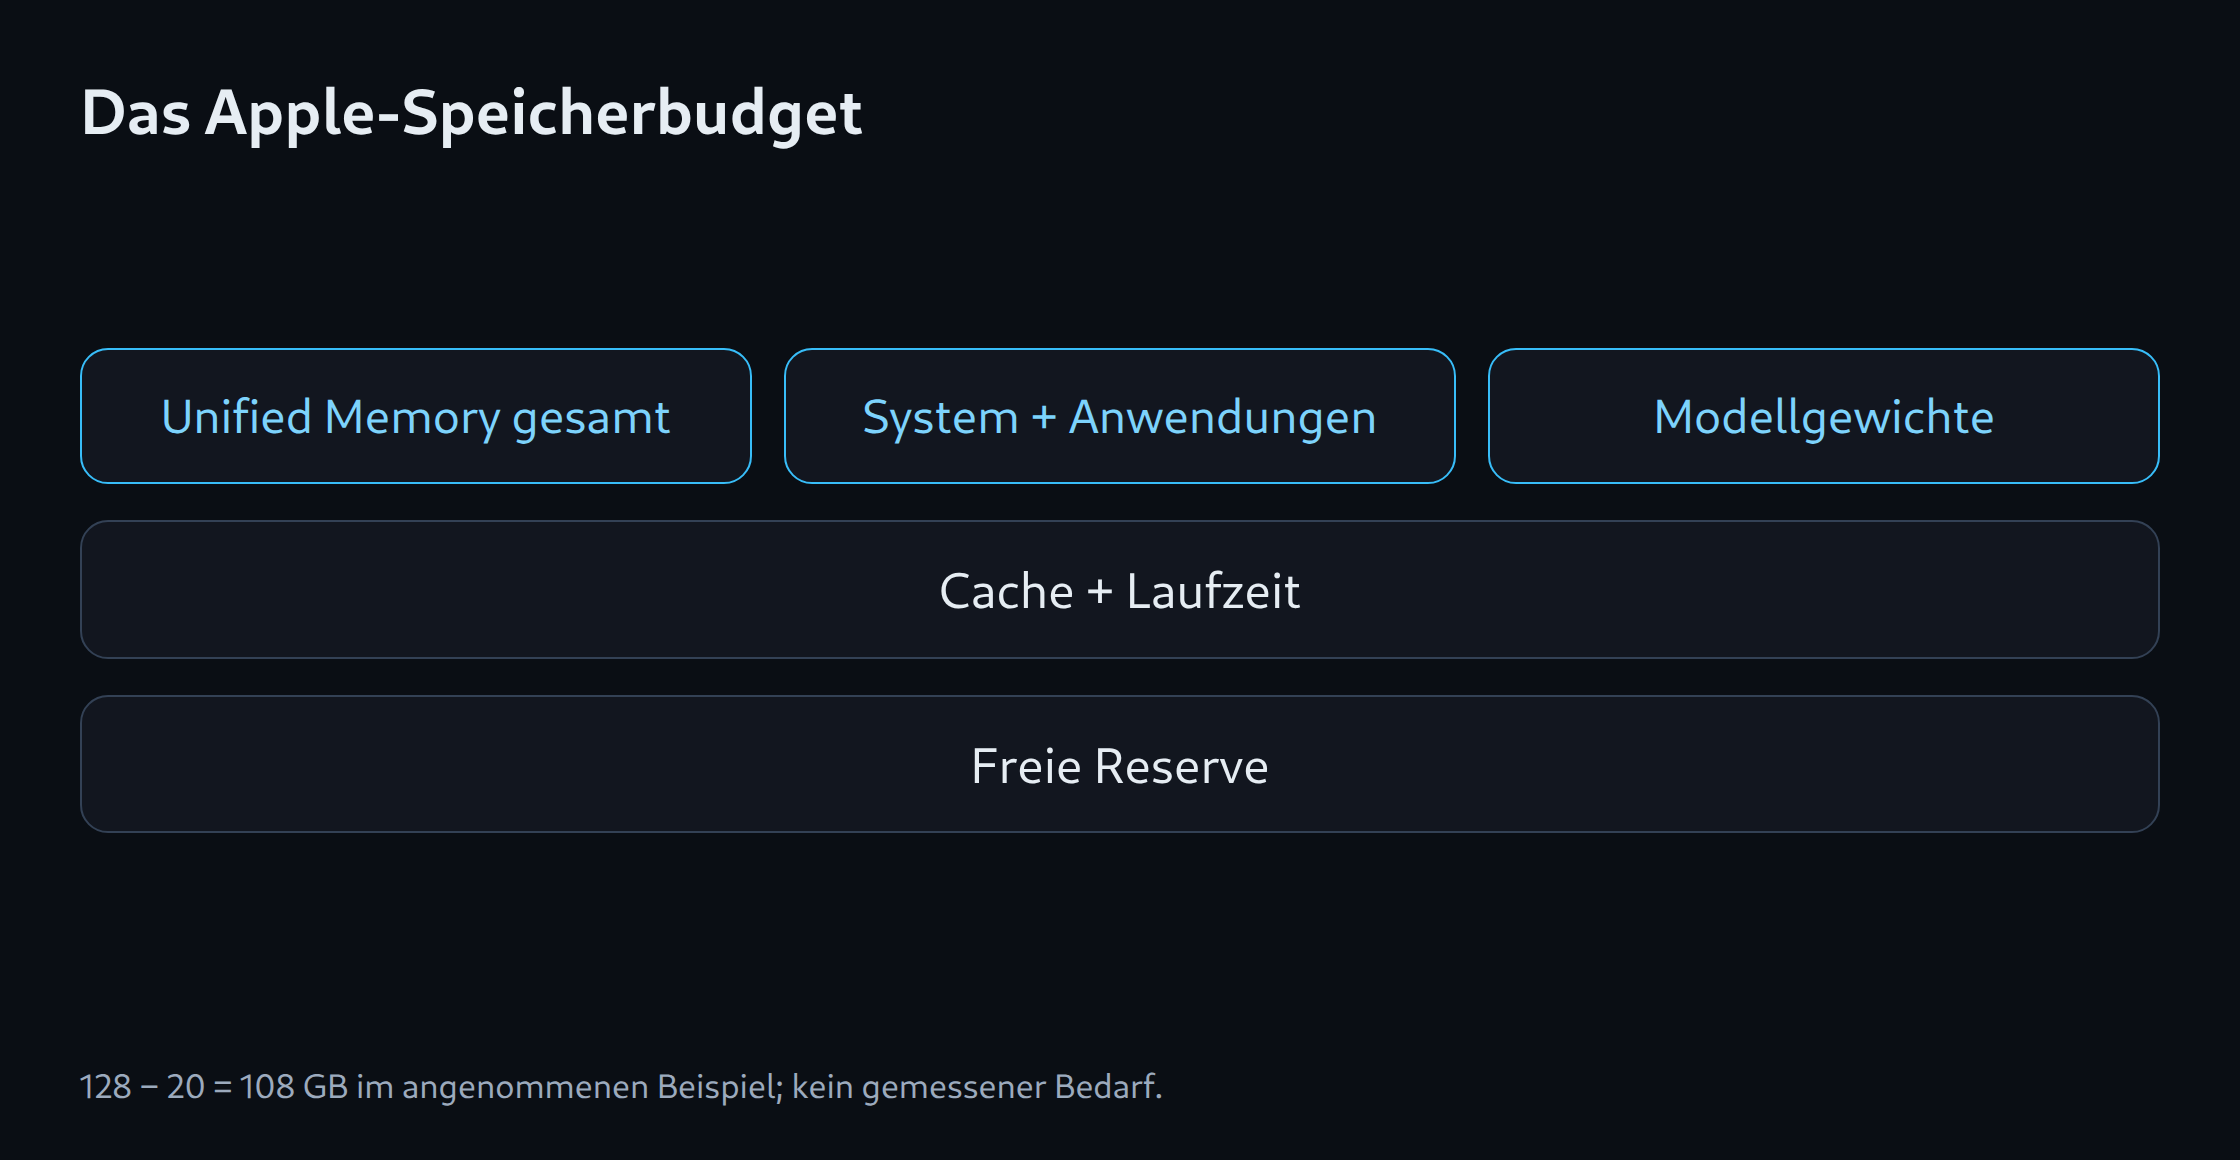
CPU, GPU, Betriebssystem und Anwendungen greifen auf denselben Speicherbereich zu. 512 GB Gesamtkapazität bedeuten nicht 512 GB frei reservierbaren Modellplatz. Modellzustand, Cache und temporäre Puffer kommen neben den Gewichten hinzu. Andere Anwendungen verändern die Reserve.
Ein angenommenes Budget von 128 GB mit 20 GB reserviertem Systembedarf lässt rechnerisch 108 GB für Modell und Laufzeit. Die 20 GB sind eine Planannahme, kein gemessener oder vorgeschriebener Apple-Wert. Ein dauerhaft laufender Dienst braucht eine reale Belegungsmessung unter typischer Last.
MLX, llama.cpp und Ollama
MLX LM bietet einen Apple-Silicon-Pfad. llama.cpp unterstützt Apple Silicon mit Metal und weiteren CPU-Optimierungen. Ollama dokumentiert ebenfalls Apple-Unterstützung und entwickelt die Backends weiter. Der aktuelle Runtime-Stand entscheidet, welches Modellformat und welche Beschleunigung tatsächlich verwendet werden.
Eine MLX-Quantisierung und ein GGUF-Artefakt bleiben unterschiedliche Dateien. Ein Vergleich braucht dieselbe Ausgangsrevision, passende Chat-Templates und nachvollziehbare Präzision. Ohne diese Angaben lässt sich eine veränderte Antwort nicht sicher auf den Backend-Wechsel zurückführen.
Neural Engine und GPU-Beschleunigung unterscheiden
Apple nennt Neural Accelerators innerhalb der GPU sowie eine Neural Engine. Beide Begriffe dürfen nicht gleichgesetzt werden. Ein LLM-Programm nutzt die dokumentierte Hardwarefunktion nur über einen passenden Softwarepfad. Die Zahl der Neural-Engine-Kerne liefert allein keinen Beleg für höhere Tokens-pro-Sekunde-Werte.
Für kurze Chats zählt die Zeit bis zur ersten Antwort. Lange Prompts brauchen zusätzlich eine Prüfung der Eingabeverarbeitung. Mehrere gleichzeitige Anfragen verlangen ein Serving-Profil. Ein großes Modell, das gerade in den Speicher passt, kann für interaktiven Betrieb trotzdem zu langsam sein.
Gegen Tower und DGX Spark entscheiden
Ein GPU-Tower bietet mehr Austauschmöglichkeiten und kann bei einer passenden NVIDIA-Konfiguration einen direkten CUDA-Weg ermöglichen. DGX Spark ist eine kompakte CUDA-Alternative mit eigener ARM-Plattform. Der Mac punktet als integriertes Desktop-System, verlangt aber eine passende Apple-Modell- und Runtime-Auswahl.
Der Kauf sollte deshalb der Aufgabe folgen: kleine lokale Assistenz im mini, mehr Speicher und Bandbreite im Studio, hohe Kapazität beim entsprechend konfigurierten Ultra. Lautstärke, Steckdosenverbrauch und Latenz brauchen konkrete Messungen. Der Speicherrechner hilft bei der Vorauswahl; für die endgültige Entscheidung ist ein repräsentativer Aufgabentest nötig.
Speicherbedarf für die Modellwahl: LLM-VRAM-Rechner.
Passende Werkzeuge
Fragen und Antworten
Gibt es im aktuellen Vergleich einen Mac Studio M6?
Apple dokumentiert aktuell den Mac Studio mit M5 Max oder M5 Ultra und den Mac mini mit M6. Der Plan verwendet diese Produktzuordnung. Ein späteres Studio-Modell benötigt eigene bestätigte Daten.
Sind 512 GB Unified Memory vollständig für das LLM verfügbar?
Betriebssystem, Anwendungen und Laufzeit teilen sich den Speicher. Cache beziehungsweise Modellzustand und temporäre Puffer kommen zu den Gewichten hinzu. Die tatsächlich verfügbare Kapazität hängt von Konfiguration, Backend und laufenden Prozessen ab.
Quellen
- Apple: Mac Studio M5 Max / M5 Ultra – technische Daten
- Apple: Mac mini M6 und Mac Studio M5 verfügbar
- MLX LM: Projekt
- llama.cpp: Projekt und Backends
- Ollama: Hardware support
- NVIDIA: DGX Spark Hardware Overview
- Apple: Mac mini – technische Daten
- Ollama: MLX on Apple Silicon
Quellen geprüft: 5. Oktober 2026.
Passend dazu