English
 Deutsch
 Polski
Canonical, hreflang und noindex: Warum eine Seite aus dem Index verschwindet

Inhalt
Eine Seite kann tadellos und unsichtbar sein. Geschrieben, veröffentlicht, verlinkt, schnell – und in den Suchergebnissen nicht vorhanden, weil eine Zeile irgendwo gesagt hat, dass es so sein soll.
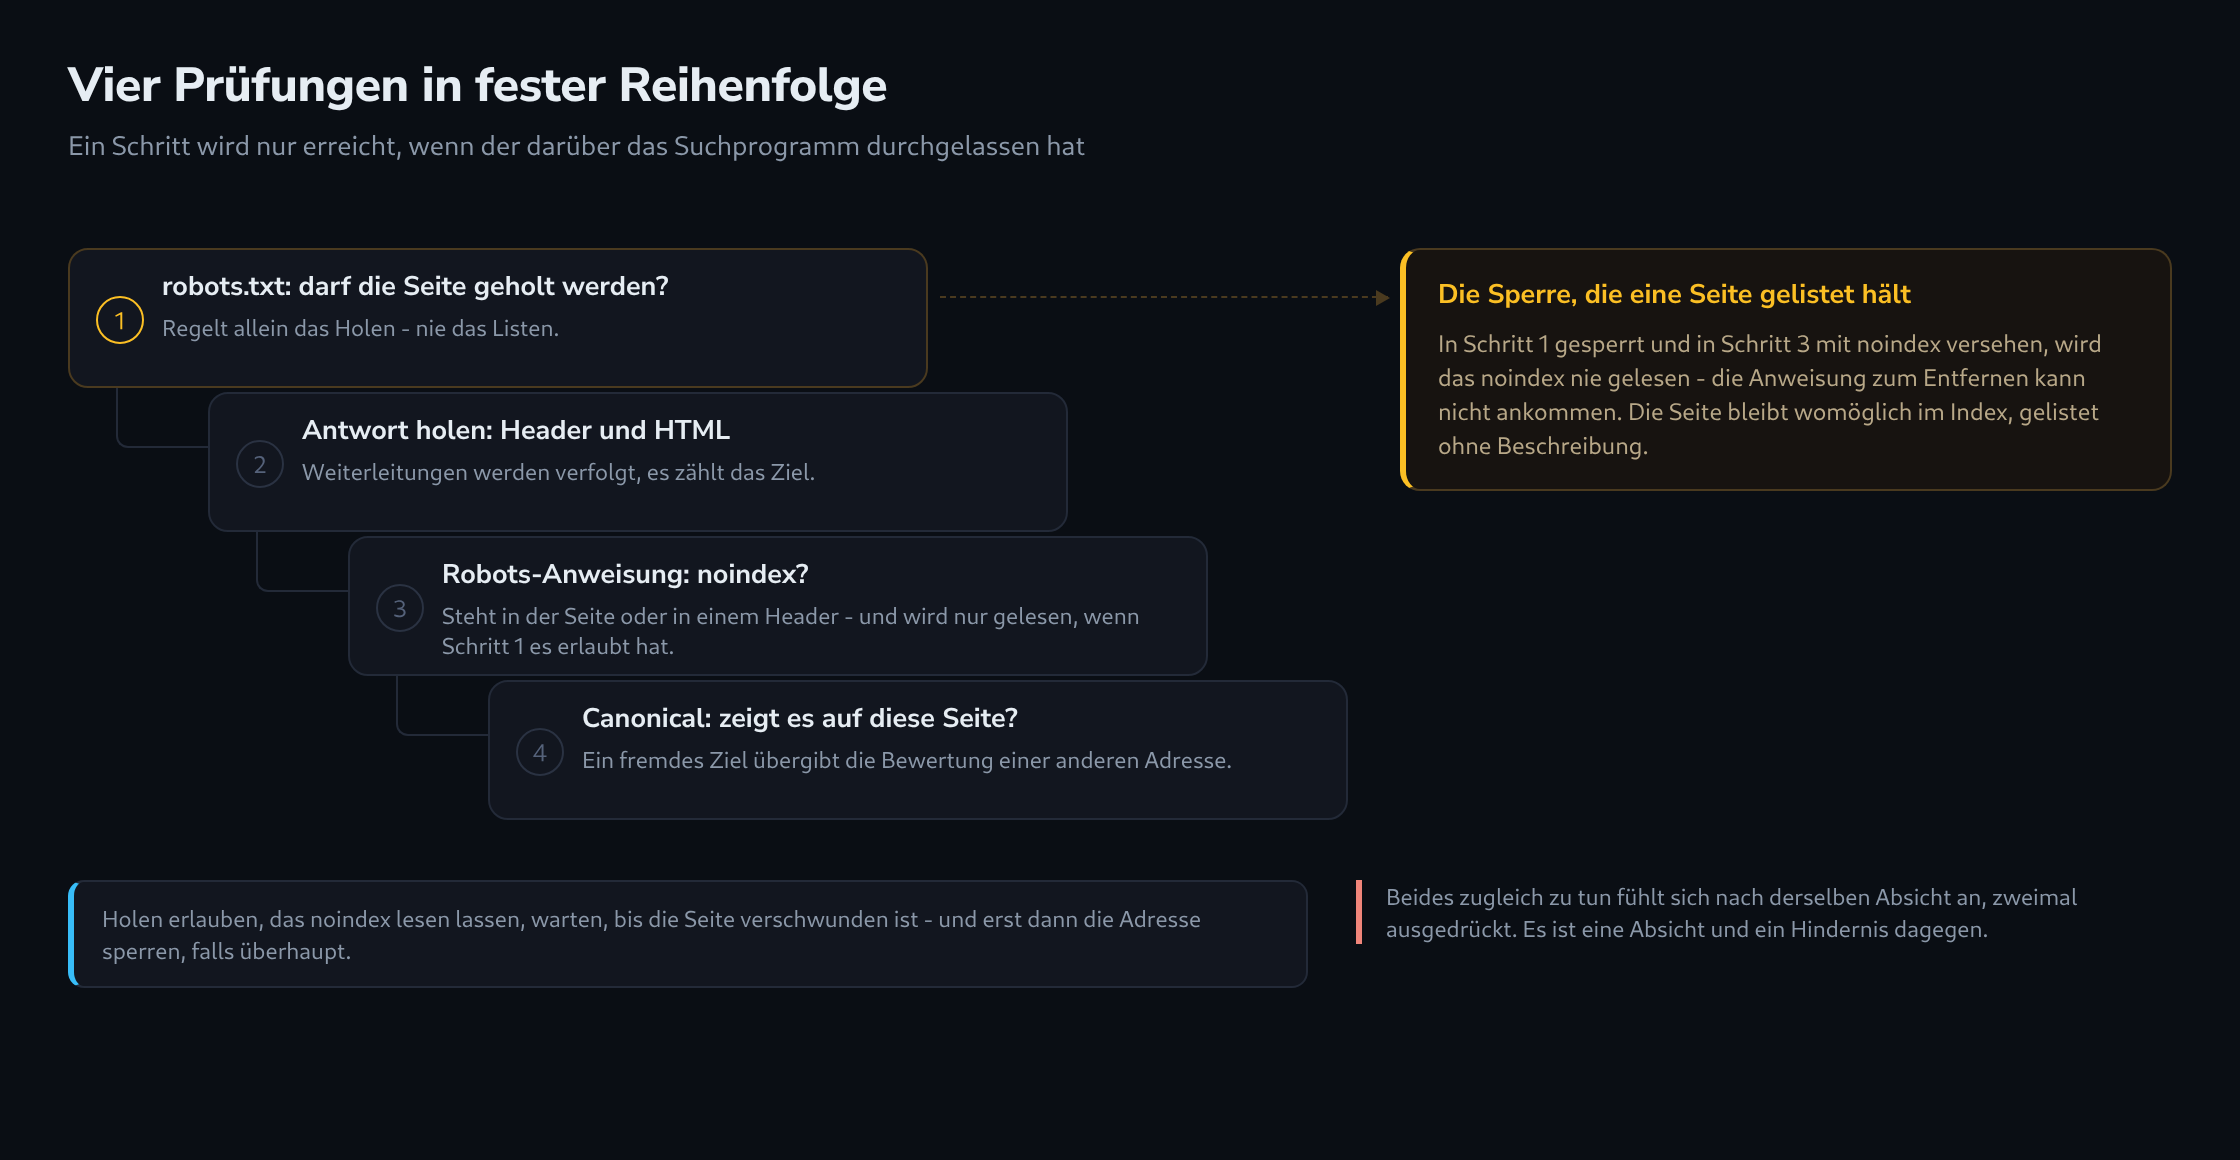
Vier Angaben entscheiden darüber, und gelesen werden sie nicht einzeln. Gelesen werden sie in einer festen Reihenfolge, jede nur dann, wenn die vorige durchgelassen hat – und diese Reihenfolge erzeugt mindestens ein Ergebnis, das verkehrt herum aussieht.
Was die vier Angaben sind
Die robots.txt ist eine Datei an der Wurzel einer Website und sagt, welche Adressen ein Suchprogramm holen darf. Geregelt wird das Holen, und sonst nichts.
Die Meta-Robots-Anweisung steht in der Seite selbst oder in einem Header der Antwort und sagt, ob die Seite gelistet werden darf. noindex heißt: lesen ja, listen nein.
Das Canonical benennt, welche Adresse die echte ist, wenn mehrere denselben Inhalt zeigen. Eine Seite, die auf eine andere Adresse zeigt, übergibt dieser Adresse ihre Bewertung.
hreflang teilt einer Suchmaschine mit, welche Sprachfassungen einer Seite es gibt, damit ein Besuch aus Polen die polnische Seite bekommt und nicht die englische.
Die ersten beiden entscheiden, ob eine Seite gelistet wird. Die anderen beiden entscheiden, welche Adresse gelistet wird und wem sie gezeigt wird.
Das Canonical, das woandershin zeigt
Ein Canonical ist ein Vorschlag, und meistens wird ihm gefolgt.
Sein Zweck sind Dubletten. Ein Shop-Artikel, der unter drei Adressen erreichbar ist, soll einmal zählen und nicht dreimal, und das Canonical benennt diejenige, die zählt. Jede Fassung zeigt auf dieselbe Adresse, und die Bewertung sammelt sich dort, statt sich aufzuteilen.
Der Fehler ist klein und leise: eine Seite, die auf eine andere Adresse zeigt als auf die eigene. Das passiert, wenn eine Vorlage kopiert und das Canonical fest verdrahtet stehen bleibt, wenn ein Testsystem geklont wird oder wenn eine Übersetzungserweiterung jede Sprache auf die englische Fassung zeigen lässt. Das Ergebnis ist eine Seite, die es gibt, die funktioniert und die alles, was sie verdient, einer anderen Adresse überlässt.
Ein Canonical muss außerdem eine vollständige Adresse sein. Eine relative wird ausgelegt, und gegen die falsche Grundlage ausgelegt zeigt sie irgendwohin, wohin niemand zeigen wollte. Die Prüfung darauf lohnt gerade deshalb, weil kein sichtbares Anzeichen entsteht.
Wenn eine Sperre das noindex verbirgt
Das ist der Fall, der verkehrt herum zu lesen ist, und der häufigste ernste Fehler der vier.
Eine Seite soll aus den Suchergebnissen verschwinden. Es wird zweierlei zugleich getan: noindex kommt in die Seite, und die Adresse wird in der robots.txt gesperrt. Beides fühlt sich nach derselben Absicht an, zweimal ausgedrückt.
Es ist nicht dasselbe. Die robots.txt verhindert das Holen. Ein Suchprogramm, das die Seite nicht holen darf, liest ihren Inhalt nie – und noindex steht im Inhalt. Die Anweisung, die Seite zu entfernen, kann nicht ankommen, weil der Weg zum Ankommen gesperrt wurde.
Die Seite bleibt dann womöglich im Index, gelistet aufgrund von Links, die auf sie zeigen, meist ohne Beschreibung, weil nichts gelesen werden konnte. Dieser Anblick ist aus Suchergebnissen vertraut, und er ist genau dieser Fehler.
Die richtige Reihenfolge ist die umgekehrte: Holen erlauben, das noindex lesen lassen, warten, bis die Seite verschwunden ist – und erst dann, falls gewünscht, die Adresse sperren.
hreflang und der Rückbezug
hreflang ist die mühsamste der vier, denn eine einzelne Seite kann für sich allein nie richtig sein.
Die Regel heißt gegenseitiger Bezug. Benennt die deutsche Seite die englische, muss die englische die deutsche zurückbenennen. Ein Bezug in nur eine Richtung wird übergangen – nicht teilweise gewürdigt, übergangen – und die Sprachfassungen bleiben unverbunden.
Zwei weitere Regeln kosten wenig und werden oft übersprungen. Jede Seite einer Gruppe muss neben den anderen auch sich selbst benennen; eine Gruppe ohne Selbstbezug ist ungültig. Und ein Eintrag sollte x-default tragen, für Besuche, deren Sprache unter den Fassungen nicht vorkommt – ohne diesen Eintrag landet ein Besuch aus einem vierten Land dort, wo die Suchmaschine es vermutet.
Eine ehrliche Grenze gehört hierher: ob die Gegenseite wirklich zurückzeigt, lässt sich nur feststellen, indem auch die Gegenseite geholt wird. Eine Prüfung einer einzelnen Seite kann lesen, was diese Seite behauptet, und sehen, ob der Selbstbezug da ist – den Rückbezug bestätigen kann sie nicht. Ein Werkzeug, das hreflang von einer Seite aus als „korrekt” meldet, hat den Teil nicht geprüft, der am häufigsten scheitert.
Die Gruppe in der robots.txt, die den Rest aussticht
Die robots.txt sieht aus wie eine Liste von Regeln und ist in Wirklichkeit ein Satz getrennter Regelwerke, eines je Suchprogramm.
Eine Datei darf eine Gruppe für * enthalten und eine weitere für ein namentlich genanntes Suchprogramm. Es liegt nahe, das als Schichten zu lesen: die allgemeine gilt, die besondere kommt hinzu. So arbeitet es nicht. Ein Suchprogramm mit einer eigenen Gruppe liest ausschließlich diese Gruppe und übergeht die Gruppe für * vollständig.
Eine Datei, die /intern/ für alle sperrt und daneben eine eigene Gruppe für eine Suchmaschine enthält, in der /intern/ nicht vorkommt, lässt genau diese Suchmaschine nach /intern/. Die allgemeine Sperre wird nicht abgeschwächt – sie gilt für ein Suchprogramm, das eigene Regeln mitgebracht hat, schlicht nicht.
Das gehört deutlich gesagt, weil die Vermutung in die falsche Richtung zeigt und weil eine Regel, die für fast alle gilt, selten gegen die Ausnahme geprüft wird.
Was ein Abruf zeigt
Alle vier Angaben kommen mit einer einzigen Anfrage, dazu eine für die robots.txt. Zusammen gelesen ergeben sie erst das Bild, denn jede zählt nur im Licht der anderen.
Vier Fragen: zeigt das Canonical auf die Seite selbst oder woandershin. Gibt es ein noindex, in der Seite oder in einem Header. Erlaubt die robots.txt das Holen überhaupt – und nach den Regeln welcher Gruppe. Und enthalten die hreflang-Einträge einen Selbstbezug und ein x-default.
Der Indexierungs-Prüfer beantwortet alle vier für eine beliebige Adresse. Er folgt den Weiterleitungen, liest die Angaben aus Headern wie aus der Seite, wertet die robots.txt mit der richtigen Vorrangregel aus und kennzeichnet gesondert, was sich von einer Seite aus nicht wissen lässt – vor allem den Rückbezug.
Das brauchbare Ergebnis ist ein Satz: ob diese Adresse gelistet werden kann, und wenn nicht, welche der vier Angaben es verhindert.
Fragen und Antworten
Was passiert, wenn die Sprachfassungen hreflang tragen, ihr Canonical aber auf die englische Seite zeigt?
Die beiden Angaben widersprechen sich. hreflang sagt: Diese Seite ist die deutsche Fassung einer Gruppe. Das Canonical sagt: Die echte Adresse ist die englische, diese hier ist eine Dublette. Folgt die Suchmaschine dem Canonical, was sie in der Regel tut, listet sie die englische Adresse und überlässt ihr die Bewertung der deutschen. Ein Besuch aus Deutschland bekommt dann die englische Seite, also genau das, was hreflang verhindern soll.
Eine Übersetzung ist keine Dublette, auch wenn sie denselben Inhalt in einer anderen Sprache zeigt. Richtig ist deshalb, dass jede Sprachfassung per Canonical auf sich selbst zeigt und die hreflang-Einträge genau diese kanonischen Adressen nennen. Zeigt ein hreflang-Eintrag auf eine Adresse, die ihr Canonical selbst woandershin setzt, verweist die Gruppe auf eine Seite, die ihre Bewertung an eine andere Adresse abgibt.
Häufig steckt eine Übersetzungserweiterung dahinter, und dann betrifft der Fehler alle Sprachen zugleich. Eine Prüfung jeder Fassung zeigt ihn schnell, weil das Canonical dann nicht auf die eigene Adresse zeigt.
Wie lässt sich eine PDF-Datei aus dem Index nehmen, in die sich kein Meta-Tag schreiben lässt?
Über den Header der Antwort: X-Robots-Tag: noindex wirkt wie die Meta-Robots-Anweisung und funktioniert für jede Dateiart. Auch hier gilt dieselbe Reihenfolge wie bei Seiten: Die robots.txt darf die Datei nicht sperren, sonst wird auch der Header nie gelesen.
Passend dazu