English
 Deutsch
 Polski
Was kann Gemini 4 Argon für mich tun? Cases und Grenzen

Gemini 4 Argon ist Googles Modell für Aufgaben, bei denen eine kurze Antwort allein nicht genügt: umfangreiche Unterlagen auswerten, Software über mehrere Schritte bearbeiten oder Informationen aus Text, Bild, Ton und Video zusammenführen. Die Modellbeschreibung nennt außerdem mathematische und wissenschaftliche Probleme. Daraus folgt keine Garantie für richtige Ergebnisse. Der praktische Nutzen hängt von der konkreten Aufgabe, den verfügbaren Werkzeugen und einer überprüfbaren Ausgabe ab. [1][3]
Der folgende Überblick beschreibt den dokumentierten Stand vom 20. Oktober 2026. Eigene Vergleichsbenchmarks oder erfolgreiche Kundenprojekte mit Argon liegen diesem Artikel nicht zugrunde.
Wo Gemini 4 Argon verfügbar ist
Seit dem 13. Oktober steht Argon laut Google in der Gemini-App für Abonnements von Google AI Pro und Ultra bereit. Für Entwicklung und Integration sind Google AI Studio und die Gemini API dokumentiert; die Modellkennung lautet gemini-4-argon. Die Modellkarte nennt zusätzlich geschäftliche Google-Angebote, Antigravity und den AI Mode der Suche. Verfügbarkeit, Nutzungsgrenzen und Bedienfunktionen unterscheiden sich zwischen diesen Zugängen. [1][2][4]
Für eine einzelne Analyse bietet sich die App oder AI Studio an. Wiederkehrende Abläufe mit eigenen Datenquellen, festen Ausgabeformaten und Protokollierung benötigen eher eine API-Integration. Diese Einordnung beschreibt den Arbeitsaufwand, keine Qualitätsrangfolge der Oberflächen.
Vier sinnvolle Einsatzfelder
Softwareentwicklung: Argon kann Fehlerursachen in mehreren Dateien untersuchen, Tests vorschlagen, Änderungen entwerfen und eine Migration in Teilschritte zerlegen. Ein konkreter Auftrag enthält Repository-Ausschnitt, Laufzeitumgebung, erwartetes Verhalten und bestehende Tests. Kompilierung, Tests und Code-Review bleiben nötig, bevor Änderungen übernommen werden. Google nennt komplexe Softwareentwicklung ausdrücklich als Zielbereich. [1][3]
Dokumente und Recherche: Mehrere Berichte, Verträge oder technische Spezifikationen lassen sich gegenüberstellen. Nützlich sind eine Tabelle mit Aussage, Fundstelle und offenem Widerspruch sowie eine getrennte Liste ungeklärter Punkte. Die API nimmt auch PDF-Dateien an. Quellenverweise in der Ausgabe brauchen trotzdem eine Gegenprüfung am Original; eine flüssige Zusammenfassung ersetzt keine belastbare Fundstelle. [1][3]
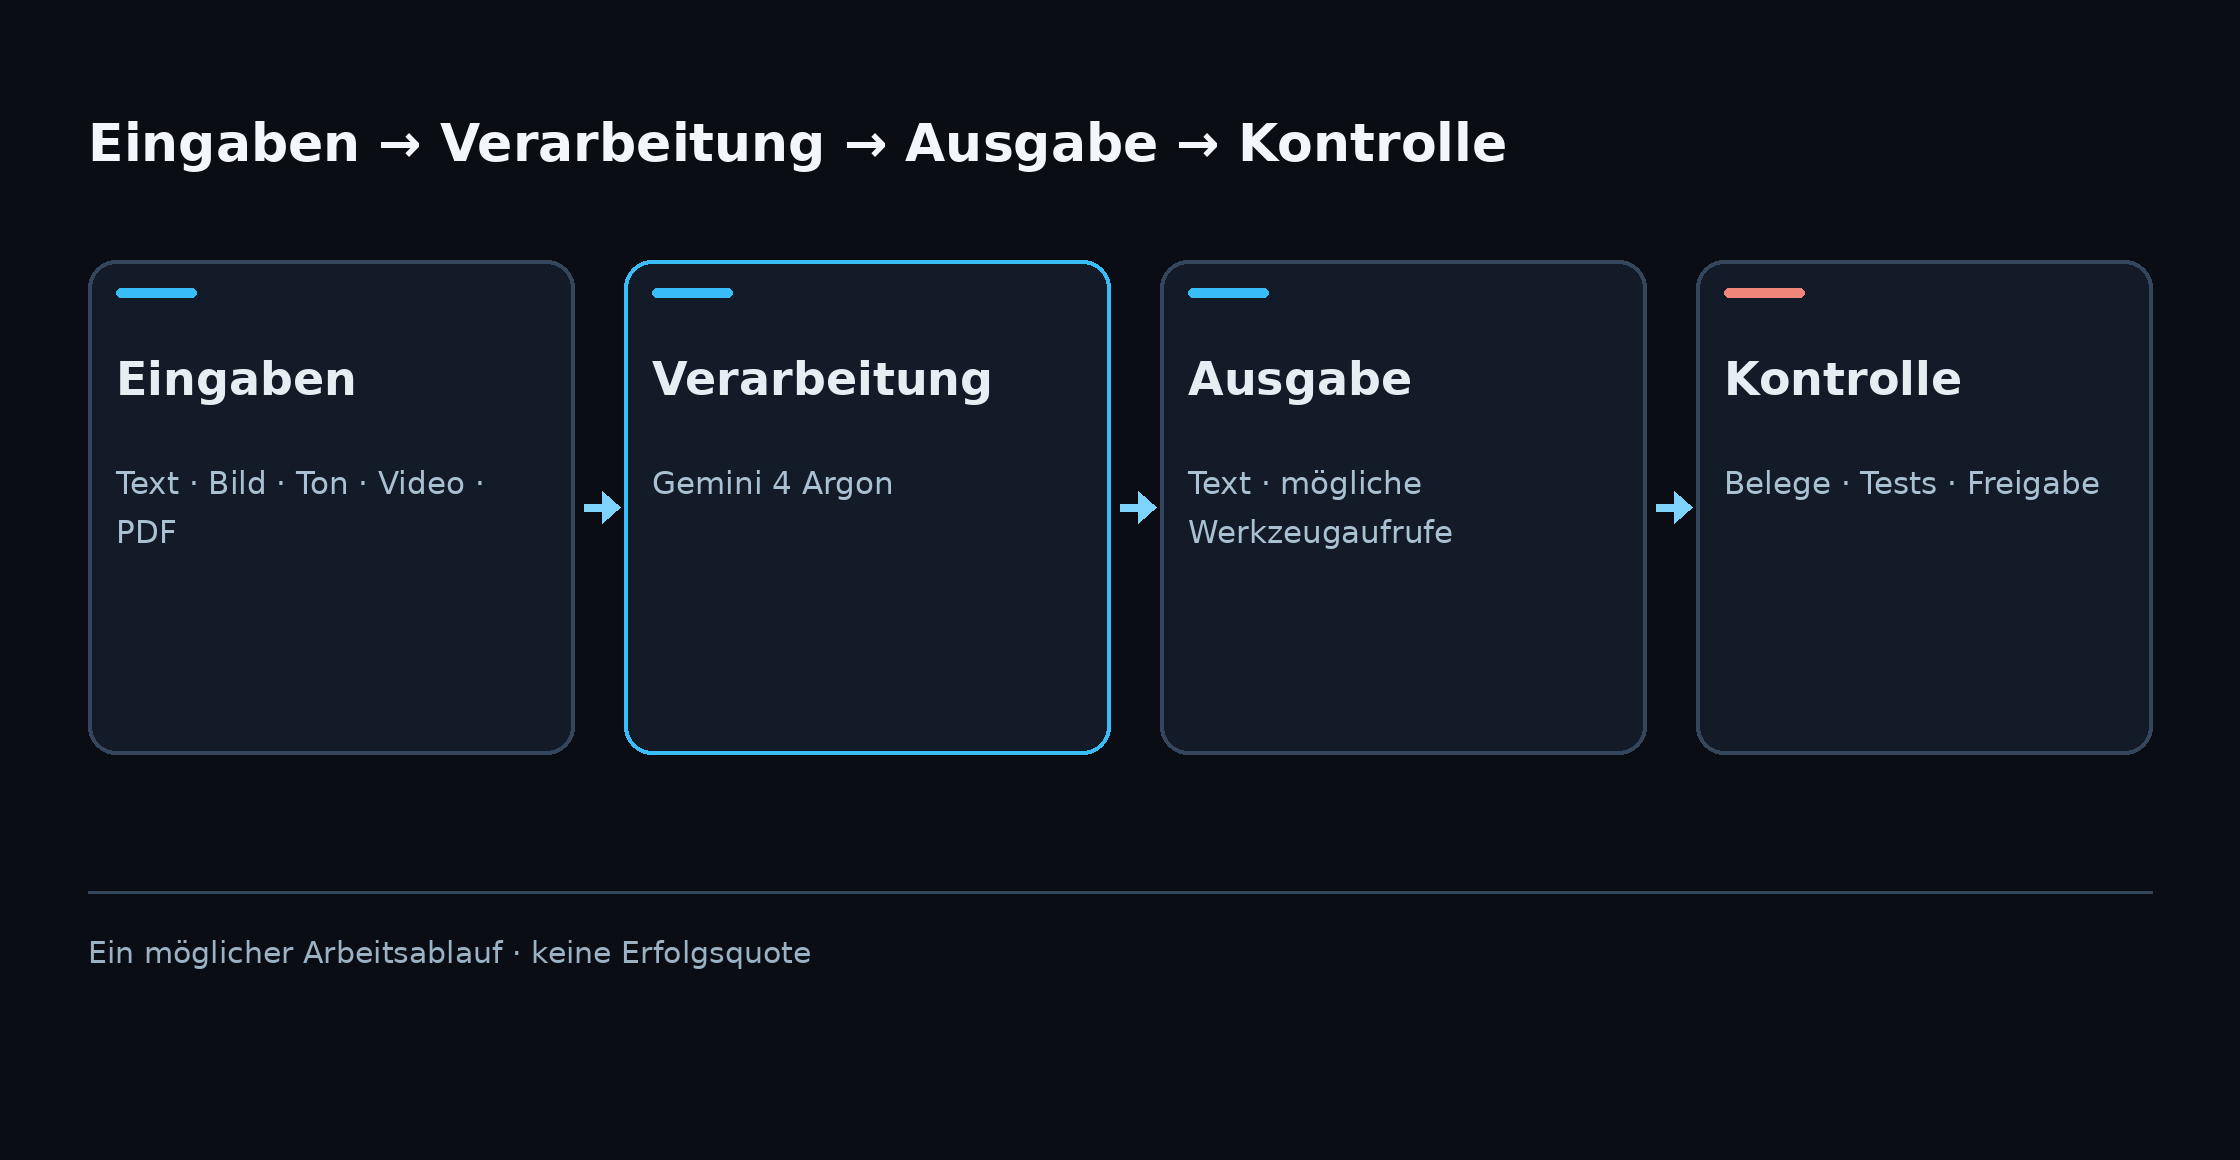
Multimodale Analyse: Die Modellseite nennt Text, Bilder, Audio, Video und PDFs als Eingaben. Damit sind etwa Bildschirme, Diagramme oder ein aufgezeichnetes Verfahren gemeinsam mit einer schriftlichen Anforderung analysierbar. Die Modellausgabe ist Text. Bild- und Audioerzeugung sowie die Live API gehören laut aktueller Modellseite nicht zum Funktionsumfang von Argon. [1]
Mehrstufige Abläufe: In der API unterstützt Argon Funktionsaufrufe, strukturierte Ausgaben, Codeausführung sowie Such- und URL-Kontext. Eine Anwendung kann dadurch Recherche, Berechnung und Ausgabe verbinden. Welche externen Aktionen tatsächlich stattfinden, bestimmt jedoch die Integration mit den vergebenen Berechtigungen. Für Aktionen mit Folgen sind klar begrenzte Werkzeuge, Protokolle und Freigabeschritte sinnvoll. [1]
Was das Millionen-Token-Fenster bedeutet
Google gibt ein gemeinsames Fenster von 1.048.576 Token für Eingabe, internes Denken und Ausgabe an. Das ist Kapazität für sehr große Aufgaben, aber kein Versprechen, dass jedes Detail aus einem langen Dokument fehlerfrei erinnert oder gewichtet wird. Für normale synchrone Antworten beträgt die Standardobergrenze 65.536 Ausgabetoken. Längere Ausgaben bis zur gemeinsamen Grenze benötigen den dokumentierten Long-Decode-Ablauf mit Hintergrundausführung. [1][2]
Ein langer Kontext spart bei großen Akten oder Codebasen das harte Aufteilen in viele Einzelanfragen. Für eine präzise Auswertung helfen dennoch klare Teilfragen, Dateinamen und verlangte Fundstellen. Besonders bei widersprüchlichen Quellen ist eine kurze Liste der verwendeten Belege aussagekräftiger als eine möglichst lange Antwort.
Grenzen, Laufzeit und Kosten
Die Modellkarte nennt Halluzinationen und gelegentliche Langsamkeit oder Zeitüberschreitungen als bekannte Grenzen. Der Wissensstichtag des Modells ist März 2026; einzelne Fachbereiche können älter sein. Aktuelle Entwicklungen gehören deshalb in eine belegte Recherche mit frischen Quellen, nicht allein in eine Antwort aus Modellwissen. [3]
Für die API nennt Google bis 30. November 2026 einen Einführungspreis von 2 US-Dollar je Million Eingabetoken und 10 US-Dollar je Million Ausgabetoken. Ab 1. Dezember sind 4 beziehungsweise 20 US-Dollar angekündigt. Den Ausgabetoken werden auch Denk-Token zugerechnet. Implizites Caching kann Kosten bei wiederholten langen Präfixen senken; explizites Caching unterstützt Argon nicht. Eine kostenlose API-Stufe gibt es für dieses Modell laut Google nicht. Diese Preise gelten für die API, nicht als Preisangabe für das App-Abonnement. [2]
Mehr Denktiefe und lange Kontexte können die Bearbeitungszeit und die Rechnung erhöhen. Die API bietet die Denkstufen low, medium und high; medium ist voreingestellt. Bei häufigen Routineaufgaben lohnt ein Vergleich derselben Arbeitsprobe mit mehreren Einstellungen und einem kleineren Modell. Die passende Wahl ergibt sich aus Fehlerquote, Laufzeit und Gesamtkosten des konkreten Ablaufs, nicht allein aus einer Modellrangliste. [2]
Ein nachvollziehbarer Praxistest
Ein kurzer Test mit eigenen, freigegebenen Beispieldaten ist aussagekräftiger als ein Werbebeispiel. Drei Aufgaben reichen für einen ersten Befund: ein bekannter Programmfehler mit ausführbaren Tests, zwei Dokumente mit absichtlich widersprüchlichen Aussagen und ein Diagramm mit Fragen zu Achsen und Größenordnungen. Für jede Aufgabe werden erwartete Fakten, zulässige Quellen, Zeitbedarf und Kosten vorab festgelegt.
Bei Code zählen erfolgreiche Tests und ein verständlicher Diff. Bei Dokumenten zählen korrekte Fundstellen und erkannte Widersprüche. Bei Bildern zählen belastbare Aussagen aus den sichtbaren Daten statt plausibler Vermutungen. Eine zweite Prüfung am Ausgangsmaterial bleibt gerade dort nötig, wo falsche Antworten fachliche oder finanzielle Folgen hätten.
Gemini 4 Argon eignet sich damit vor allem für aufwendige Analyse und Entwürfe mit überprüfbarem Ergebnis. Für kurze Standardfragen kann derselbe Modellaufwand unnötig sein. Die Entscheidung fällt anhand der Aufgabe und des Prüfprozesses.
Fragen und Antworten
Kann Gemini 4 Argon Bilder erzeugen?
Die aktuelle API-Modellseite nennt Bilder als Eingabe, aber keine Bilderzeugung als Fähigkeit dieses Modells. Das Ergebnis von Argon ist Text. Andere Gemini-Modelle oder Produktfunktionen können einen anderen Funktionsumfang besitzen.
Ist das Kontextfenster von einer Million Token zugleich die normale Antwortlänge?
Nein. Die Million ist eine gemeinsame Obergrenze für Eingabe, Denken und Ausgabe. Synchrone Antworten haben standardmäßig eine Ausgabelimitierung von 65.536 Token; längere Ausgaben verlangen den besonderen Hintergrundablauf.
Reichen Modellantworten für aktuelle Fakten und Entscheidungen?
Aktuelle Fakten benötigen frische, überprüfte Quellen. Die Modellkarte nennt März 2026 als Wissensstichtag und weist auf mögliche Halluzinationen hin. Fachliche Entscheidungen brauchen eine Prüfung der Belege und Ergebnisse.
Quellen
- Google AI for Developers: Gemini 4 Argon, Modellbeschreibung
- Google AI for Developers: Neuerungen, API, Preise und Migration
- Google DeepMind: Gemini 4 Argon Model Card
- Google Blog: Verfügbarkeit in der Gemini-App, 13. Oktober 2026
Quellenstand: 20. Oktober 2026. Produktangaben und Preise stammen von Google. Eigene Leistungs- oder Qualitätsmessungen werden nicht behauptet.
Passend dazu