English
 Deutsch
 Polski
Co potrafi Gemini 4 Argon? Zastosowania i ograniczenia

Gemini 4 Argon to model Google przeznaczony do zadań wymagających czegoś więcej niż krótkiej odpowiedzi: analizy obszernych dokumentów, wieloetapowych zmian w oprogramowaniu oraz łączenia informacji z tekstu, obrazów, dźwięku i wideo. Karta modelu wymienia także problemy matematyczne i naukowe. Żadna z tych możliwości nie gwarantuje poprawnego wyniku. Praktyczna wartość zależy od zadania, dostępnych narzędzi i możliwości sprawdzenia odpowiedzi. [1][3]
Artykuł przedstawia stan dokumentacji z 20 października 2026 r. Nie opiera się na własnych testach porównawczych ani na deklarowanych wdrożeniach klientów.
Gdzie dostępny jest Gemini 4 Argon
Według Google od 13 października Argon jest dostępny w aplikacji Gemini dla abonamentów Google AI Pro i Ultra. Dostęp programistyczny zapewniają Google AI Studio oraz Gemini API pod identyfikatorem gemini-4-argon. Karta modelu wymienia także ofertę dla firm, Antigravity i tryb AI w wyszukiwarce. Dostępność, limity użycia i funkcje interfejsu zależą od wybranego kanału. [1][2][4]
Do pojedynczej analizy nadaje się aplikacja lub AI Studio. Powtarzalny proces z własnymi źródłami danych, ustalonym formatem wyniku i rejestrem działań zwykle wymaga integracji przez API. To podział według sposobu pracy, a nie ocena jakości interfejsów.
Cztery praktyczne obszary zastosowań
Tworzenie oprogramowania: Argon może analizować przyczyny błędów w wielu plikach, proponować testy, przygotowywać zmiany i dzielić migrację na etapy. Dobry opis zadania obejmuje odpowiedni fragment repozytorium, środowisko, oczekiwane zachowanie i istniejące testy. Kompilacja, testy i przegląd kodu pozostają konieczne przed przyjęciem zmian. Google wskazuje złożoną inżynierię oprogramowania jako jeden z obszarów modelu. [1][3]
Dokumenty i badania: Kilka raportów, umów lub specyfikacji technicznych można zestawić ze sobą. Tabela twierdzeń, miejsc w źródłach i sprzeczności bywa przydatniejsza od gładkiego streszczenia. API przyjmuje pliki PDF. Odwołania w wygenerowanej odpowiedzi nadal wymagają kontroli w oryginale; płynny opis nie stanowi dowodu poprawnego cytowania. [1][3]
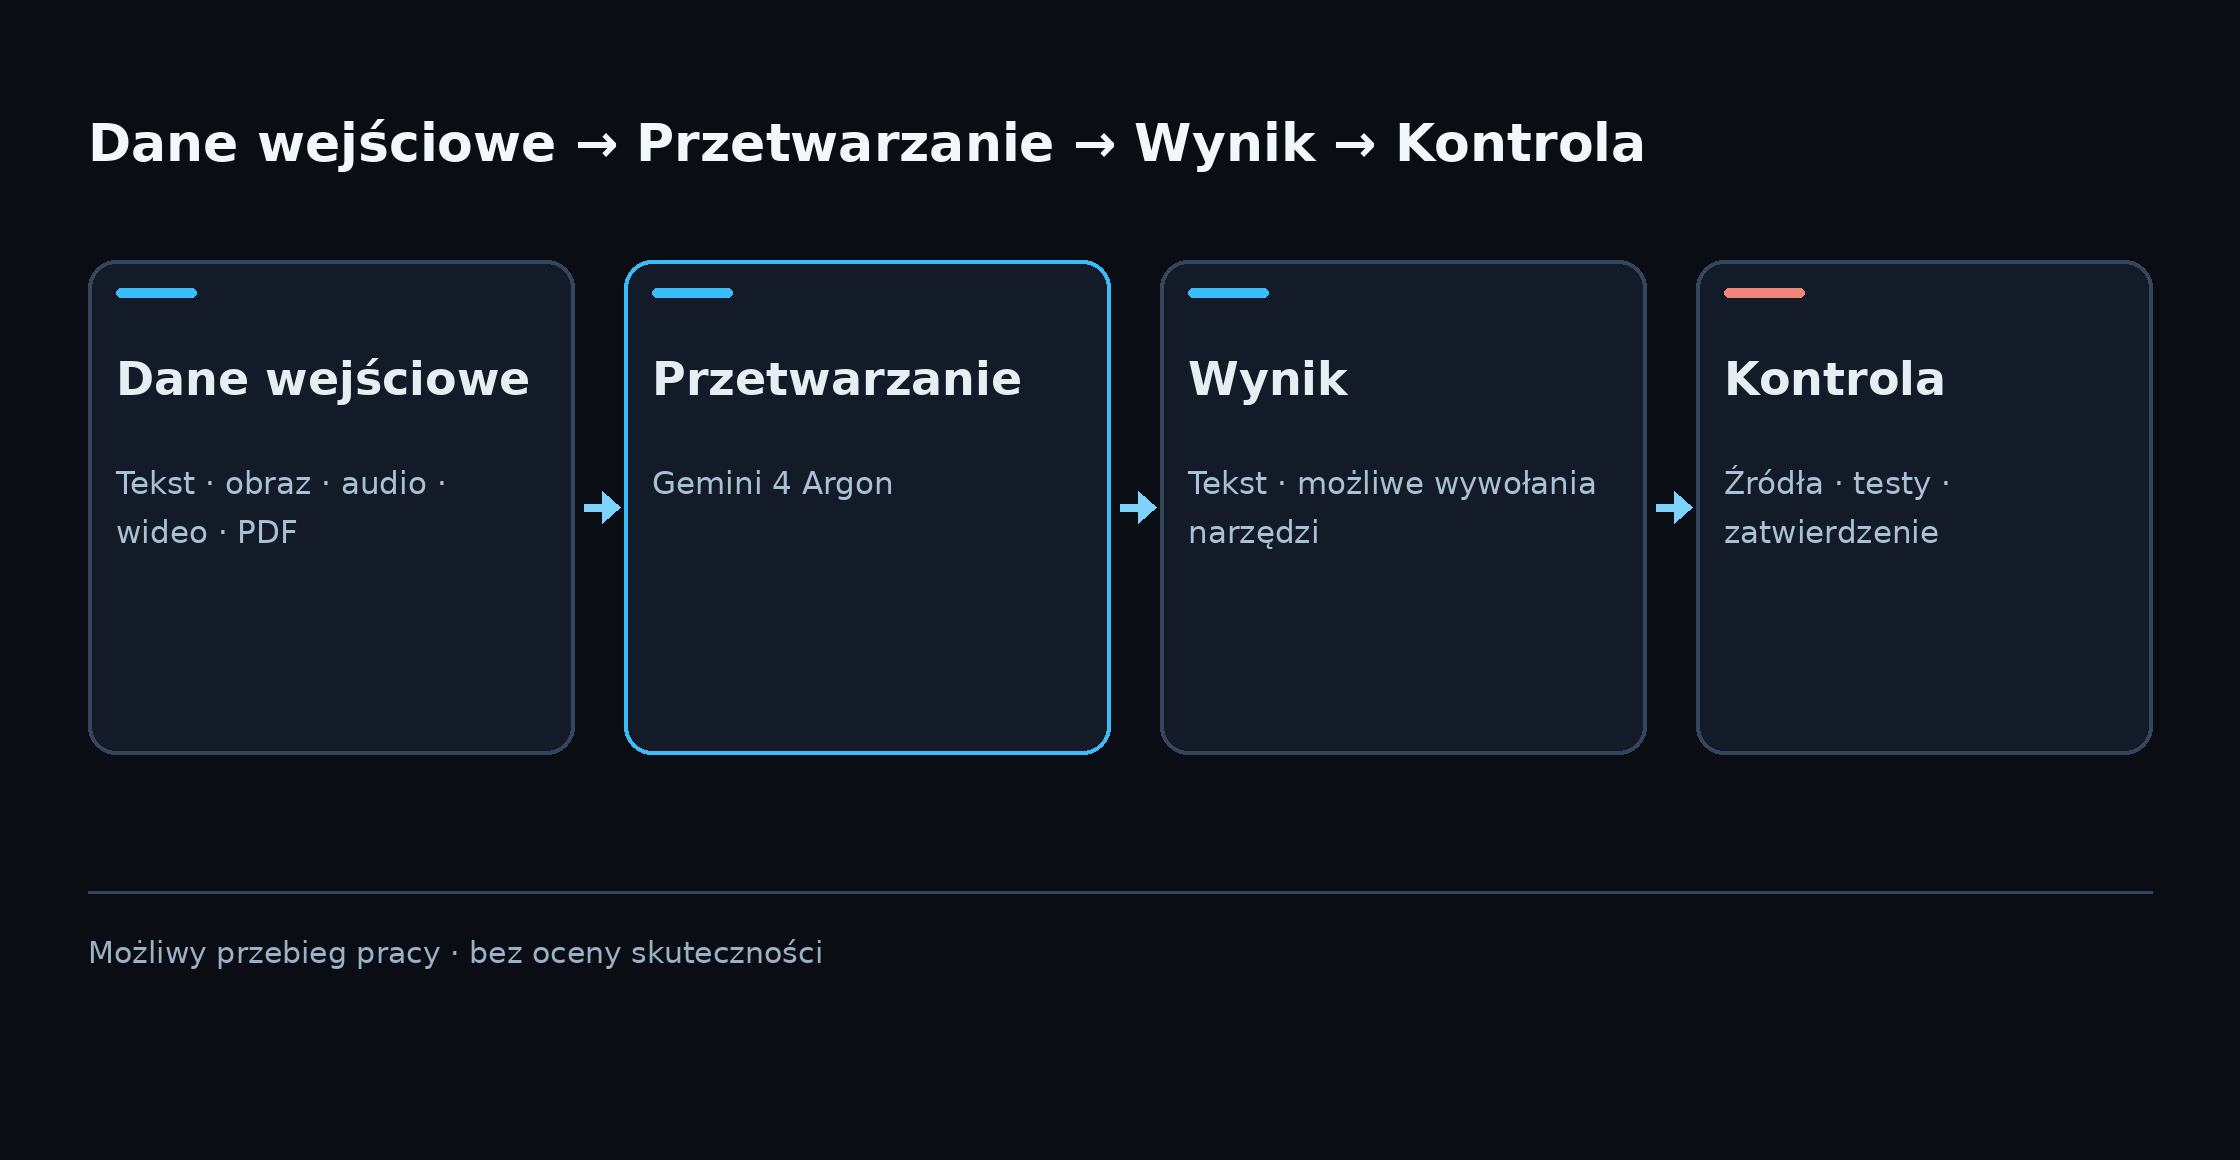
Analiza multimodalna: Strona modelu wymienia tekst, obrazy, audio, wideo i PDF jako dane wejściowe. Zrzuty ekranu, wykresy lub nagrany proces mogą więc zostać przeanalizowane razem z pisemnymi wymaganiami. Wynikiem pracy Argona jest tekst. Aktualna strona modelu nie wymienia generowania obrazów, generowania audio ani obsługi Live API. [1]
Procesy wieloetapowe: API obsługuje wywołania funkcji, odpowiedzi strukturalne, wykonywanie kodu, wyszukiwanie i kontekst adresów URL. Aplikacja może połączyć wyszukiwanie, obliczenia i określony format wyniku. O rzeczywistych działaniach zewnętrznych decyduje integracja oraz nadane uprawnienia. Przy działaniach wywołujących skutki przydają się wąsko określone narzędzia, rejestr operacji i punkty zatwierdzenia. [1]
Znaczenie okna miliona tokenów
Google podaje wspólny limit 1 048 576 tokenów dla danych wejściowych, wewnętrznego rozumowania i odpowiedzi. To pojemność do dużych zadań, a nie obietnica bezbłędnego zapamiętania i oceny każdego szczegółu długiego dokumentu. Domyślny limit zwykłej odpowiedzi synchronicznej wynosi 65 536 tokenów. Dłuższy wynik, aż do wspólnej granicy, wymaga opisanego trybu long decode z pracą w tle. [1][2]
Duży kontekst ogranicza konieczność dzielenia obszernych akt lub bazy kodu na wiele osobnych zapytań. Jasne pytania częściowe, nazwy plików i żądane miejsca w źródłach nadal poprawiają możliwość kontroli. Przy sprzecznych materiałach zwięzła lista dowodów może być cenniejsza od bardzo długiej odpowiedzi.
Ograniczenia, czas i koszt
Karta modelu wymienia halucynacje oraz sporadyczne spowolnienia i przekroczenia czasu jako znane ograniczenia. Granica wiedzy modelu przypada na marzec 2026 r., a w części dziedzin informacje mogą być starsze. Nowsze wydarzenia wymagają więc aktualnych, sprawdzonych źródeł, a nie samej odpowiedzi z pamięci modelu. [3]
W API Google podaje cenę wprowadzającą do 30 listopada 2026 r.: 2 USD za milion tokenów wejściowych i 10 USD za milion tokenów wyjściowych. Od 1 grudnia zapowiedziane stawki wynoszą odpowiednio 4 i 20 USD. Do rozliczanych tokenów wyjściowych należą również tokeny rozumowania. Buforowanie niejawne może obniżyć koszt powtarzanych długich początków zapytań; buforowanie jawne nie jest obsługiwane. Według Google Argon nie jest dostępny w bezpłatnej warstwie API. Są to ceny API, a nie ceny abonamentu aplikacji Gemini. [2]
Głębsze rozumowanie i długi kontekst mogą zwiększyć czas przetwarzania oraz koszt. API oferuje poziomy low, medium i high; domyślny jest medium. W częstych zadaniach rutynowych warto porównać tę samą próbkę pracy przy różnych ustawieniach oraz z mniejszym modelem. O wyborze powinny decydować błędy, czas i pełny koszt konkretnego procesu, nie ogólne miejsce w rankingu. [2]
Powtarzalny test na początek
Krótka ocena na zatwierdzonych danych przykładowych daje więcej informacji niż materiał promocyjny. Trzy zadania sprawdzają różne mocne strony: znany błąd programu z wykonywalnymi testami, dwa dokumenty z celową sprzecznością oraz wykres z pytaniami o osie i skalę. Oczekiwane fakty, dopuszczalne źródła, czas i koszt powinny zostać ustalone przed próbą.
Przy kodzie znaczenie mają przechodzące testy i czytelny diff. Przy dokumentach liczą się prawidłowe miejsca w źródłach oraz wykryte sprzeczności. Przy obrazach wnioski muszą wynikać z widocznych danych, a nie z wiarygodnie brzmiących domysłów. Ponowna kontrola materiału wejściowego pozostaje potrzebna zwłaszcza tam, gdzie pomyłka niesie skutki zawodowe lub finansowe.
Gemini 4 Argon najbardziej odpowiada więc wymagającej analizie i projektom odpowiedzi z możliwym do sprawdzenia wynikiem. Przy krótkich rutynowych pytaniach podobny nakład może być zbędny. O wartości decydują zadanie i sposób kontroli.
Pytania i odpowiedzi
Czy Gemini 4 Argon generuje obrazy?
Aktualna strona modelu w API wymienia obrazy jako dane wejściowe, lecz nie przypisuje temu modelowi generowania obrazów. Argon zwraca tekst. Inne modele Gemini lub funkcje produktów mogą mieć odmienny zakres.
Czy kontekst miliona tokenów oznacza zwykłą długość odpowiedzi?
Nie. Limit miliona jest wspólny dla wejścia, rozumowania i wyjścia. Odpowiedź synchroniczna ma domyślny limit 65 536 tokenów wyjściowych; dłuższy wynik wymaga osobnego procesu w tle.
Czy odpowiedzi modelu wystarczą do oceny aktualnych faktów i ważnych decyzji?
Aktualne fakty wymagają nowych, sprawdzonych źródeł. Karta modelu podaje marzec 2026 r. jako granicę wiedzy i wskazuje możliwość halucynacji. Ważne decyzje wymagają kontroli dowodów i wyniku.
Źródła
- Google AI for Developers: opis modelu Gemini 4 Argon
- Google AI for Developers: nowości, API, ceny i migracja
- Google DeepMind: karta modelu Gemini 4 Argon
- Google Blog: dostępność w aplikacji Gemini, 13 października 2026 r.
Stan źródeł: 20 października 2026 r. Informacje o produkcie i cenach pochodzą od Google. Artykuł nie przypisuje sobie własnych pomiarów wydajności ani jakości.
Powiązane artykuły