English
 Deutsch
 Polski
Canonical, hreflang i noindex: dlaczego strona znika z indeksu

Spis treści
Strona może być nienaganna i niewidoczna. Napisana, opublikowana, podlinkowana, szybka – i nieobecna w wynikach wyszukiwania, bo jedna linijka gdzieś powiedziała, że tak ma być.
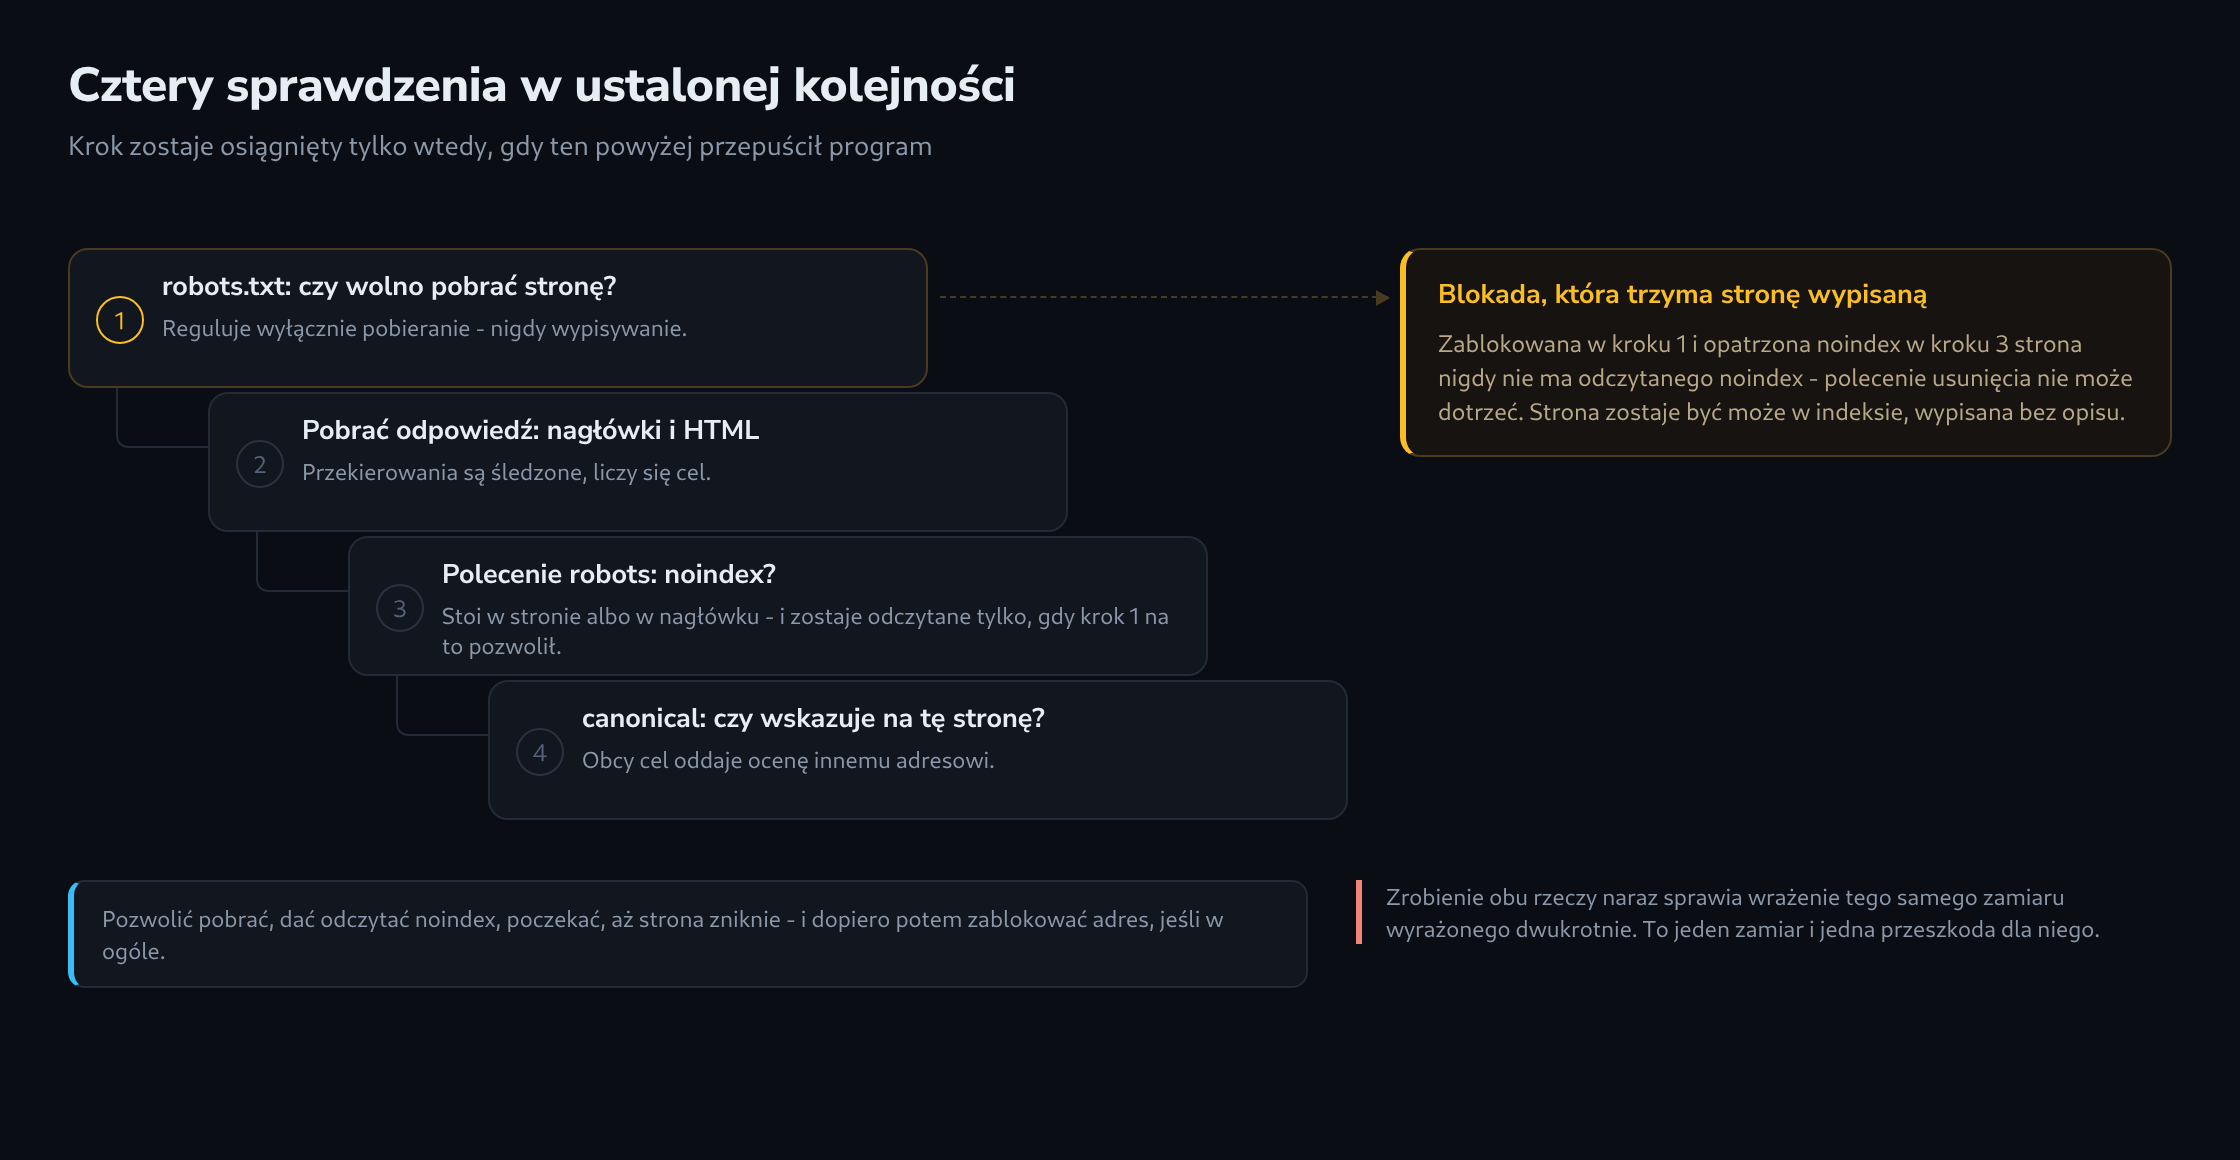
Rozstrzygają o tym cztery wskazania, a odczytywane nie są pojedynczo. Odczytywane są w ustalonej kolejności, każde tylko wtedy, gdy poprzednie przepuściło – i ta kolejność wytwarza co najmniej jeden wynik wyglądający na odwrócony.
Czym są te cztery wskazania
robots.txt to plik u korzenia witryny mówiący, które adresy wolno pobrać programowi wyszukiwarki. Reguluje pobieranie i nic poza tym.
Polecenie meta robots stoi w samej stronie albo w nagłówku odpowiedzi i mówi, czy stronę wolno wypisać. noindex znaczy: czytać tak, wypisywać nie.
Canonical wskazuje, który adres jest prawdziwy, gdy kilka pokazuje tę samą treść. Strona wskazująca na inny adres oddaje mu własną ocenę.
hreflang mówi wyszukiwarce, jakie wersje językowe strony istnieją, żeby odwiedziny z Polski dostały stronę polską, a nie angielską.
Dwa pierwsze rozstrzygają, czy strona zostanie wypisana. Dwa pozostałe rozstrzygają, który adres zostanie wypisany i komu zostanie pokazany.
Canonical wskazujący gdzie indziej
Canonical jest propozycją i zwykle bywa uwzględniany.
Jego celem są duplikaty. Artykuł sklepowy osiągalny pod trzema adresami ma liczyć się raz, a nie trzy razy, i canonical wskazuje ten, który się liczy. Każda wersja wskazuje na ten sam adres, a ocena zbiera się tam, zamiast się dzielić.
Błąd jest drobny i cichy: strona wskazująca na adres inny niż własny. Zdarza się, gdy szablon zostaje skopiowany, a canonical zostaje wpisany na stałe, gdy system testowy zostaje sklonowany albo gdy rozszerzenie tłumaczące każe każdemu językowi wskazywać na wersję angielską. Wynikiem jest strona, która istnieje, działa i wszystko, na co zasłuży, oddaje innemu adresowi.
Canonical musi być poza tym adresem pełnym. Względny zostaje wyłożony, a wyłożony wobec złej podstawy wskazuje gdzieś, gdzie nikt wskazywać nie chciał. Sprawdzenie tego opłaca się właśnie dlatego, że nie powstaje żaden widoczny objaw.
Gdy blokada ukrywa noindex
To przypadek do odczytania na odwrót i najczęstszy poważny błąd z czterech.
Strona ma zniknąć z wyników wyszukiwania. Robi się dwie rzeczy naraz: noindex trafia do strony, a adres zostaje zablokowany w robots.txt. Jedno i drugie sprawia wrażenie tego samego zamiaru, wyrażonego dwukrotnie.
To nie to samo. robots.txt zapobiega pobraniu. Program wyszukiwarki, któremu strony pobrać nie wolno, nigdy nie odczyta jej treści – a noindex stoi w treści. Polecenie usunięcia strony nie może dotrzeć, bo droga dotarcia została zablokowana.
Strona zostaje wtedy być może w indeksie, wypisana na podstawie odnośników wskazujących na nią, zwykle bez opisu, bo nic nie dało się odczytać. Ten widok jest z wyników wyszukiwania znajomy i jest właśnie tym błędem.
Właściwa kolejność jest odwrotna: pozwolić na pobranie, dać odczytać noindex, poczekać, aż strona zniknie – i dopiero potem, jeśli trzeba, zablokować adres.
hreflang i odesłanie zwrotne
hreflang jest najbardziej mozolne z czterech, bo pojedyncza strona nigdy nie może być poprawna sama z siebie.
Reguła nazywa się wzajemne odesłanie. Jeśli strona niemiecka wymienia angielską, angielska musi wymienić niemiecką z powrotem. Odesłanie tylko w jedną stronę zostaje pominięte – nie częściowo uwzględnione, pominięte – a wersje językowe pozostają niepołączone.
Dwie dalsze reguły kosztują niewiele i bywają pomijane. Każda strona grupy musi obok pozostałych wymienić także samą siebie; grupa bez odesłania do siebie jest nieważna. A jeden wpis powinien nieść x-default, dla odwiedzin, których języka wśród wersji nie ma – bez tego wpisu odwiedziny z czwartego kraju lądują tam, gdzie wyszukiwarka się domyśli.
Należy się tu uczciwa granica: czy druga strona naprawdę odsyła z powrotem, da się ustalić tylko przez pobranie i tej drugiej strony. Sprawdzenie pojedynczej strony może odczytać, co ta strona twierdzi, i zobaczyć, czy odesłanie do siebie jest – potwierdzić odesłania zwrotnego nie może. Narzędzie zgłaszające hreflang z jednej strony jako „poprawny” nie sprawdziło tej części, która zawodzi najczęściej.
Grupa w robots.txt, która bije pozostałe
robots.txt wygląda jak lista reguł, a naprawdę jest zestawem osobnych zbiorów reguł, po jednym na program wyszukiwarki.
Plik może zawierać grupę dla * i jeszcze jedną dla programu wymienionego z nazwy. Nasuwa się czytanie tego warstwami: ogólna obowiązuje, szczególna dochodzi. Tak to nie działa. Program mający własną grupę czyta wyłącznie tę grupę i pomija grupę dla * całkowicie.
Plik blokujący /wewnetrzne/ dla wszystkich i zawierający obok własną grupę dla jednej wyszukiwarki, w której /wewnetrzne/ nie występuje, wpuszcza właśnie tę wyszukiwarkę do /wewnetrzne/. Ogólna blokada nie zostaje osłabiona – po prostu nie obowiązuje programu, który przyniósł własne reguły.
Warto to powiedzieć wyraźnie, bo domysł wskazuje w złą stronę i bo reguła obowiązująca prawie wszystkich rzadko bywa sprawdzana wobec wyjątku.
Co pokazuje jedno pobranie
Wszystkie cztery wskazania przychodzą z jednym zapytaniem, plus jedno po robots.txt. Dopiero odczytanie ich razem daje obraz, bo każde liczy się wyłącznie w świetle pozostałych.
Cztery pytania: czy canonical wskazuje na samą stronę, czy gdzie indziej. Czy jest noindex, w stronie albo w nagłówku. Czy robots.txt w ogóle pozwala pobrać – i wedle reguł której grupy. Oraz czy wpisy hreflang zawierają odesłanie do siebie i x-default.
Inspektor indeksowania odpowiada na wszystkie cztery dla dowolnego adresu. Śledzi przekierowania, odczytuje wskazania z nagłówków i ze strony, ocenia robots.txt z właściwym pierwszeństwem grup i osobno oznacza to, czego z jednej strony wiedzieć się nie da – przede wszystkim odesłanie zwrotne.
Użytecznym wynikiem jest jedno zdanie: czy ten adres może zostać wypisany, a jeśli nie, które z czterech wskazań temu zapobiega.
Pytania i odpowiedzi
Co się dzieje, gdy wersje językowe mają hreflang, a ich canonical wskazuje na stronę angielską?
Oba wskazania sobie przeczą. hreflang mówi: ta strona jest niemiecką wersją grupy. Canonical mówi: prawdziwym adresem jest angielski, a ta strona jest duplikatem. Jeśli wyszukiwarka pójdzie za wskazaniem canonical, co zwykle robi, pokaże w wynikach adres angielski i odda mu ocenę strony niemieckiej. Osoba odwiedzająca z Niemiec trafi wtedy na stronę angielską, czyli dokładnie to, czemu hreflang ma zapobiegać.
Tłumaczenie nie jest duplikatem, nawet jeśli pokazuje tę samą treść w innym języku. Właściwe jest więc, by każda wersja językowa wskazywała w canonical na samą siebie, a wpisy hreflang wymieniały dokładnie te kanoniczne adresy. Jeśli wpis hreflang wskazuje na adres, którego własny canonical prowadzi gdzie indziej, grupa odsyła do strony, która oddaje swoją ocenę innemu adresowi.
Często stoi za tym rozszerzenie tłumaczące i wtedy błąd dotyczy wszystkich języków naraz. Sprawdzenie każdej wersji szybko go ujawnia, bo canonical nie wskazuje wtedy na adres własny.
Jak usunąć z indeksu plik PDF, do którego nie da się wpisać znacznika meta?
Przez nagłówek odpowiedzi: X-Robots-Tag: noindex działa jak polecenie meta robots i nadaje się do każdego rodzaju pliku. Obowiązuje ta sama kolejność co przy stronach: robots.txt nie może blokować pliku, bo inaczej nagłówek również nigdy nie zostanie odczytany.
Powiązane artykuły