Deutsch
 Polski
Vom Download zur ersten Antwort: Wie aufwendig ist ein lokales LLM wirklich?

Inhalt
Ein lokales LLM aufzusetzen ist heute oft einfacher als einen vollständigen AI-Server zu betreiben. Eine Desktop-Anwendung kann Modellwahl und Start bündeln. Der eigentliche Aufwand zeigt sich jedoch bei Treibern, Download, GPU-Erkennung und der Frage, ob die gewünschte Konfiguration dauerhaft korrekt läuft.
Der Vergleich beschreibt Installationswege und Prüfschritte. Feste Minutenwerte für ungetestete Geräte wären keine belastbare Aussage. Downloadzeit und Einrichtungszeit werden deshalb getrennt betrachtet.
Der passende Einstieg je Betriebssystem
| System | Überschaubarer Einstieg | Zusätzlicher Aufwand |
|---|---|---|
| Windows | LM Studio oder Ollama mit passendem Backend | GPU-Treiber; vLLM etwa über WSL |
| macOS / Apple Silicon | Desktop-App oder Apple-Runtime | Passendes Artefakt und Speicherreserve |
| Linux | Ollama oder vorhandenes llama.cpp-Binary | Pakete, Gerätedateien und Dienststart |
| Serving auf Linux | vLLM mit unterstützter GPU | Modell- und Kernelkompatibilität |
Vier Voraussetzungen vor dem Download
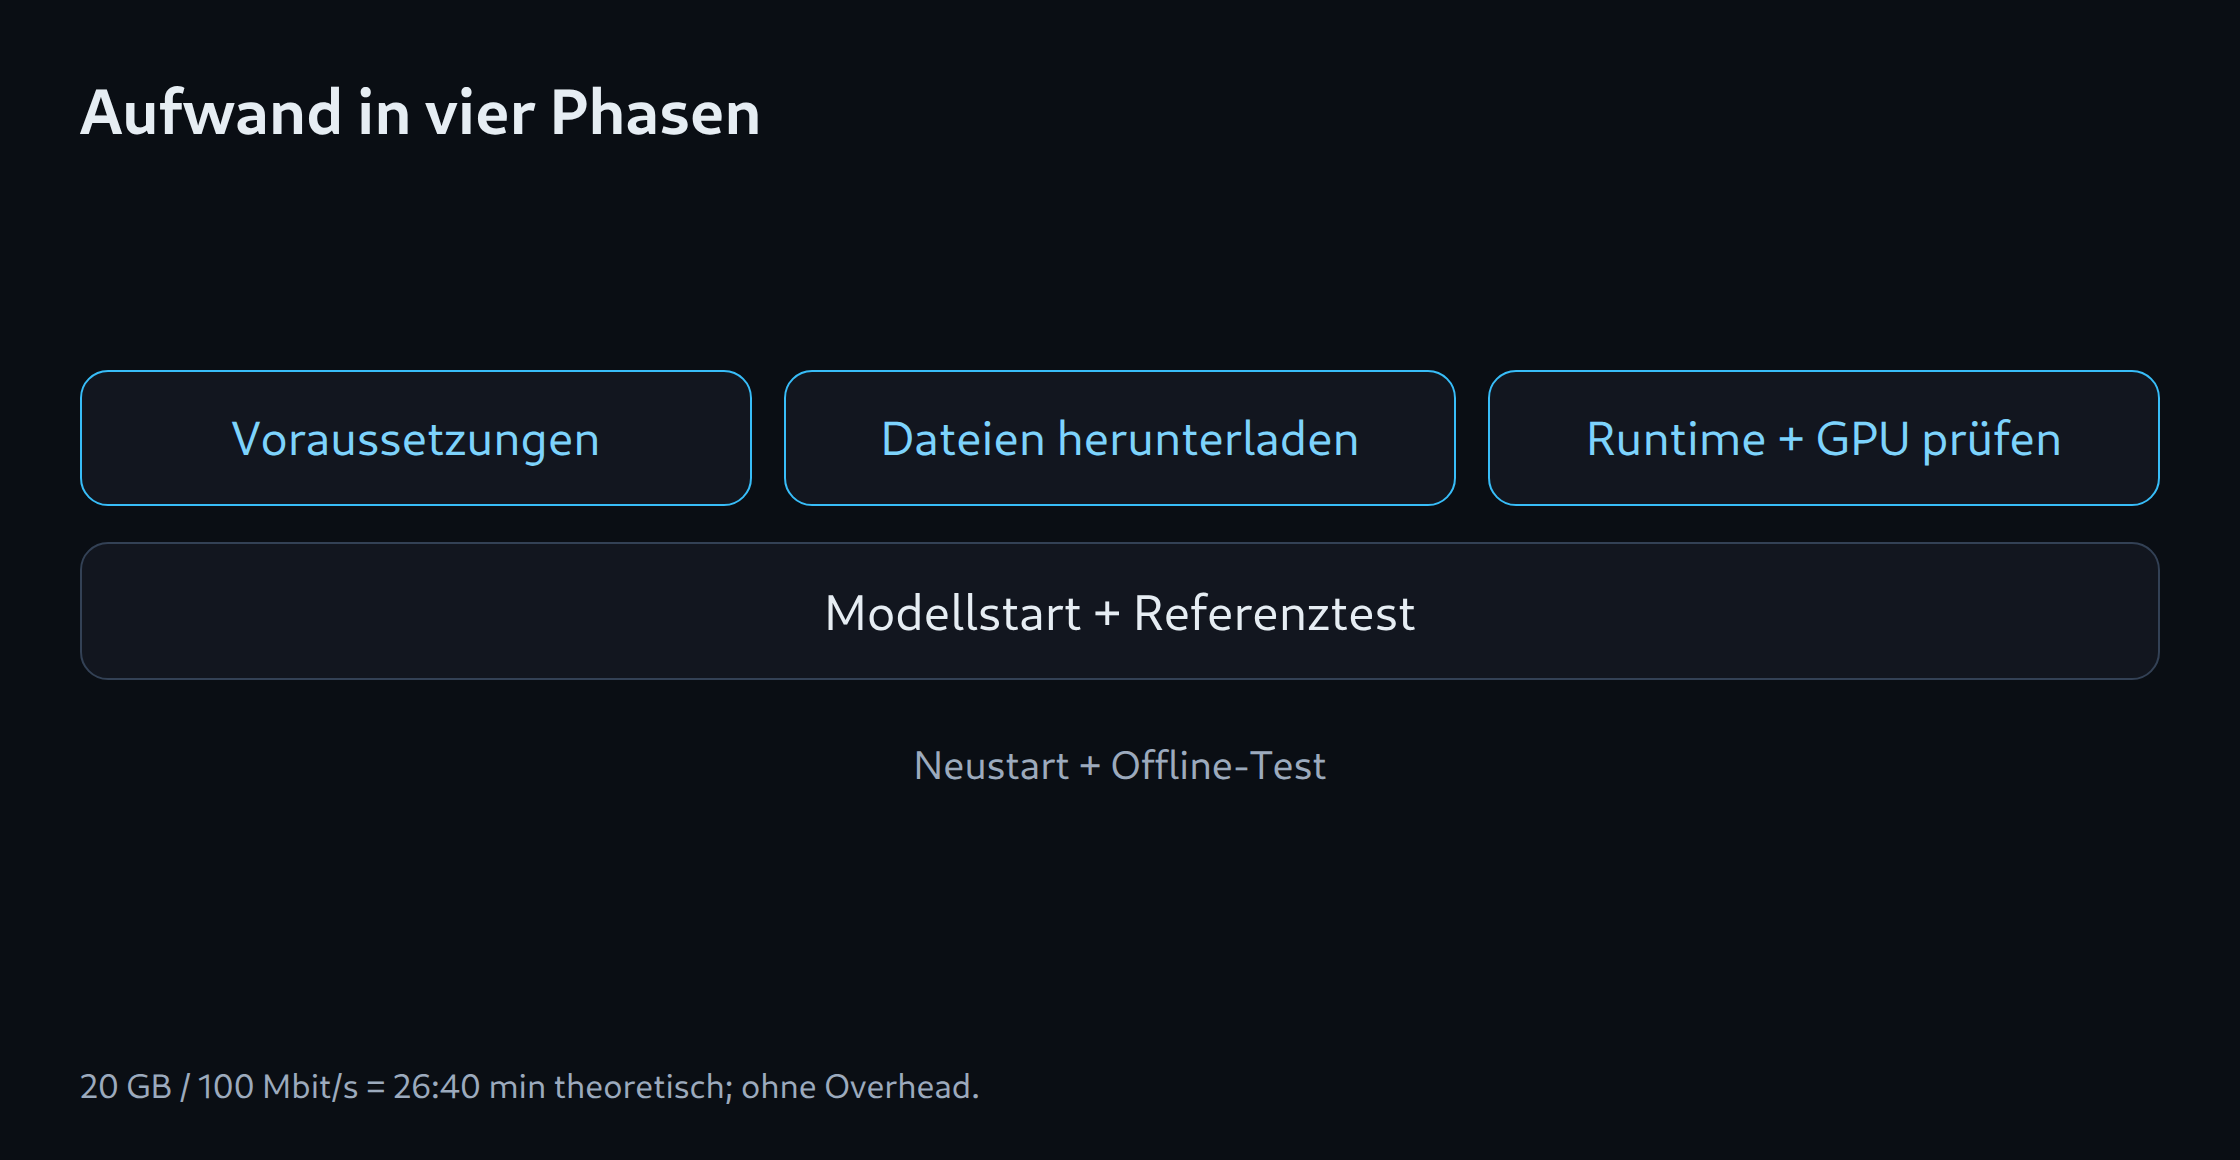
Die erste Prüfung umfasst Betriebssystem, GPU-Modell, freien Speicher und Zielmodell. Darauf folgt der dokumentierte Backend-Pfad. Ein ausreichender Festplattenplatz ist ebenso nötig: mehrere Quantisierungen und Zwischenstände können deutlich mehr Platz als eine einzelne Modelldatei beanspruchen.
Für den Einstieg genügt ein kleines unterstütztes Modell mit einer kurzen Testaufgabe als Vergleich. Große Kontextfenster und mehrere Nutzer kommen später. So prüfst Du zuerst die Grundinstallation und anschließend die Kapazitätsgrenzen. Ein fehlgeschlagener Start eines großen Modells wird dadurch nicht vorschnell als Treiberfehler eingeordnet.
Downloadzeit ist kein Installationsbenchmark
Ein angenommenes 20-GB-Artefakt benötigt bei konstanten 100 Mbit/s theoretisch 1.600 Sekunden, also 26 Minuten und 40 Sekunden. Bei 1 Gbit/s sind es theoretisch 160 Sekunden. Die Rechnung verwendet Dezimal-GB und ignoriert Protokolloverhead, Schwankungen und Serverlimits.
Diese Wartezeit sagt nichts über die Schwierigkeit der Einrichtung. Ein Vergleich protokolliert deshalb Download, Paketinstallation, ersten Modellstart und Fehlerbehebung separat. Ein schneller Anschluss kann eine komplizierte Installation verdecken; ein langsamer Anschluss kann einen einfachen Weg lang erscheinen lassen.
GPU-Ausführung nachweisen
Eine erhaltene Antwort ist kein Beleg für GPU-Betrieb. Runtime-Logs und Geräteauslastung müssen zum gewählten Backend passen. Bei Ollama zeigen Modell- und Prozessübersicht den aktuellen Zustand; eine kurze Referenzaufgabe ergänzt die technische Prüfung.
ollama list
ollama ps
Auch nach einem erfolgreichen Start kann das Ergebnis anders ausfallen: etwa wenn unbemerkt auf die CPU ausgewichen wird, das Chat-Template falsch ist oder die Quantisierung nicht unterstützt wird. Treten nach einer längeren Eingabe Speicherfehler auf, müssen dagegen Kontext und Speicherreserve geprüft werden. Eine Neuinstallation allein reicht für diese Prüfung nicht aus.
Erstinstallation von Dauerbetrieb unterscheiden
Der Abschluss besteht aus funktionierendem Modellwechsel, Neustart und einer geprüften Sitzung ohne Netzverbindung. Offline-Nutzung setzt voraus, dass alle benötigten Dateien bereits vorliegen und keine externen Werkzeuge aufgerufen werden. Cloud-Funktionen einer Oberfläche bleiben separat.
Ein API-Dienst sollte zunächst nur lokal erreichbar sein. Öffentlicher Betrieb ergänzt Zugangsschutz, Lastgrenzen und Wartung; der vorhandene Gateway-Bestand behandelt diese nächste Stufe. Ein kleiner Desktop-Chat braucht diese Infrastruktur nicht automatisch. Der Speicherrechner hilft vor dem Modellkauf beziehungsweise Hardwarekauf, während die dokumentierte Installationskette den tatsächlichen Aufwand bestimmt.
Speicherbedarf für die Modellwahl: LLM-VRAM-Rechner.
Passende Werkzeuge
Fragen und Antworten
Bedeutet ein erfolgreicher Modellstart, dass die GPU arbeitet?
Ein startendes Modell kann vollständig oder teilweise auf der CPU laufen. Backend-Protokoll, GPU-Speicherbelegung und Geräteauslastung liefern die nötigen Hinweise.
Funktioniert ein lokales LLM ohne Internet?
Nach dem Download der benötigten Dateien ist Offline-Inferenz mit geeigneter Software möglich. Modellnachladen, Updates, externe Werkzeuge und Cloud-Funktionen können weiterhin Verbindungen benötigen. Ein Test mit unterbrochener Verbindung prüft die konkrete Konfiguration.
Quellen
- Ollama: Hardware support
- vLLM: GPU installation
- llama.cpp: Projekt und Backends
- LM Studio: Dokumentation
Quellen geprüft: 5. Oktober 2026.
Passend dazu