Polski
Od pobrania do pierwszej odpowiedzi: jak trudne jest uruchomienie lokalnego modelu LLM?

Spis treści
Uruchomienie lokalnego LLM bywa dziś prostsze niż utrzymanie pełnego serwera AI. Aplikacja komputerowa może łączyć wybór modelu i start. Rzeczywisty nakład pracy ujawnia się jednak przy sterownikach, pobieraniu, wykrywaniu GPU i kontroli poprawnej konfiguracji w dłuższej pracy.
Porównanie opisuje ścieżki instalacji i weryfikację. Stałe czasy dla niesprawdzonych urządzeń nie byłyby wiarygodne. Czas pobierania i konfiguracji jest więc rozdzielony.
Odpowiedni początek według systemu
| System | Prosta ścieżka startowa | Dodatkowa praca |
|---|---|---|
| Windows | LM Studio lub Ollama z właściwym backendem | Sterownik; vLLM między innymi przez WSL |
| macOS / Apple Silicon | Aplikacja lub środowisko Apple | Zgodny artefakt i zapas pamięci |
| Linux | Ollama lub gotowy program llama.cpp | Pakiety, urządzenie i start usługi |
| Serwer Linux | vLLM ze zgodnym GPU | Zgodność modelu i kernela |
Cztery warunki przed pobraniem
Pierwsza kontrola obejmuje system, model GPU, wolną pamięć i docelowy model. Następny krok to udokumentowana ścieżka backendu. Potrzebne jest też miejsce na dysku: kilka kwantyzacji i pliki pośrednie mogą zajmować znacznie więcej niż jeden artefakt.
Zacznij od małego obsługiwanego modelu i krótkiego zadania testowego, które posłuży do porównania. Długi kontekst i wielu użytkowników przyjdą później. W ten sposób oddzielisz sprawdzenie podstawowej instalacji od jej ograniczeń pojemności. Nie trzeba wtedy z góry uznawać każdego nieudanego startu dużego modelu za błąd sterownika.
Pobieranie nie jest benchmarkiem konfiguracji
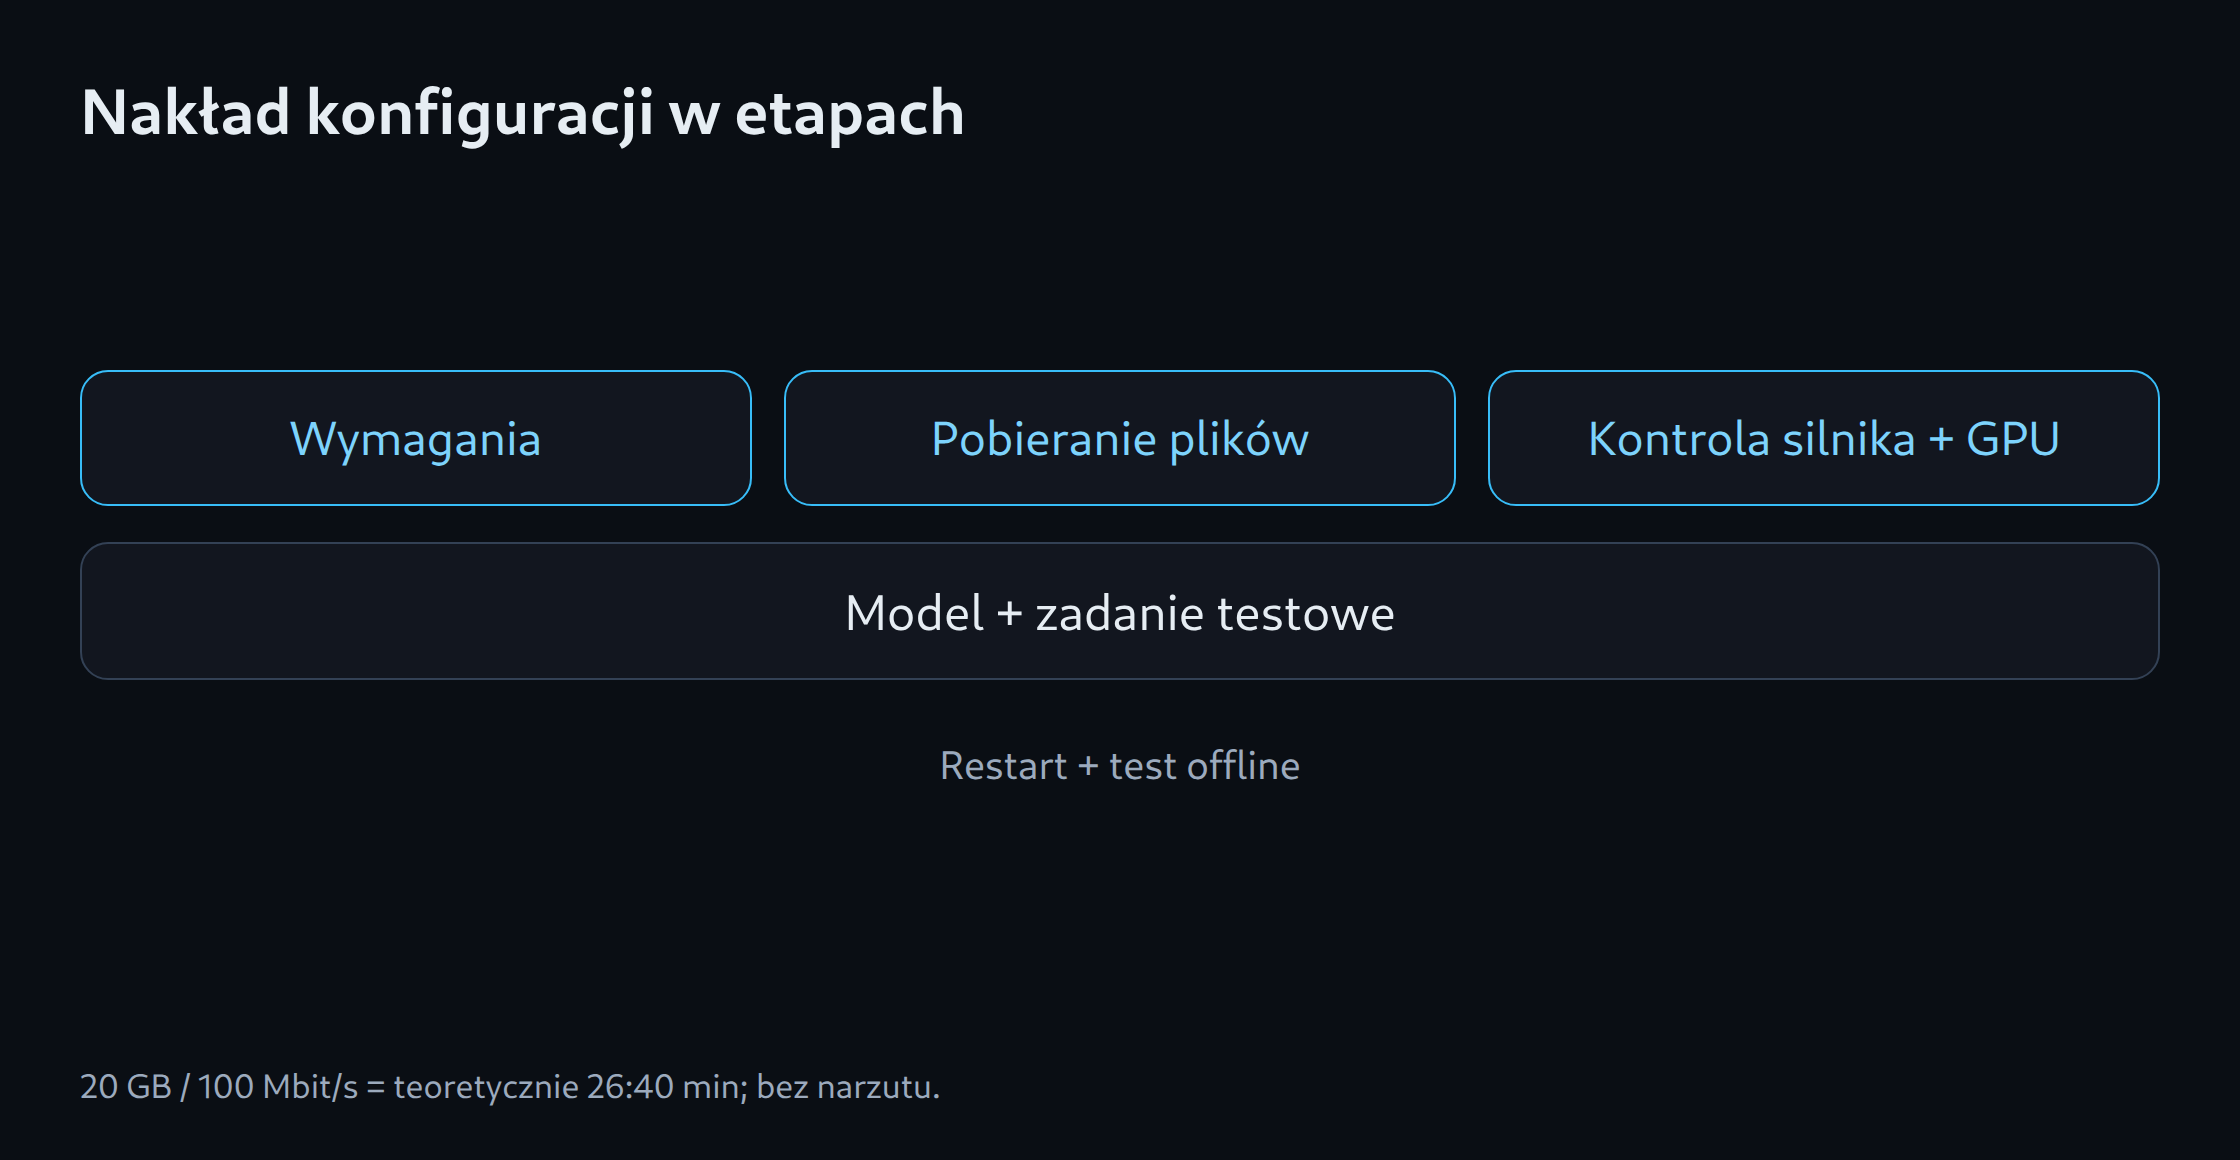
Założony artefakt 20 GB przy stałych 100 Mbit/s potrzebuje teoretycznie 1600 sekund, czyli 26 minut i 40 sekund. Przy 1 Gbit/s czas wynosi 160 sekund. Obliczenie stosuje dziesiętne GB, bez narzutu protokołu, wahań i limitów serwera.
Oczekiwanie nie określa trudności instalacji. Porównanie zapisuje osobno pobieranie, pakiety, pierwszy start i diagnozowanie. Szybkie łącze może ukrywać złożoną konfigurację, a wolne może wydłużać prostą ścieżkę.
Potwierdzenie pracy GPU
Uzyskana odpowiedź nie dowodzi pracy GPU. Logi i obciążenie muszą odpowiadać wybranemu backendowi. Listy modeli i procesów Ollama pokazują bieżący stan; krótkie zadanie referencyjne uzupełnia kontrolę.
ollama list
ollama ps
Wynik może się różnić nawet po udanym uruchomieniu: program może niezauważenie przejść na CPU, używać niewłaściwego szablonu czatu lub nieobsługiwanej kwantyzacji. Jeśli błędy pamięci pojawiają się po dłuższym wejściu, trzeba sprawdzić kontekst i zapas pamięci. Sama ponowna instalacja nie zastępuje tej kontroli.
Pierwszy start a stała praca
Zakończenie obejmuje działającą zmianę modelu, restart i sprawdzoną sesję bez sieci. Praca offline wymaga wszystkich plików wcześniej oraz braku zewnętrznych wywołań narzędzi. Funkcje chmurowe interfejsu pozostają osobne.
Usługa API powinna początkowo działać wyłącznie lokalnie. Publiczny serwer dodaje ochronę dostępu, limity i utrzymanie; istniejące artykuły o bramie opisują kolejny etap. Mały czat nie potrzebuje automatycznie tej infrastruktury. Kalkulator pamięci pomaga przed wyborem modelu lub sprzętu, a zapisany przebieg instalacji określa rzeczywisty nakład.
Planowanie pamięci przy wyborze modelu: kalkulator VRAM dla LLM.
Powiązane narzędzia
Pytania i odpowiedzi
Czy poprawne uruchomienie modelu potwierdza pracę GPU?
Model może działać w całości lub częściowo na CPU. Potrzebne informacje zapewniają logi backendu, zajętość pamięci GPU i obciążenie urządzenia.
Czy lokalny model LLM działa bez internetu?
Inferencja offline jest możliwa przy odpowiednim oprogramowaniu po pobraniu wszystkich wymaganych plików. Pobieranie modeli, aktualizacje, narzędzia zewnętrzne i funkcje chmurowe mogą nadal wymagać połączenia. Test bez sieci weryfikuje konkretną konfigurację.
Źródła
- Ollama: Hardware support
- vLLM: GPU installation
- llama.cpp: Projekt und Backends
- LM Studio: Dokumentation
Źródła sprawdzone: 5 października 2026.
Powiązane artykuły