English
 Deutsch
 Polski
Wenn KI Inhalte liest: Pay per Crawl, Datenlizenz oder bezahlte API?

Inhalt
Ein KI-Crawler kann Inhalte abrufen, ohne einen menschlichen Besuch oder Werbeumsatz auszulösen. Daraus entsteht die Frage, ob der Abruf selbst, ein vereinbartes Nutzungsrecht oder ein aufbereitetes Datenprodukt bezahlt werden sollte. Diese drei Modelle verkaufen unterschiedliche Leistungen.
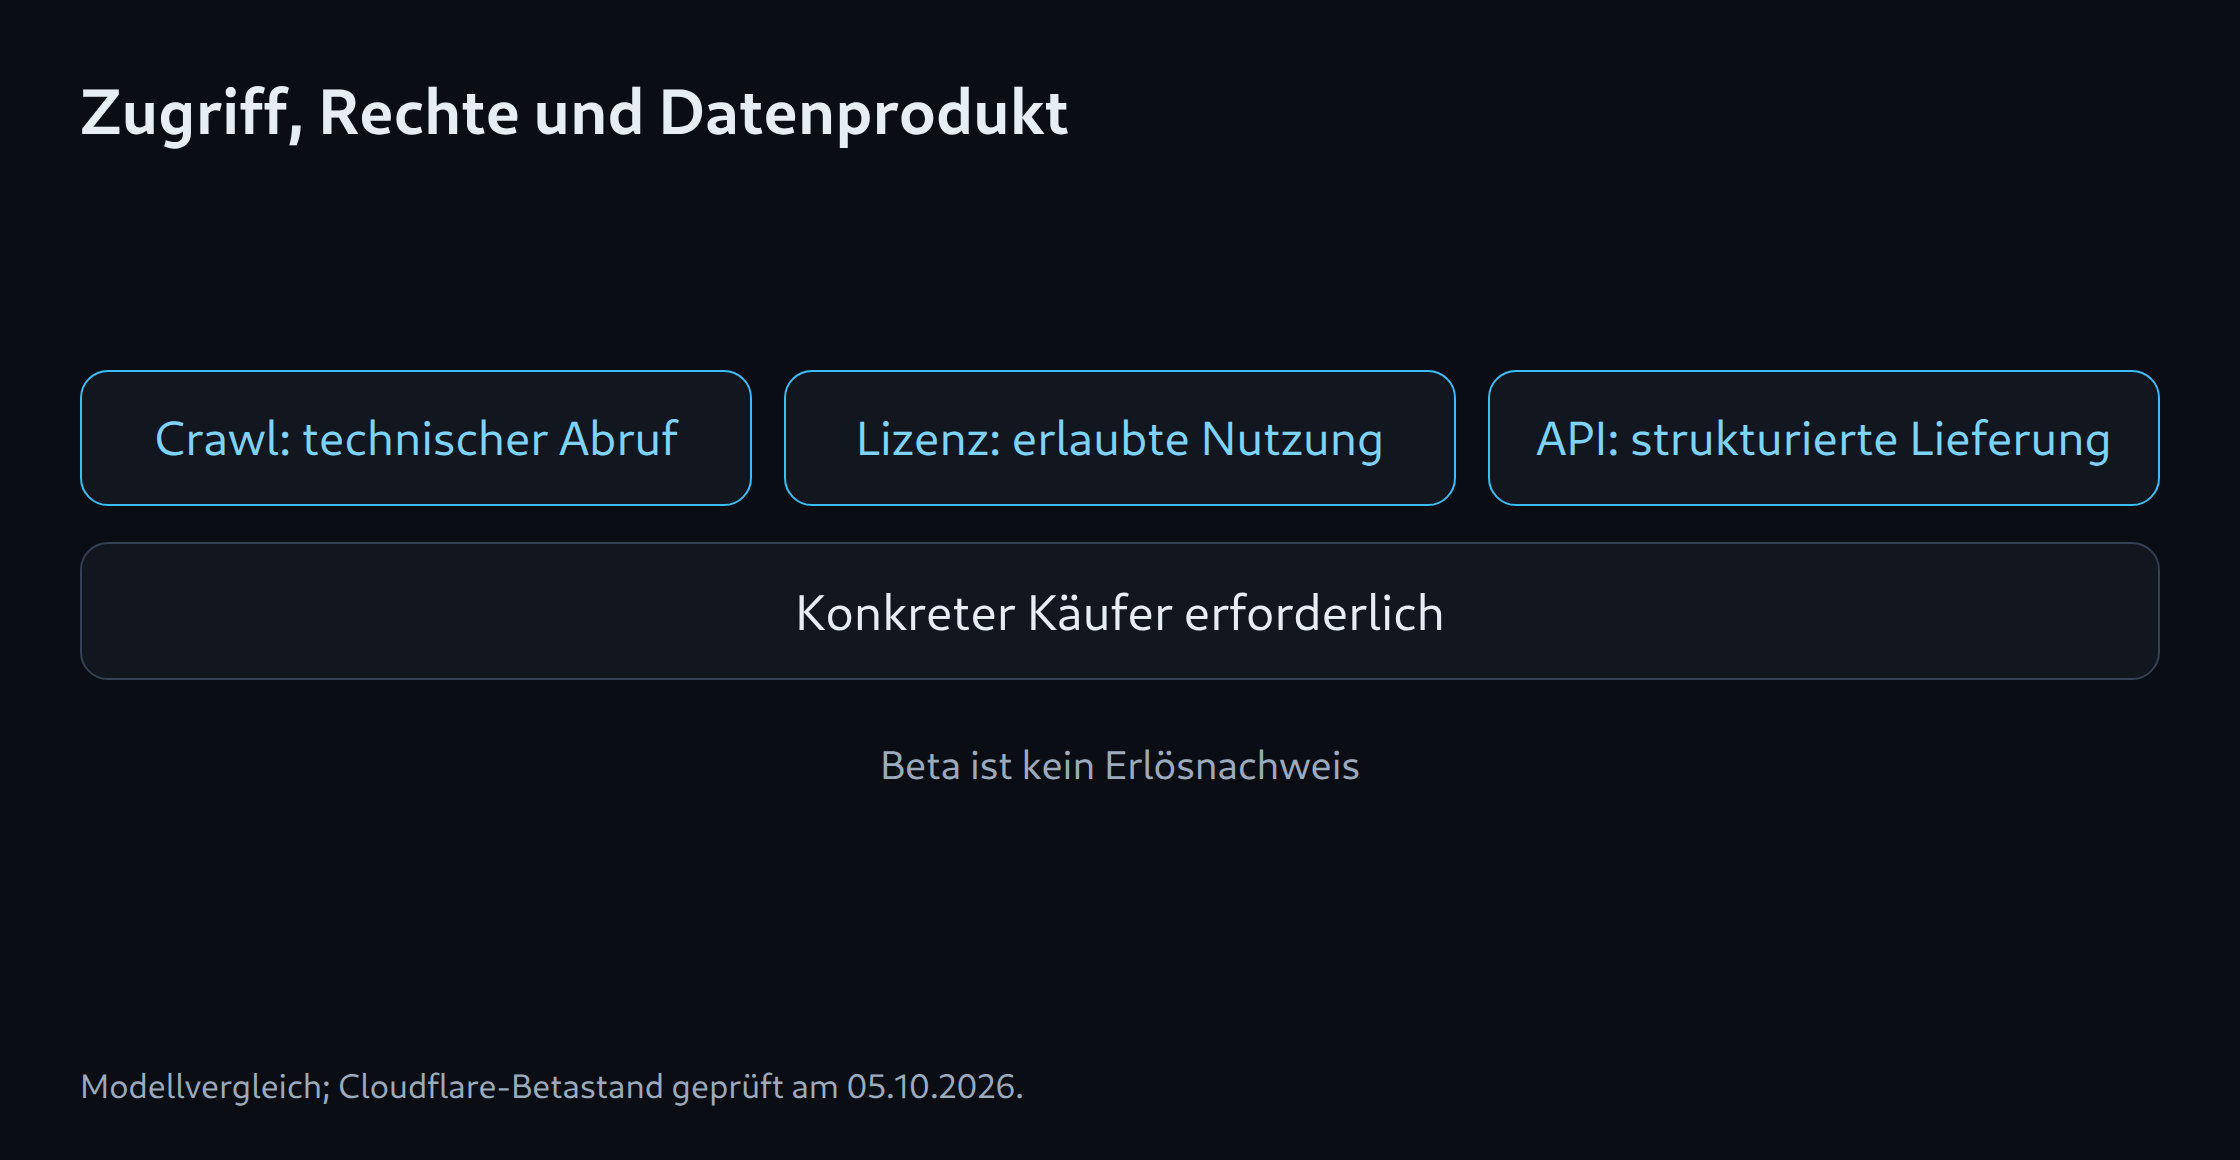
Drei Ebenen auseinanderhalten
| Modell | Verkaufte Leistung | Voraussetzung |
|---|---|---|
| Pay per Crawl | Bezahlter technischer Zugriff | Teilnehmender, zahlungsbereiter Crawler |
| Datenlizenz | Vereinbarter Nutzungsumfang | Passende Rechte und ein konkreter Käufer |
| Bezahlte API | Strukturierte, verlässliche Datenlieferung | Datenqualität, Betrieb und Integration |
Was Cloudflare beschreibt
Cloudflare dokumentiert einen Ablauf mit HTTP 402 Payment Required und Preisangabe. Ein teilnehmender Crawler kann Zahlungsbereitschaft signalisieren; bestätigte kostenpflichtige Abrufe werden erfasst. Das ist kein automatisches Bezahlsystem für beliebige Bots. [1]
Die öffentlich zugängliche Anmeldeseite bezeichnet Pay per Crawl am 5. Oktober 2026 weiterhin als private Beta. AI Crawl Control und die kostenpflichtige Zugriffsfunktion sind zu unterscheiden. Eine Beta-Anmeldung belegt weder Freischaltung noch zahlende Nachfrage. [2]
Technischer Zugriff ist kein vollständiges Nutzungsrecht
Ein Abruf beschreibt Transport. Eine Datenlizenz kann darüber hinaus Zweck, Laufzeit, Weitergabe, Speicherung und erlaubte Verarbeitung festlegen. Der konkrete Umfang verlangt einen passenden Vertrag und ausreichende Rechte am Material. Ein Preissignal allein beantwortet diese Fragen nicht.
Öffentlich sichtbare Beiträge enthalten möglicherweise fremde Abbildungen oder eingebettete Inhalte. Das Recht, eine Seite zu veröffentlichen, ist nicht automatisch ein umfassendes Recht, sämtliche Bestandteile als Datenpaket weiterzulizenzieren. Für ein Angebot müssen die tatsächlich verfügbaren Inhalte und Rechte getrennt erfasst werden.
Wann eine API mehr Wert bietet
Eine API kann ausgewählte, strukturierte und aktualisierte Datensätze liefern. Der Käufer bezahlt dann nicht nur Zugang, sondern eindeutige Felder, Versionierung und einen verlässlichen Änderungsablauf. Ein Spezialkatalog mit klarer Herkunft ist ein anderes Produkt als HTML einer frei erreichbaren Seite.
Betrieb kostet: Authentifizierung, Ratenlimits, Verfügbarkeit, Korrekturen und Support. Export und Löschung müssen zur angebotenen Nutzung passen. Eine API ohne konkreten Integrationskunden ist zunächst Technik, kein bewiesenes Geschäft.
Ein vorsichtiger Geschäftsversuch
Zunächst werden eigene Inhalte, mögliche Käufer und tatsächlich erforderliche Daten bestimmt. Ein Beispieldatensatz und ein beschriebener Nutzungsumfang dienen als Gesprächsgrundlage. Für einen Abrufpilot zählen akzeptierte Zahlungsereignisse, Einnahmen, betriebliche Kosten und Änderungen anderer Zugriffe. Auf dieser Website wurde dafür keine Crawl-Sperre oder Bezahlschranke aktiviert.
robots.txt regelt Crawling für beachtende Clients und schützt keine vertraulichen Daten. Suchcrawler, AI-Crawler und zahlende Datenkunden brauchen getrennte Regeln. Eine allgemeine Sperre kann daher Folgen außerhalb des geplanten Angebots haben. [3]
Am belastbarsten ist der Weg mit einem identifizierten Käufer und einer klar abgegrenzten Leistung. Pay per Crawl ist eine interessante Infrastrukturhypothese; Datenlizenz und API bleiben eigenständige Geschäftsmodelle.
Passende Werkzeuge
Fragen und Antworten
Bezahlt jeder KI-Crawler automatisch?
Nein. Das beschriebene Verfahren setzt teilnehmende Crawler und Zahlungsbereitschaft voraus.
Wurde auf diesem Blog Pay per Crawl aktiviert?
Nein. Der Artikel beschreibt Modelle; es wurden keine Sperren oder Zahlungsregeln eingebaut.
Quellen
- Cloudflare: Introducing pay per crawl
- Cloudflare: Pay per crawl private beta
- Google: Robots.txt limitations
Quellen geprüft: 5. Oktober 2026.
Passend dazu