English
 Polski
Gdy AI czyta treści: Pay per Crawl, licencja danych czy płatne API?

Spis treści
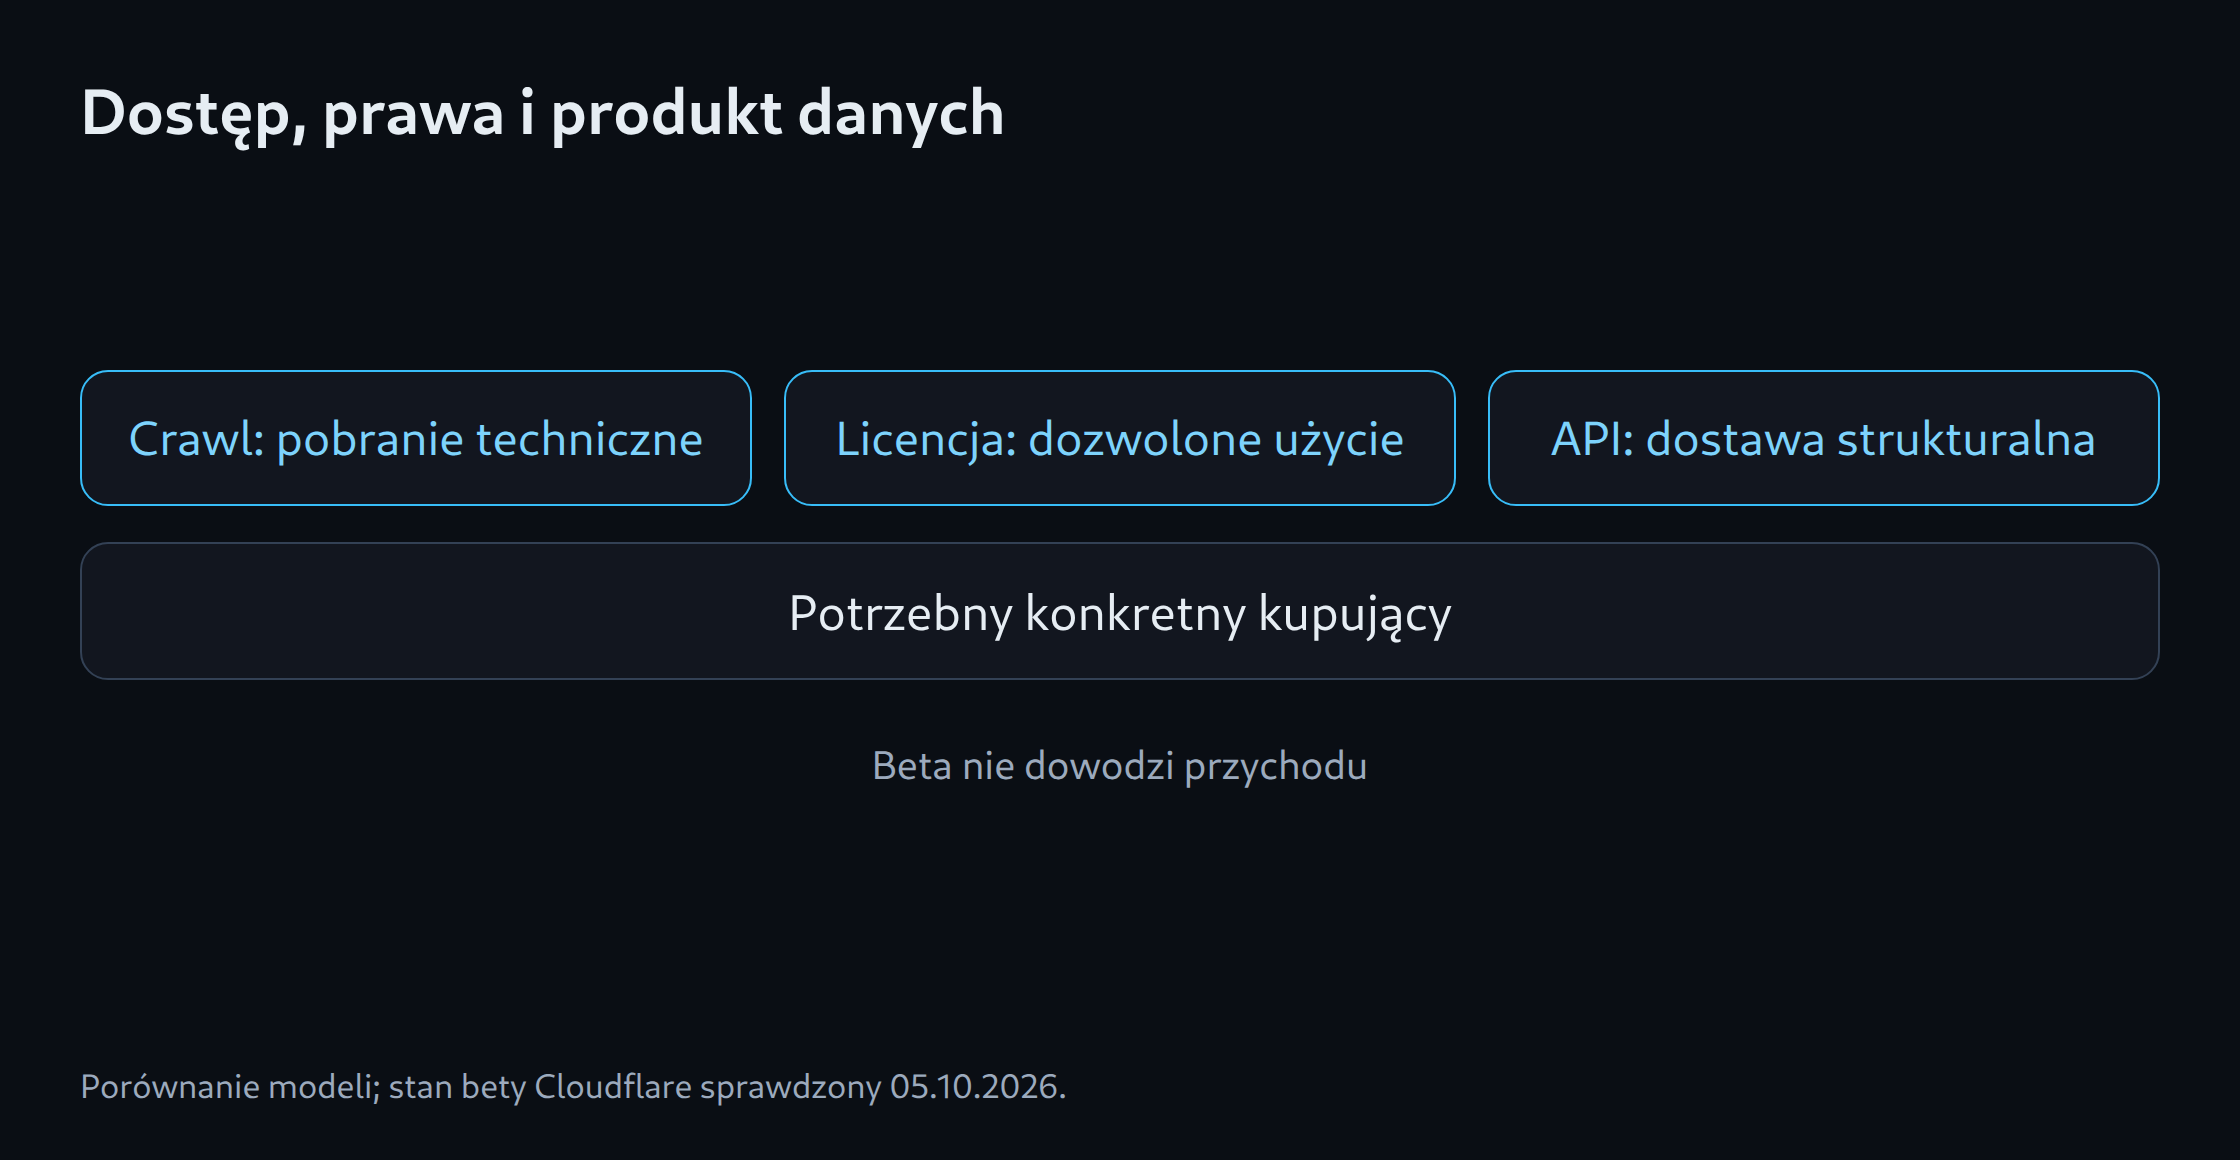
Robot AI może pobierać treść bez wizyty człowieka i przychodu reklamowego. Opłata może dotyczyć samego dostępu, uzgodnionych praw albo przygotowanych danych. To trzy różne usługi.
Trzy warstwy
| Model | Sprzedawana usługa | Warunek |
|---|---|---|
| Pay per Crawl | Płatny dostęp techniczny | Robot uczestniczący i gotowy zapłacić |
| Licencja danych | Uzgodniony zakres użycia | Prawa i konkretny odbiorca |
| Płatne API | Uporządkowana, niezawodna dostawa | Jakość, utrzymanie i integracja |
Mechanizm opisany przez Cloudflare
Cloudflare opisuje odpowiedź HTTP 402 Payment Required z informacją o cenie. Uczestniczący robot może zadeklarować płatność; potwierdzone płatne pobrania są rejestrowane. Nie oznacza to automatycznej opłaty od dowolnego bota. [1]
Publiczna strona zapisów 5 października 2026 roku nadal określa Pay per Crawl jako prywatną betę. AI Crawl Control i płatny dostęp są odrębne. Zgłoszenie nie dowodzi aktywacji ani popytu. [2]
Dostęp nie jest pełną licencją
Pobranie opisuje transport. Licencja może określać cel, czas, dalsze udostępnienie, przechowywanie i przetwarzanie. Zakres wymaga umowy i odpowiednich praw. Sama cena nie odpowiada na te pytania.
Publiczne artykuły mogą zawierać cudze ilustracje lub osadzone materiały. Prawo publikacji strony nie oznacza automatycznie prawa do ponownego licencjonowania wszystkich elementów jako danych. Materiały i prawa wymagają oddzielnego spisu.
Kiedy API daje więcej wartości
API może dostarczać wybrane, uporządkowane i aktualne rekordy. Odbiorca płaci wtedy za określone pola, wersjonowanie i niezawodny proces aktualizacji danych. Specjalistyczny katalog z jasnym pochodzeniem różni się od publicznego HTML.
Uwierzytelnianie, limity, dostępność, korekty i obsługa kosztują. Eksport i usuwanie muszą pasować do oferowanego użycia. Bez konkretnego klienta integracji API jest techniką, nie potwierdzonym biznesem.
Ograniczona próba biznesowa
Najpierw potrzebne są własne treści, potencjalni kupujący i wymagane dane. Próbka oraz zakres użycia stanowią podstawę rozmowy. Pilotaż dostępu mierzyłby zaakceptowane płatności, przychód, koszty i zmiany innych odwiedzin. Na tej witrynie nie aktywowano blokad ani opłat dla robotów.
Plik robots.txt kieruje robotami respektującymi reguły i nie chroni danych poufnych. Roboty wyszukiwarek, AI i płatni odbiorcy wymagają oddzielnych zasad. Ogólna blokada może wpłynąć na działania poza planowanym produktem. [3]
Najbardziej wiarygodna droga ma określonego odbiorcę i ograniczoną usługę. Pay per Crawl pozostaje ciekawą hipotezą infrastruktury; licencje i API są osobnymi modelami.
Powiązane narzędzia
Pytania i odpowiedzi
Czy każdy robot AI automatycznie płaci?
Nie. Opisany protokół wymaga uczestnictwa i gotowości zapłaty.
Czy włączono Pay per Crawl na tym blogu?
Nie. Artykuł opisuje modele; nie wprowadzono blokad ani opłat.
Źródła
- Cloudflare: Introducing pay per crawl
- Cloudflare: Pay per crawl private beta
- Google: Robots.txt limitations
Źródła sprawdzone: 5 października 2026.
Powiązane artykuły