English
 Deutsch
 Polski
Self-Hosted Large Language Model (LLM) mit Ollama hinter einem Auth-Proxy

Inhalt
Das Übertragen vertraulicher Unternehmensdokumente, Kundendaten und Quellcodes an öffentliche Large-Language-Model-APIs (LLM) wie OpenAI, Anthropic oder Google Gemini birgt gravierende Datenschutzrisiken und potenzielle DSGVO-Verstöße. Das Hosting offener KI-Modelle – wie Llama 3.1, Mistral oder CodeLlama – auf firmeneigener Server-Hardware garantiert absolute Datenhoheit. Da der populäre Inferenzserver Ollama seine REST-API standardmäßig auf Port 11434 völlig ohne native Authentifizierung bereitstellt, erfordert der sichere Betrieb im Unternehmensnetzwerk eine geschützte Architektur: einen Nginx-Reverse-Proxy zur Durchsetzung strenger Authentifizierung und TLS-Verschlüsselung.
1. Architektur-Grundlagen: Sichere Edge-Inferenz-Pipeline
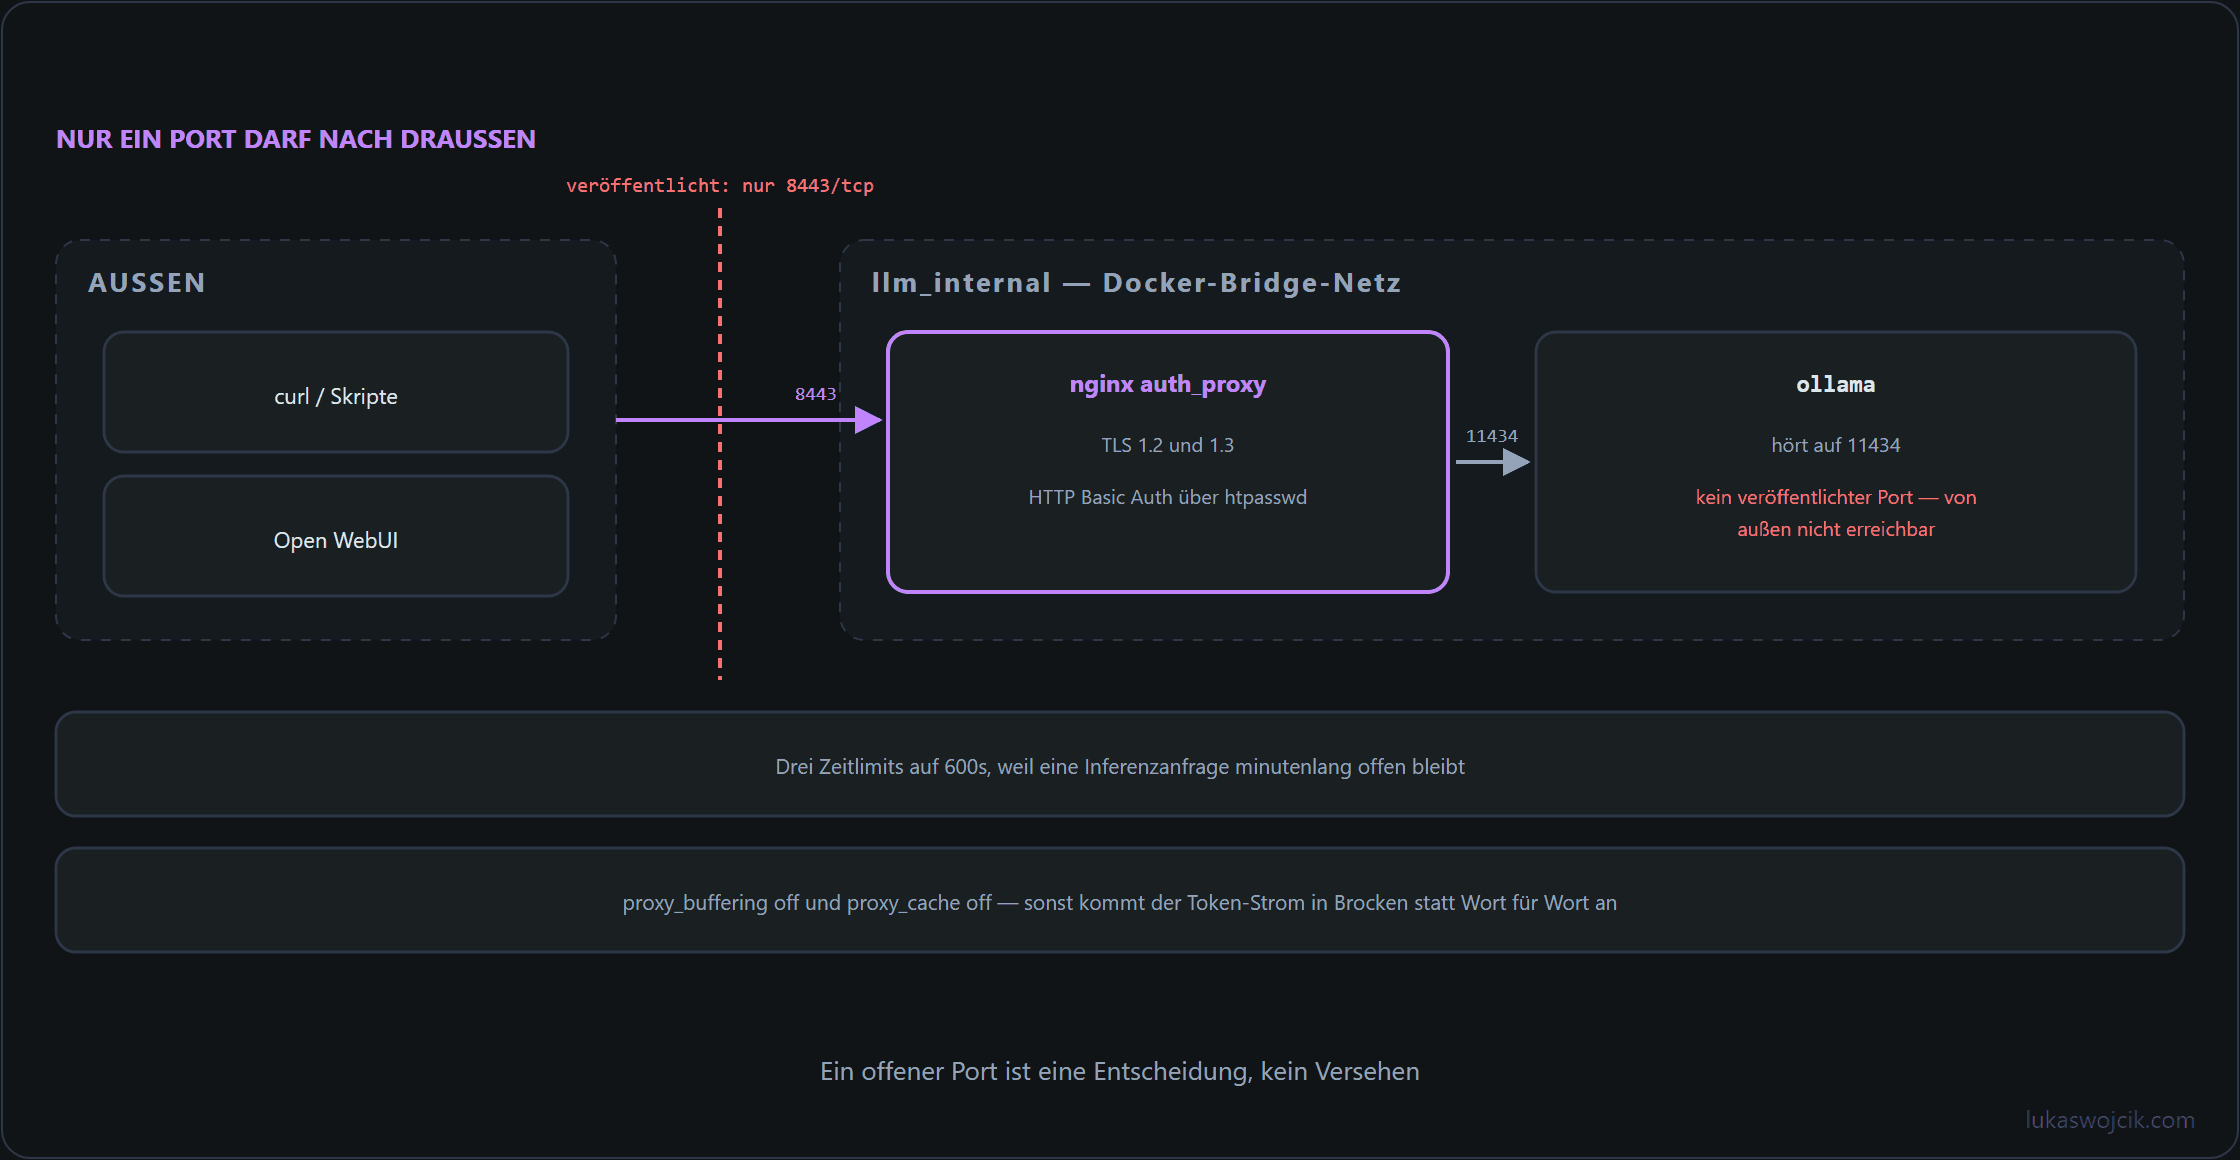
Ein professionelles, lokales LLM-Deployment entkoppelt die Modellausführung von der Netzwerkfreigabe durch die Schichtung dreier isolierter Dienste innerhalb einer Container-Umgebung:
- Ollama-Inferenz-Backend: Führt offene LLM-Gewichte unter Nutzung von NVIDIA-GPU-Beschleunigung (via NVIDIA Container Toolkit) oder CPU-Quantisierung aus und ist ausschließlich an interne Container-Netzwerkschnittstellen gebunden.
- Nginx-Authentifizierungs- & TLS-Proxy: Agiert als zentraler Einlasspunkt, fängt sämtliche HTTP-Anfragen ab, terminiert SSL/TLS-Zertifikate und validiert HTTP-Basic-Auth-Zugangsdaten, bevor Anfragen an Ollama weitergeleitet werden.
- OpenAI-kompatibles Frontend / Skripte: Interne Web-Oberflächen (wie Open WebUI) oder automatisierte Python-Skripte kommunizieren über standardisierte OpenAI-SDK-Syntaxen mit dem abgesicherten Endpunkt, ohne den Sicherheits-Proxy zu umgehen.
2. Schritt-für-Schritt-Container- & GPU-Bereitstellung
Um Ollama zusammen mit einem dedizierten Nginx-Reverse-Proxy zu betreiben, wird die folgende produktionsreife docker-compose.yml für GPU-Passthrough und isoliertes Networking bereitgestellt:
services:
  ollama:
    image: ollama/ollama:latest
    container_name: enterprise_ollama
    restart: always
    environment:
      - OLLAMA_HOST=0.0.0.0
      - OLLAMA_ORIGINS=*
    volumes:
      - ./ollama_data:/root/.ollama
    deploy:
      resources:
        reservations:
          devices:
            - driver: nvidia
              count: all
              capabilities: [gpu]
    networks:
      - llm_internal

  auth_proxy:
    image: nginx:alpine
    container_name: ollama_auth_proxy
    restart: always
    ports:
      - "8443:443"
    volumes:
      - ./nginx.conf:/etc/nginx/nginx.conf:ro
      - ./certs:/etc/nginx/certs:ro
      - ./htpasswd:/etc/nginx/.htpasswd:ro
    depends_on:
      - ollama
    networks:
      - llm_internal

networks:
  llm_internal:
    driver: bridge
3. Schritt-für-Schritt-Konfiguration des Nginx-Auth-Proxys
Um den API-Zugriff ausschließlich auf autorisierte Unternehmensanwendungen zu beschränken, wird Nginx mit HTTP Basic Authentication konfiguriert. Das folgende nginx.conf-Skript erzwingt die Authentifizierung und verlängert Timeouts für langandauernde Streaming-Inferenz-Antworten:
events {
    worker_connections 1024;
}

http {
    upstream ollama_backend {
        server ollama:11434;
    }

    server {
        listen 443 ssl;
        server_name llm.internal.domain;

        ssl_certificate /etc/nginx/certs/server.crt;
        ssl_certificate_key /etc/nginx/certs/server.key;
        ssl_protocols TLSv1.2 TLSv1.3;

        # Erzwingung von HTTP Basic Auth (Erstellung via: htpasswd -c ./htpasswd api_user)
        auth_basic "Enterprise LLM Secure Gateway";
        auth_basic_user_file /etc/nginx/.htpasswd;

        # Obligatorische Timeout-Erweiterungen für langes Inferenz-Streaming
        proxy_read_timeout 600s;
        proxy_connect_timeout 600s;
        proxy_send_timeout 600s;

        location / {
            proxy_pass http://ollama_backend;
            proxy_set_header Host $host;
            proxy_set_header X-Real-IP $remote_addr;
            proxy_set_header X-Forwarded-For $proxy_add_x_forwarded_for;
            proxy_set_header X-Forwarded-Proto $scheme;

            # Streaming-Unterstützung für Server-Sent Events (SSE)
            proxy_buffering off;
            proxy_cache off;
        }
    }
}
4. Schritt-für-Schritt-Verifizierung mit Skripten & Web UI
Sobald der Proxy aktiv ist, lässt sich die Inferenz-Engine sicher über Skripte abfragen oder in Chat-Oberflächen anbinden:
- Modell-Download: Der initiale Modell-Download erfolgt direkt im Container über das CLI:
docker exec -it enterprise_ollama ollama run llama3.1 - Python-API-Verifizierung: Versand einer authentifizierten HTTPS-REST-Anfrage an den Proxy unter Angabe der Basic-Auth-Zugangsdaten:
curl -k -u "api_user:SecretPassword123" https://localhost:8443/api/generate -d '{"model": "llama3.1", "prompt": "Zusammenfassung der Datenschutzrichtlinie.", "stream": false}' - Anbindung an Open WebUI: Bereitstellung des
open-webui-Docker-Containers im selben Netzwerk unter Konfiguration der Endpunkt-Umgebungsvariable:OLLAMA_BASE_URL=https://api_user:SecretPassword123@auth_proxy:443
5. Zusammenfassung & Mehrwert
Was sich damit erreichen lässt: Die erfolgreiche Bereitstellung eines selbstgehosteten, GPU-beschleunigten Inferenz-Servers für offene LLMs mit Ollama, abgesichert durch einen Nginx-Authentifizierungs- und SSL/TLS-Reverse-Proxy.
Resultierender Mehrwert: Ein privates, leistungsstarkes „ChatGPT“-Äquivalent steht für interne Unternehmensabläufe, Software-Skripte und Mitarbeiter-Benutzeroberflächen zur Verfügung, ohne dass sensible Daten an externe KI-Anbieter abfließen. Die absolute Datenhoheit und vollständige DSGVO-Konformität sind gewährleistet, während obligatorische Authentifizierungsmechanismen unbefugte Zugriffe auf die Rechenressourcen verhindern.
Fragen und Antworten
Warum setzt der Proxy Timeouts von 600 Sekunden, und gelten sie für die ganze Antwort?
Nicht für die ganze Antwort. proxy_read_timeout begrenzt laut nginx-Dokumentation nur die Zeit zwischen zwei Lesevorgängen; der Standardwert liegt bei 60 Sekunden. Beim Streaming kommt mit jedem erzeugten Token ein neues Stück der Antwort, und die Frist beginnt von vorn. Kritisch ist der Betrieb ohne Streaming wie im curl-Beispiel mit "stream": false. Dann sendet Ollama erst die fertige Antwort. Läuft das Modell auf der CPU oder lädt Ollama es beim ersten Aufruf erst in den Speicher, können bis dahin mehr als 60 Sekunden vergehen, und ohne längere Frist bricht nginx mit dem Status 504 ab.
Bei proxy_connect_timeout bringt der hohe Wert dagegen nichts. Die Verbindung zum Container im selben Docker-Netz steht in Sekundenbruchteilen, und laut Dokumentation lässt sich diese Frist in der Regel ohnehin nicht über 75 Sekunden ausdehnen.
Ist Ollama mit OLLAMA_HOST=0.0.0.0 am Proxy vorbei erreichbar?
In dieser Compose-Datei nicht von außen. Die Variable lässt Ollama auf allen Schnittstellen des Containers lauschen; das ist nötig, damit der Proxy den Dienst unter ollama:11434 erreicht. Nach außen veröffentlicht wird aber nur Port 8443 des Proxys, denn der Dienst ollama hat keinen Eintrag unter ports.
Zwei Änderungen würden den Schutz unterlaufen:
- Ein Eintrag wie
"11434:11434"beim Dienstollama. Docker veröffentlicht solche Ports über eigene iptables-Regeln, die laut Docker-Dokumentation an den Firewall-Regeln von ufw vorbeilaufen. Wird der Port für Tests auf dem Host gebraucht, beschränkt"127.0.0.1:11434:11434"ihn auf den Host selbst. - Weitere Container im Netz
llm_internal. Innerhalb dieses Netzes erreicht jeder Container Ollama direkt und ohne Anmeldung, auch Open WebUI, wenn es dort läuft. Der Weg über den Proxy ist dann eine Einstellung, keine Sperre. Ausschließen lässt sich das mit einem eigenen Netz nur für Ollama und den Proxy; der Proxy hängt zusätzlich in einem zweiten Netz, über das Open WebUI ihn erreicht.
Lässt sich der Proxy mit dem OpenAI-SDK ansprechen?
Nicht mit der gezeigten Konfiguration. Ollama bietet unter /v1/ OpenAI-kompatible Endpunkte an, und das SDK findet sie, wenn seine Basis-URL mit diesem Pfad auf den Proxy zeigt. Den API-Schlüssel sendet das SDK aber im Header Authorization: Bearer …, während auth_basic an derselben Stelle das Schema Basic mit Benutzername und Passwort erwartet. Der Proxy antwortet deshalb mit 401.
Die Konfiguration setzt nur Basic Auth um. Für Bearer-Tokens lässt sich auth_basic durch eine eigene Prüfung ersetzen: eine map im Block http, die $http_authorization mit den gültigen Tokens vergleicht, und ein return 401 im Block server für alle Anfragen ohne Treffer. So kann jedes Programm ein eigenes Token bekommen, das sich einzeln sperren lässt.
Warum steht im curl-Aufruf die Option -k, und darf sie im Betrieb bleiben?
Die Option -k schaltet die Prüfung des Zertifikats ab, damit der Test auch mit einem selbst signierten Zertifikat durchläuft. Im Betrieb gehört sie nicht dazu: Ohne Prüfung schützt TLS nicht vor einer Gegenstelle, die sich als Proxy ausgibt, und die Basic-Auth-Zugangsdaten sind nur Base64-kodiert, also für jeden lesbar, der sie abfängt. Stattdessen wird das Zertifikat oder die interne Zertifizierungsstelle auf den Clients als vertrauenswürdig hinterlegt.
Quellen
Passend dazu