Deutsch
Q4, Q8, FP16 und langer Kontext: Warum ein lokales LLM trotz passender Dateigröße scheitert

Inhalt
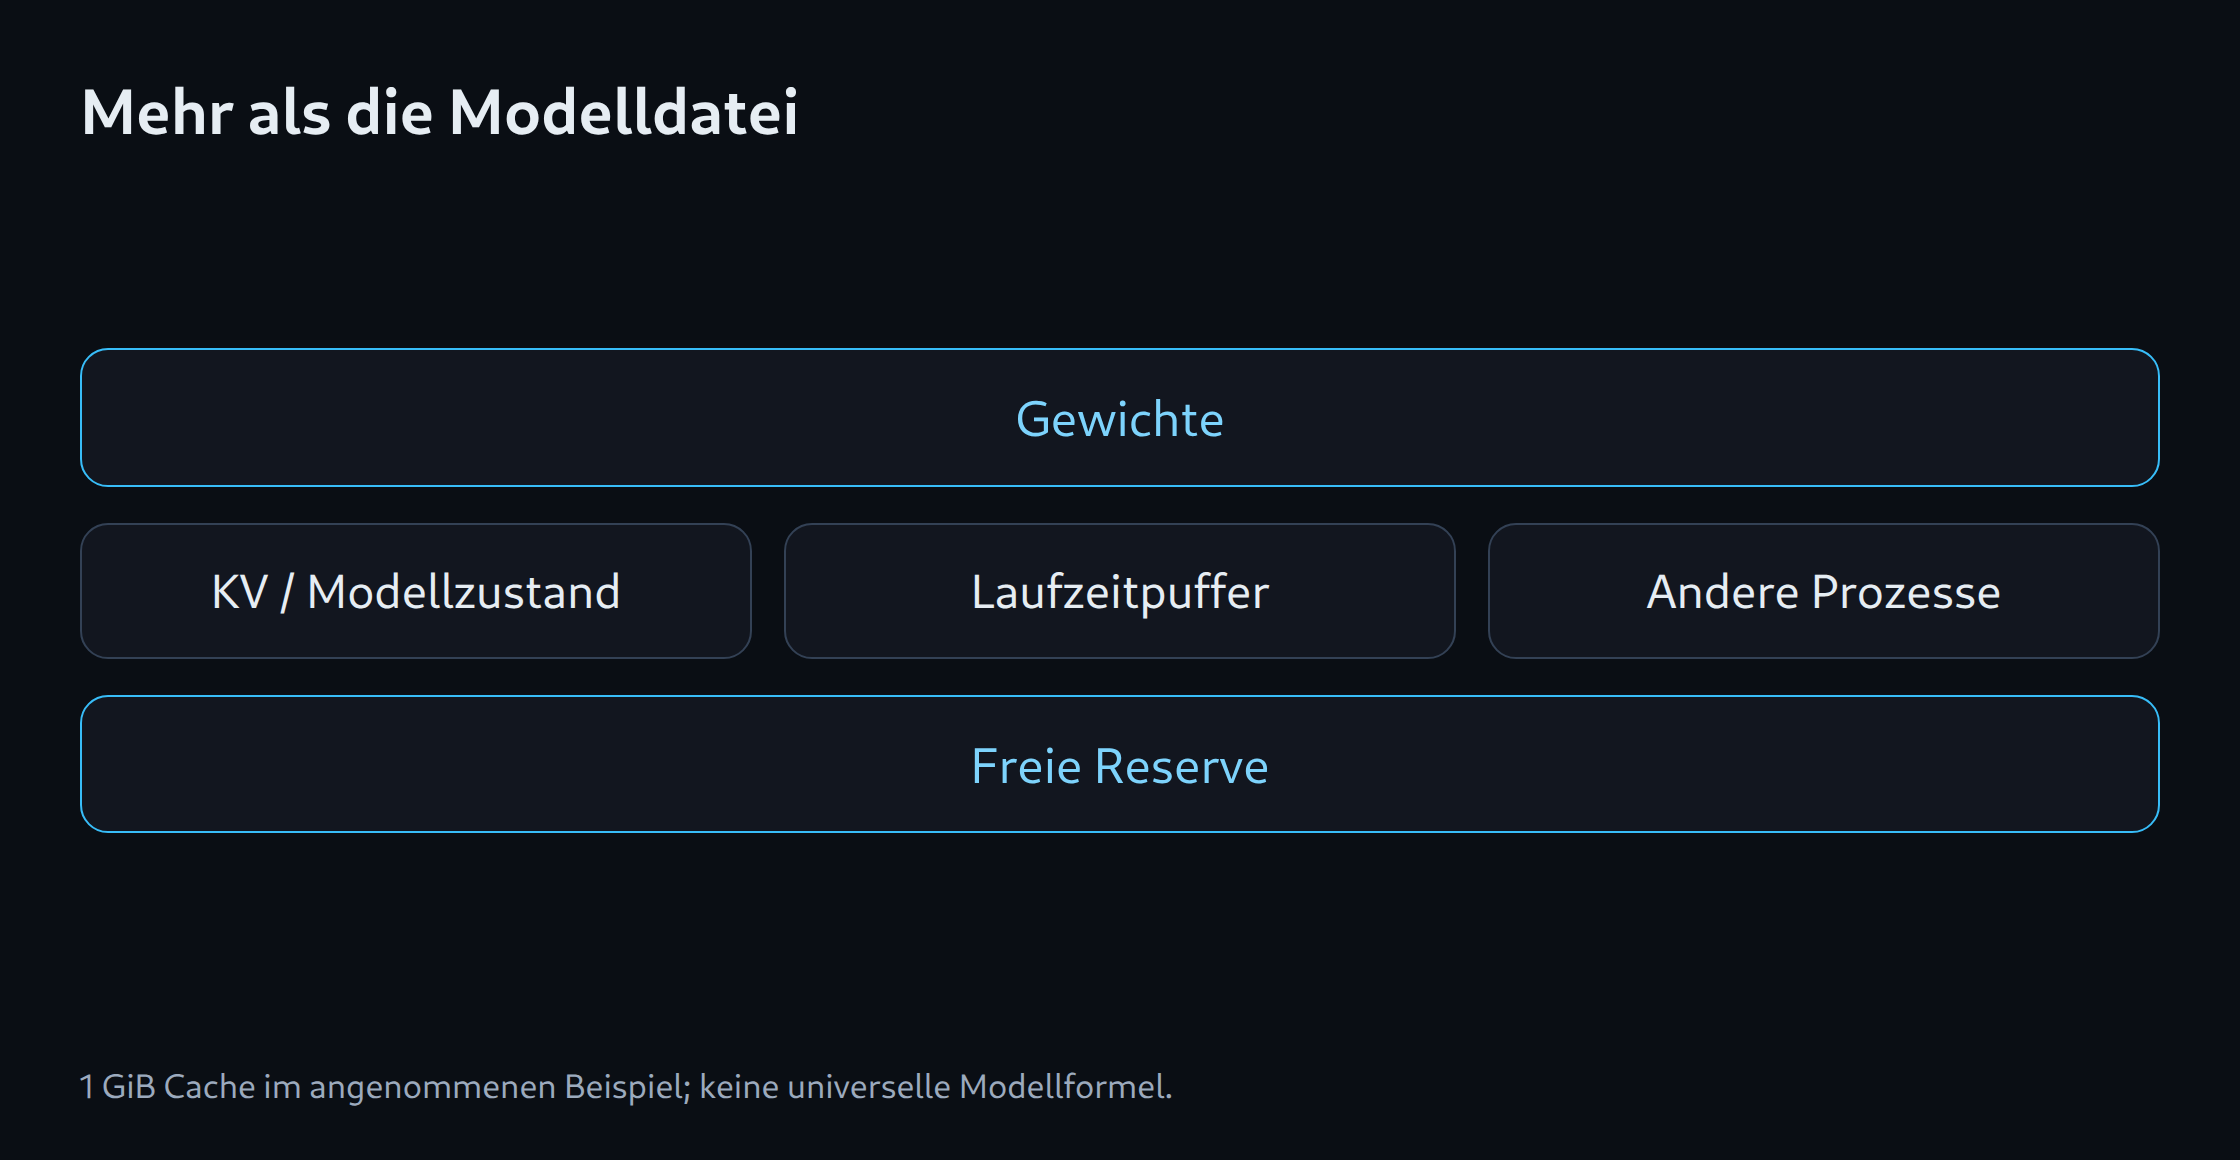
Eine Modelldatei mit 20 GB passt nicht automatisch auf eine Grafikkarte mit 24 GB. Der Download beschreibt gespeicherte Gewichte und Metadaten. Während der Ausführung kommen Kontextzustand, temporäre Puffer und weitere Belegungen hinzu. Die freie Kapazität ist außerdem kleiner als der beworbene Gesamtspeicher, sobald andere Anwendungen die GPU verwenden.
Quantisierung und Kontext gehören deshalb in dieselbe Planung. Der Vergleich erklärt Speichermechanismen und Rechenbeispiele; gemessene Qualitäts- oder Geschwindigkeitsrangfolgen werden daraus nicht abgeleitet.
Q4, Q8 und FP16 beschreiben verschiedene Budgets
| Idealisiertes Beispiel | Rechnung für 30 Milliarden Gewichte | Reiner Gewichtsspeicher |
|---|---|---|
| 4 Bit | 30 Milliarden × 0,5 Byte | 15 GB |
| 8 Bit | 30 Milliarden × 1 Byte | 30 GB |
| 16 Bit | 30 Milliarden × 2 Byte | 60 GB |
Diese Zahlen sind theoretische Dezimalwerte, keine Dateigrößen eines bestimmten Modells. Skalen, Blöcke, gemischte Präzisionen und nicht quantisierte Bestandteile verändern das Ergebnis. GB und GiB sind ebenfalls verschieden: 15 Milliarden Byte entsprechen ungefähr 13,97 GiB. Eine Q4-Datei besteht nicht zwingend aus exakt vier Bit für jeden Gesamtparameter.
Kontext kostet während der Ausführung
Bei klassischer Attention hält der KV-Cache frühere Schlüssel und Werte bereit. Für einen vereinfachten dichten Cache lautet die Rechnung: zwei × Schichten × KV-Köpfe × Kopfbreite × Token × Byte je Wert × Sequenzen. Die Formel gilt nur für die passenden Architektur- und Laufzeitannahmen.
Ein angenommenes Beispiel mit 32 Schichten, acht KV-Köpfen, Kopfbreite 128, 8.192 Token und zwei Byte je Wert benötigt 1 GiB für eine Sequenz. Vier vollständig belegte gleichartige Sequenzen ergeben 4 GiB. Gewichte und Laufzeitpuffer kommen zusätzlich hinzu. Paging, Cache-Quantisierung oder andere Attention-Muster ändern die praktische Belegung.
Hybride Architekturen brauchen eigene Profile
Qwen3.5 verwendet eine hybride Struktur mit unterschiedlichen Schichttypen. Eine Formel für ausschließlich klassische Attention darf daher nicht ungeprüft auf jede Schicht angewandt werden. Recurrent-Zustand, Attention-Cache und multimodale Bestandteile benötigen passende Daten aus Modellkonfiguration und Runtime.
Auch MoE trennt aktiven Rechenaufwand vom gesamten Gewichtsspeicher. Eine kleine Zahl aktiver Parameter ist keine Zusage einer kleinen Modelldatei. Speicherplanung anhand des Namens allein scheitert an solchen Unterschieden.
Auslagerung verändert das Einsatzprofil
llama.cpp unterstützt hybride CPU-/GPU-Ausführung. Ein teilweise ausgelagertes Modell kann dadurch überhaupt starten. Das ist jedoch eine andere Konfiguration als vollständige GPU-Ausführung. Arbeitsspeicher, CPU-Leistung und Datentransfers beeinflussen das Antwortverhalten.
Der Vergleich sollte GPU-Belegung, System-RAM, First-Token-Zeit und Ausgabegeschwindigkeit gemeinsam erfassen. Ein erfolgreicher Start ist nur die erste Prüfung. Lange Dokumente und mehrere gleichzeitige Sitzungen können später eine Grenze erreichen, die ein kurzer Chat verdeckt.
Qualität vor Speicheroptimierung prüfen
Ein größeres Q4-Modell gewinnt nicht automatisch gegen ein kleineres Q8-Modell. Modelltraining, Architektur und Aufgabe bleiben entscheidend. Derselbe Datensatz mit erwarteten Antworten zeigt Fehler, Auslassungen und Formatprobleme; Dateigröße allein erklärt die Nutzbarkeit nicht.
Der vorhandene Speicherrechner liefert eine Vorauswahl. Konkrete Modellrevision und Backend, freie Reserve, Kontext und Parallelität gehören in die Eingaben. Die endgültige Konfiguration folgt einer realen Speicherprüfung und einem kurzen Qualitätstest. Eine unbekannte Architektur erhält eine sichtbare Schätzgrenze statt einer scheinbar exakten Zahl.
Speicherbedarf für die Modellwahl: LLM-VRAM-Rechner.
Passende Werkzeuge
Fragen und Antworten
Warum passt eine 20-GB-Modelldatei nicht immer auf eine 24-GB-GPU?
Zur Datei kommen Laufzeitpuffer, Modellzustand beziehungsweise KV-Cache und weiterer Speicherbedarf hinzu. Die tatsächliche Belegung hängt von Runtime, Architektur, Kontext und Parallelität ab.
Ist ein größeres Q4-Modell immer besser als ein kleineres Q8-Modell?
Die Präzision allein liefert keine Qualitätsrangfolge. Modellfamilie, Training und Aufgabe bleiben entscheidend. Ein Vergleich benötigt gleiche Aufgaben, dokumentierte Konfigurationen und eine Prüfung der Fehler statt nur der Dateigröße.
Quellen
- llama.cpp: Projekt und Backends
- Qwen: Qwen3.5-9B, offizielle Model Card
- Mistral: Ministral 3 14B Instruct, offizielle Model Card
- vLLM: GPU installation
Quellen geprüft: 5. Oktober 2026.
Passend dazu