Deutsch
 Polski
Laptop, Mini-PC, GPU-Tower oder AI-Workstation: Welche Geräte passen zu lokalen LLMs?

Inhalt
Das beste Gerät für ein lokales LLM hängt vom gewünschten Betrieb ab. Ein Notebook für gelegentliche Zusammenfassungen, ein GPU-Tower für Entwicklung und eine kompakte Workstation für große Modelle lösen verschiedene Probleme. Die größte Speicherzahl allein entscheidet den Vergleich nicht.
Die Einordnung folgt dokumentierten Hardware- und Backend-Eigenschaften. Eigene Gerätemessungen liegen nicht vor. Antwortlatenz, Geräusch und Strombedarf müssen deshalb für die konkrete Konfiguration geprüft werden.
Geräteklassen nach Einsatz
| Klasse | Passendes Szenario | Typische Grenze |
|---|---|---|
| CPU-Laptop / Mini-PC | Einstieg und kleine Modelle | Antworttempo und RAM |
| Apple Mac mini / Studio | Kompakter Desktop mit Unified Memory | Konfiguration und spätere Aufrüstung |
| AMD Ryzen AI Max+ System | Speicherstarker kompakter Rechner | Gerätespezifischer Backend-Pfad |
| GPU-Tower | Flexible Entwicklung und Erweiterung | VRAM, Netzteil und Platz |
| NVIDIA DGX Spark | Kompakte CUDA-Workstation | ARM-Softwarepfad und Durchsatzprofil |
RAM, VRAM und Unified Memory
Eine diskrete Grafikkarte besitzt einen eigenen Speicherpool. System-RAM kann große Modelle ergänzen, wird dadurch aber nicht zu gleichwertigem lokalem VRAM. Teilweise CPU-Ausführung bleibt ein anderer Betriebsfall. Die Runtime muss die Aufteilung unterstützen.
Unified Memory wird von CPU, GPU und weiteren Prozessen gemeinsam genutzt. Apple, AMD und DGX Spark verwenden unterschiedliche Plattformen und Softwarepfade. Identische Kapazität bedeutet keine identische Bandbreite, freie GPU-Kapazität oder Geschwindigkeit. Das Budget braucht Reserven für System und Laufzeit.
Kompakte Geräte konkret einordnen
Apple dokumentiert den Mac Studio mit M5 Max oder M5 Ultra; M6 gehört aktuell zum Mac mini. Ein Studio bietet je Konfiguration deutlich mehr Speicherkapazität als kleine Einstiegsgeräte. Große ladbare Modelle und schnelle Ausgabe sind dennoch getrennte Eigenschaften.
AMD beschreibt Ryzen-AI-Max+-395-Systeme mit bis zu 128 GB Unified Memory und konfigurationsabhängig bis zu 96 GB Grafikspeicherzuweisung. Der konkrete Rechner, Firmware und Runtime bleiben entscheidend. NVIDIA dokumentiert DGX Spark mit 128 GB gemeinsamem Speicher. Das ARM-System verlangt außerdem passende Softwarepakete und Container.
Der Tower gewinnt durch Austauschbarkeit
Ein GPU-Tower erlaubt den Austausch von Karte, Speicher, Kühlung und Netzteil innerhalb der Plattformgrenzen. Das ist hilfreich, wenn sich Anforderungen ändern. Die Gesamtrechnung enthält jedoch Gehäuse, Stromversorgung und mögliche Geräuschbelastung, nicht nur den Kartenpreis.
Mehrere GPUs sind eine gezielte Erweiterung statt einer automatischen Speicheraddition. Modellverteilung und Verbindung müssen zur Runtime passen. Für eine einzelne Sitzung kann eine passende Einzelkarte einfacher sein als eine schlecht abgestimmte Mehrkartenlösung.
Ein Szenario entscheidet besser als ein Markenname
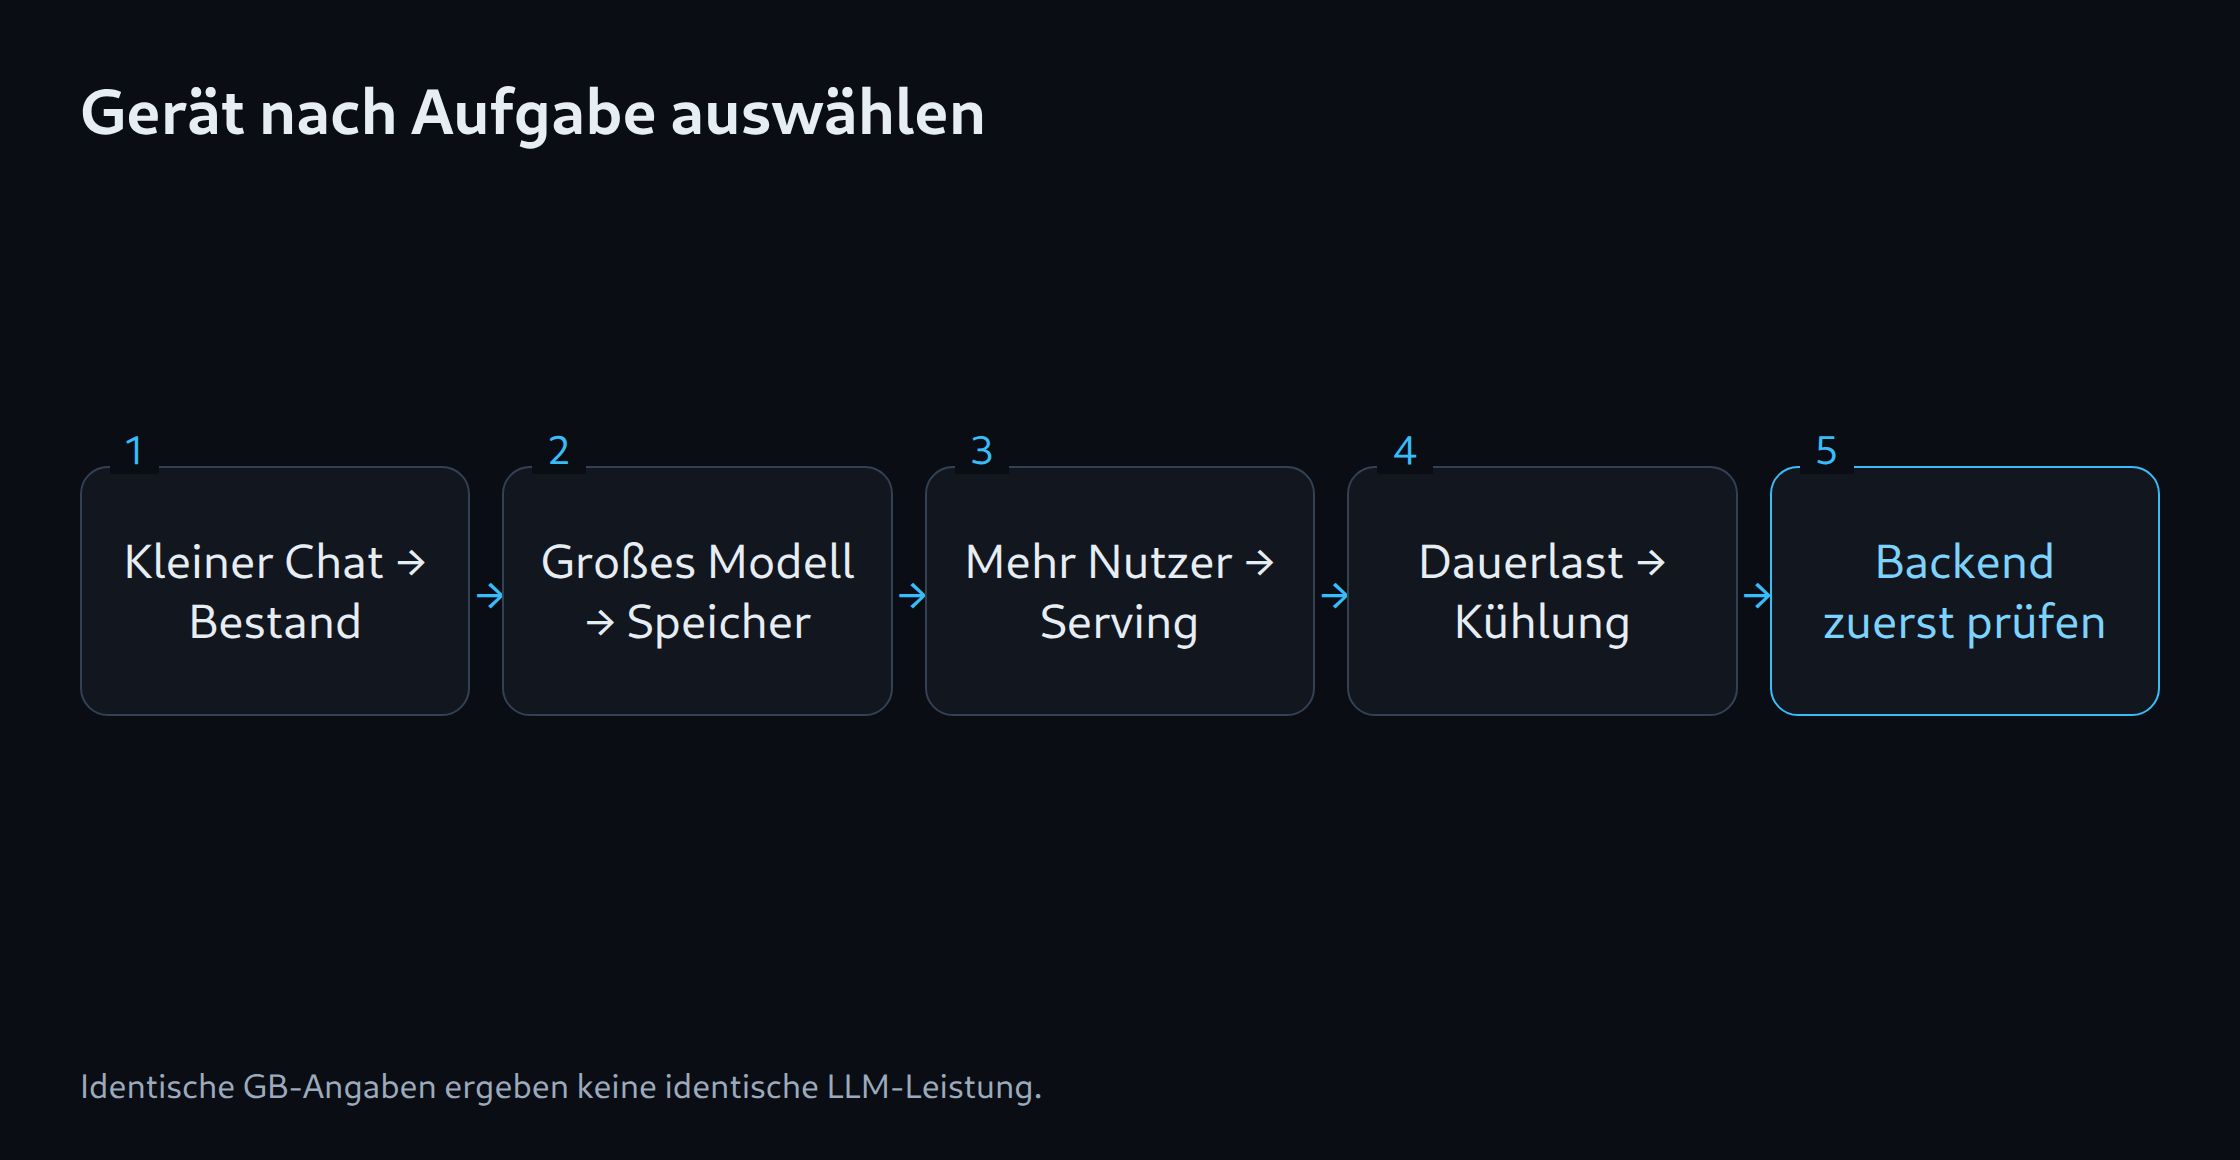
Für gelegentlichen Chat ist ein vorhandenes Gerät mit kleinem Modell der sinnvollste erste Test. Lange Dokumente erhöhen den Zustands- und Cachebedarf. Mehrbenutzerbetrieb verlangt zusätzlich Warteschlangen- und Latenzprüfungen. Bei Coding zählt neben Geschwindigkeit die Fehlerquote der Antworten.
Ein Raspberry Pi eignet sich für kleine Experimente oder als Gateway, sofern Speicher und Antworttempo zur Aufgabe passen. Für größere interaktive Modelle ist keine Desktop-Leistung vorauszusetzen. Der Speicherrechner liefert eine Vorauswahl; ein Test mit der eigenen Aufgabe klärt die tatsächliche Eignung. Ein Hardwarekauf folgt erst einer benannten Grenze des vorhandenen Geräts.
Speicherbedarf für die Modellwahl: LLM-VRAM-Rechner.
Passende Werkzeuge
Fragen und Antworten
Ist ein Raspberry Pi für lokale LLMs geeignet?
Kleine Modelle können auf einem Pi ein Lern- oder Experimentierszenario abdecken. Größere Modelle und interaktiver Dauerbetrieb brauchen eine gesonderte Prüfung von Speicher und Antwortgeschwindigkeit.
Ist ein AI-Mini-PC mit viel RAM automatisch besser als eine Grafikkarte?
Die Speichermenge bestimmt nur einen Teil der Eignung. Speicherbandbreite, unterstützte Backends, Modellarchitektur und Dauerlast beeinflussen die tatsächliche Nutzbarkeit. Ein vergleichbares Aufgabenprofil ist für eine belastbare Entscheidung nötig.
Quellen
- Apple: Mac Studio M5 Max / M5 Ultra – technische Daten
- Apple: Mac mini M6 und Mac Studio M5 verfügbar
- NVIDIA: DGX Spark Hardware Overview
- Ollama: Hardware support
- llama.cpp: Projekt und Backends
- AMD: Ryzen AI Max+ 395 und Unified Memory
Quellen geprüft: 5. Oktober 2026.
Passend dazu