

 English
 Deutsch
 Polski
robots.txt: Regeln richtig zuordnen und zwanzig Domains einordnen

Management Summary
Die robots.txt enthält Zugriffsregeln für kooperierende Such- und KI-Programme auf einer Website. Vorgaben können je Programm und Seitenbereich unterschiedlich sein; eine einzelne Zeile beschreibt deshalb nicht immer die gesamte Regelung. Der Artikel erklärt überlappende Anweisungen und die Grenzen eines Vergleichs von zwanzig Domains. Das hilft bei der Einordnung, welche Inhalte ein bestimmter automatischer Besucher abrufen darf. Die Regeln sichern keine vertraulichen Seiten und beweisen kein tatsächliches Abrufverhalten.
Inhalt
robots.txt gibt kooperierenden Crawlern Anweisungen. Das sind Programme, die Webseiten automatisch abrufen. Für die Auswertung sind drei Fragen zu trennen: das Ergebnis des Dateiabrufs, die passenden Crawler-Gruppen und die spezifischste passende Pfadregel. Die erste passende Zeile gewinnt nicht automatisch; wiederholte passende Gruppen dürfen nicht einfach entfallen.
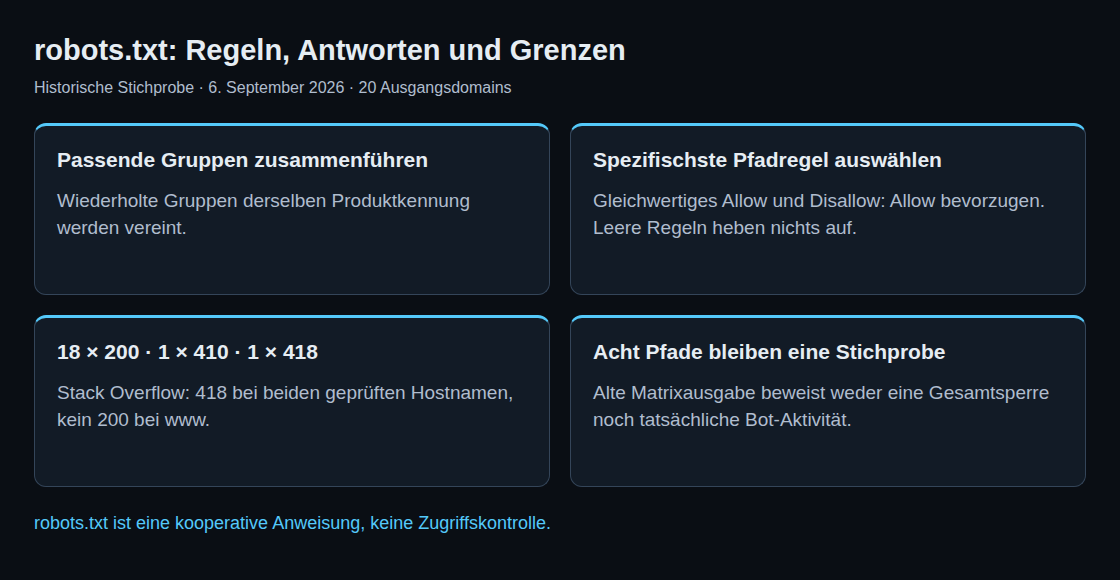
Ein historischer Test vom 6. September 2026 umfasste zwanzig Domains, acht Kennungen und acht Pfade. Die erneute Sichtung von Archiv und Analyzer zeigt wichtige Grenzen: Die gespeicherte Matrix ist eine alte Werkzeugausgabe, kein Nachweis tatsächlichen Crawlerverhaltens oder einer Sperre der gesamten Website.
Die passenden Regeln auswählen
RFC 9309 vergleicht die Produktkennung des Crawlers ohne Beachtung der Groß-/Kleinschreibung und verlangt das Zusammenführen mehrerer passender Gruppen. Google beschreibt zusätzlich die Auswahl der spezifischsten passenden User-Agent-Kennung; wiederholte Gruppen dieser Kennung werden vereint. Eine spezifische Gruppe wird nicht mit der Rückfallgruppe * kombiniert. Ein bloßer Vergleich des längsten Präfixes einer beliebigen HTTP-User-Agent-Zeichenfolge beschreibt den Standard nicht vollständig.
Innerhalb der passenden Regeln gewinnt die spezifischste passende Pfadregel. Der Vergleich beginnt am Pfadanfang und vergleicht Bytes, auch Oktette genannt, statt nur sichtbare Zeichen zu zählen. Prozentkodierte Schreibweisen wie %62 für den Buchstaben b müssen vor dem Vergleich nach den Protokollregeln vereinheitlicht werden. Bei gleichwertigem Allow und Disallow wird Allow bevorzugt. Pfade werden normalerweise unter Beachtung der Groß-/Kleinschreibung verglichen. * steht für null oder mehr Zeichen, $ für das Ende.
Ein leeres Disallow: wird ignoriert. Eine andere Sperre innerhalb der passenden Regeln bleibt bestehen. Das folgende isolierte Beispiel erlaubt /private/help.html, sperrt aber andere mit /private/ beginnende Pfade, darunter /private/report.html:
User-agent: ExampleBot
Disallow: /private/
Disallow:

User-agent: ExampleBot
Allow: /private/help.html$
Die zweite ExampleBot-Gruppe ergänzt die Ausnahme. Ein Parser, der nur die erste Gruppe übernimmt, liefert das falsche Ergebnis. Leerzeilen oder Kommentare zwischen aufeinanderfolgenden User-Agent-Angaben dürfen die nachfolgenden Regeln nicht versehentlich abtrennen.
Was der historische Lauf tatsächlich zeigt
Das Archiv enthält achtzehn Antworten mit HTTP 200, eine 410 von heise.de und eine 418 von stackoverflow.com. Bei sechzehn Ausgangsadressen gab es Weiterleitungen. Der zusätzliche Abruf von www.heise.de ergab 200; der Abruf von www.stackoverflow.com ergab ebenfalls 418. Für Stack Overflow wurden 113 Byte aufgezeichnet, kein leerer Inhalt. Daraus folgt weder die Absicht des Betreibers noch ein nachgewiesener Fehler der Weiterleitungskonfiguration.
Die alte Matrix kennzeichnete alle acht Prüfpfade für GPTBot und CCBot auf sechs Domains als gesperrt, für ClaudeBot auf fünf und für Google-Extended, PerplexityBot sowie Applebot-Extended auf jeweils vier. Diese Zahlen beschreiben die gespeicherte Werkzeugausgabe. Acht Pfade belegen keine Sperre jeder URL einer Website. Die unten genannten Parserfehler verhindern außerdem eine unabhängige Bestätigung der damaligen Anbieterregeln aus dieser Klassifikation.
Vierzehn Domains hatten bei keiner der sechs Kennungen ein solches Acht-von-acht-Ergebnis. Zwölf hatten bei keiner Kennung einen gesperrten Prüfpfad. Das sind verschiedene Zahlen: google.com und microsoft.com enthielten in der alten Ausgabe Teilsperren. Das ursprüngliche Diagramm vermischte diese Kategorien.
Die Zusammenfassung meldet bis zu 105 Gruppen bei den Hauptprüfungen und 28.275 Byte für die größte Datei. Gruppenzahlen hängen vom Parser ab. Die ausgegebene Sitemap-Liste war auf zwanzig Einträge begrenzt; ein gespeicherter Wert von zwanzig beweist deshalb nicht genau zwanzig Deklarationen. Auch eine Byte-Order-Mark verrät nicht den verwendeten Editor.
Zuerst den Abrufstatus einordnen
Nach erfolgreichem Abruf gelten die auswertbaren Regeln. RFC 9309 erlaubt Crawling bei einer nicht verfügbaren robots.txt, beispielsweise nach einer 4xx-Antwort. Das ist eine Protokollerlaubnis, kein Beweis für eine physisch nicht vorhandene Datei. Netz- und Serverfehler verlangen dagegen die Annahme einer vollständigen Sperre; zusätzlich gelten Regeln für Caching und längere Ausfälle. Dreißig Tage sind im Standard ein Beispiel für einen längeren Zeitraum, kein universeller Timer.
Google beschreibt einen eigenen Ablauf: Serverfehler stoppen das Crawling zunächst zwölf Stunden; danach hängt das Verhalten von der letzten gültigen Cache-Fassung und der allgemeinen Erreichbarkeit der Website ab. Google behandelt 429 anders als sonstige 4xx-Antworten. Ein einzelner Statuscode bestimmt das Verhalten deshalb nicht unabhängig von Zeit, Cache und Implementierung.
Host, Schema und Port bestimmen den Geltungsbereich. Eine Weiterleitung der robots.txt kann zu einem anderen Host führen; die dort gelesenen Regeln gelten trotzdem für die ursprüngliche Adresse. Eine Firewall sollte legitimen Crawlern die vorgesehene robots.txt-Antwort zugänglich machen. Authentifizierung oder andere Zugriffskontrollen ersetzt diese Datei nicht.
Sechs Kennungen sind keine sechs Trainingscrawler
GPTBot und ClaudeBot betreffen die Sammlung ihrer Anbieter für die Modellentwicklung. CCBot erstellt das offene Webarchiv von Common Crawl. PerplexityBot dient laut Anbieter der Auffindbarkeit in der Suche, nicht dem Training von Basismodellen. Separate Suchbots oder nutzergesteuerte Abrufe können anderen Regeln folgen.
Google-Extended hat keinen eigenen HTTP-User-Agent. Die Steuerkennung betrifft bestimmte Gemini-Trainings- und Grounding-Nutzungen, ohne Aufnahme oder Rangfolge in Google Search zu verändern. Applebot-Extended crawlt ebenfalls nicht selbst, sondern steuert die Nutzung von Applebot-Daten für das Training von Basismodellen. Keine der beiden Kennungen kontrolliert pauschal jede KI-Funktion oder jede Anfrage.
Grenzen der verlinkten Matrix
Die robots.txt-Crawlermatrix zeigt bis zu acht Kennungen gegen zwölf Pfade und nennt eine gewinnende Zeile. Die geprüfte Implementierung berücksichtigt jedoch nur eine passende Gruppe, behandelt manche Gruppengrenzen mit Leerzeilen falsch, normalisiert Prozentkodierungen nicht ausreichend und kann nach Netzfehlern erlaubte Matrixzellen anzeigen. Die pauschale 4xx-Behandlung bildet auch Googles Umgang mit 429 nicht ab. Das sind konkrete Einschränkungen, keine vom RFC offengelassenen Unterschiede.
Die historischen Zusammenfassungen enthalten die vollständigen Regeldateien nicht. Eine korrigierte damalige Auswertung lässt sich allein daraus nicht rekonstruieren. Für aktuelle Prüfungen werden tatsächliche Datei, Status, Weiterleitungskette, passende Produktkennungen und repräsentative Pfade benötigt, abgeglichen mit der Dokumentation des jeweiligen Crawlers.
Fragen und Antworten
Entfernt Disallow eine Adresse aus der Suche?
Nicht zuverlässig. Crawling und Indexierung sind getrennte Vorgänge. Google muss eine Seite abrufen können, um ein noindex-Meta-Element oder X-Robots-Tag zu lesen. Private Inhalte benötigen Zugriffskontrollen statt einer bloßen Crawling-Anweisung.
Bedeutet eine HTML-Fehlerseite mit 200, dass keine Regeln gelten?
Nicht zwingend. Google versucht, gültige Regeln zu extrahieren, und ignoriert andere Zeilen. Status, Inhaltstyp und Inhalt benötigen daher eine Prüfung. Eine HTML-Hülle ersetzt keine gültige UTF-8-Textdatei.
Ist Crawl-delay universell wirksam?
Nein. Das Feld liegt außerhalb des Kernprotokolls; die Unterstützung unterscheidet sich. Google unterstützt das Feld nicht, Anthropic dokumentiert Unterstützung. Grenzen und Steuerungsmöglichkeiten sind für den jeweiligen Anbieter zu prüfen.
Gelten Änderungen sofort?
Nicht zwingend. Gespeicherte robots.txt-Fassungen und die Verarbeitung beim Anbieter verursachen Verzögerungen. Der RFC rät grundsätzlich von einer Cache-Nutzung über vierundzwanzig Stunden hinaus ab, sofern die Datei nicht unerreichbar ist. Ein Parsertest beweist keinen bereits erfolgten Abruf der neuen Fassung durch einen Crawler.
Passend dazu


