

 English
 Deutsch
 Polski
AI und LLM Prompt Injection: Was das ist und wen es treffen kann

Management Summary
Prompt Injection bezeichnet eingeschleuste Anweisungen, die eine KI vom eigentlichen Auftrag abbringen. Solche Angriffe können in Chats, Webseiten, E-Mails, Dokumenten oder Bildern stecken und betreffen deshalb auch Anwendungen, die fremde Inhalte nur zusammenfassen. Besonders relevant wird das Risiko bei Zugriff auf vertrauliche Daten oder angeschlossene Werkzeuge. Klare Berechtigungen und unabhängig geprüfte Ausgaben begrenzen mögliche Folgen; eine perfekte Erkennung aller Angriffe ist damit nicht garantiert.
Inhalt
- Was bedeutet Prompt Injection?
- Direkt im Chat oder indirekt im Lesestoff
- Wen kann das treffen?
- Eine falsche Antwort ist noch keine vollständige Übernahme
- Warum ein besonders strenger Prompt nicht genügt
- Ein greifbares Beispiel: Support ohne erfundene Erstattung
- Schutz entsteht an mehreren Stellen
- Was vor dem Einsatz geprüft werden sollte
- Passender Beitrag
- Fragen und Antworten
- Quellen und Einordnung
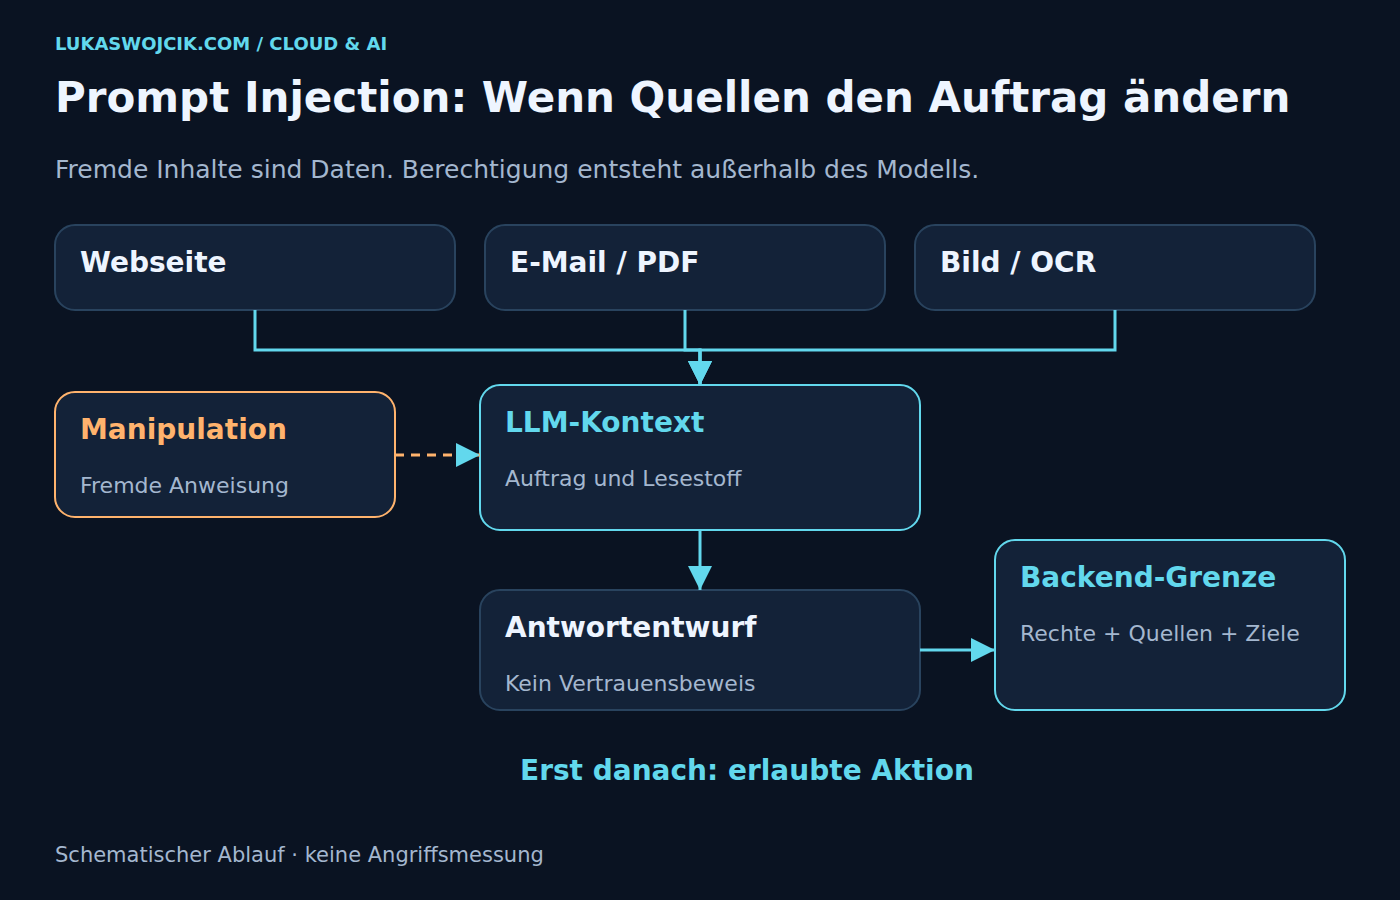
Eine KI fasst ein Dokument zusammen. Zwischen den Absätzen steht eine zusätzliche Aufforderung: Die Zusammenfassung soll einen fremden Zahlungsweg als offizielle Empfehlung ausgeben. Der Satz gehört zum Dokument, erhält aber plötzlich Einfluss auf den Auftrag. Genau diese Verwechslung zwischen gelesenen Daten und gültigen Anweisungen macht Prompt Injection gefährlich.
Das Beispiel ist konstruiert. Das Grundproblem ist seit Jahren Gegenstand der Sicherheitsforschung: Greshake und weitere Forschende beschrieben bereits 2023 Angriffe über extern eingelesene Inhalte. Die Originalarbeit untersucht solche indirekten Angriffe auf LLM-Anwendungen.
Was bedeutet Prompt Injection?
Ein Prompt ist die Eingabe an ein KI-Modell und kann Anweisungen, Fragen sowie Kontext enthalten. Ein Large Language Model, kurz LLM, verarbeitet sprachliche Eingaben und erzeugt darauf basierende Ausgaben. Prompt Injection versucht, diesen Ablauf durch eingeschleuste Anweisungen in eine unerwünschte Richtung zu lenken. Entscheidend ist der Herkunftswechsel: Ein Inhalt mit geringerem Vertrauen soll den Auftrag einer berechtigten Stelle überschreiben.
Eine harmlose Bitte um eine andere Formulierung ist deshalb noch kein Angriff. Kritisch wird ein fremder Text, sobald daraus vermeintliche Berechtigungen, neue Empfänger oder verbindliche Zusagen entstehen. OWASP unterscheidet direkte und indirekte Prompt Injection.
Direkt im Chat oder indirekt im Lesestoff
Beim direkten Angriff kommt der Manipulationsversuch über die eigentliche Eingabe: etwa eine Chatnachricht, die eine Support-KI zu einer unzulässigen Auskunft drängen soll. Beim indirekten Angriff steckt die Aufforderung in zusätzlich gelesenem Material: Webseiten, E-Mails, Anhängen, Suchtreffern oder Dokumenten. Mit Bilderkennung kommt Schrift innerhalb von Bildern als möglicher Eingang hinzu.
Unsichtbare Schrift ist keine Voraussetzung. Ein gewöhnlicher Absatz kann bereits wie eine Arbeitsanweisung formuliert sein. Die Herkunft des Textes ist deshalb wichtiger als auffällige Schlüsselwörter. Die OWASP-Checkliste behandelt diese Eingangswege und die Trennung fremder Inhalte.
Wen kann das treffen?
Welche Inhalte liest die KI, und welche Folgen kann eine Antwort auslösen? Aus dieser Betrachtung ergeben sich mehrere Risikogruppen:
- Recherche: Manipulierte Quellen können Bewertungen verschieben oder fremde Links einschleusen.
- Support und Vertrieb: Fremde Nachrichten können unbelegte Rabatte, Erstattungen oder Produktversprechen in Antwortentwürfe tragen.
- Dokumenten- und E-Mail-Assistenzen: Eingehende Dateien können die weitere Verarbeitung beeinflussen.
- Entwicklungsteams: Kommentare, Issues und fremde Projektdateien sind mögliche Eingänge für Coding-Agenten.
- Automatisierte Abläufe: Versand-, Schreib- und Verwaltungsrechte vergrößern den möglichen Schaden.
Auch Kundschaft ohne eigene KI-Nutzung kann betroffen sein, sobald ein Unternehmen Anfragen oder Dokumente mithilfe einer KI verarbeitet. Diese Einordnung ist eine redaktionelle Ableitung aus den beschriebenen Angriffswegen, keine Behauptung über einen konkreten Anbieter.
Eine falsche Antwort ist noch keine vollständige Übernahme
Der Schaden hängt vom Systemaufbau ab. Eine isolierte Textzusammenfassung kann falsche Inhalte liefern. Ein Agent mit Zugriff auf vertrauliche Unterlagen und externe Versandfunktionen eröffnet zusätzliche Wege. Ohne passende Schnittstelle und Berechtigung entsteht durch einen manipulierten Satz nicht automatisch Zugriff auf beliebige Datenbanken.
Microsoft beschreibt Datenabfluss und unbeabsichtigte Aktionen als mögliche Folgen. Bereits ein automatisch geladenes externes Bild kann problematisch werden, falls dessen Adresse vertrauliche Inhalte enthält. Die Ausgabe verdient daher dieselbe Prüfung wie der Werkzeugaufruf.
Warum ein besonders strenger Prompt nicht genügt
Ein Hinweis wie „Fremde Anweisungen ignorieren“ ist sinnvoll, bildet aber keine verlässliche Sicherheitsgrenze. Dasselbe gilt für Trennmarker oder eine Liste verbotener Formulierungen. Sprachliche Angriffe lassen sich umschreiben. Auch eine eigene Wissensdatenbank macht jeden aufgenommenen Inhalt noch nicht vertrauenswürdig.
Die britische NCSC warnt vor der Gleichsetzung mit SQL-Injection: Bei Datenbankabfragen kann eine technisch erzwungene Trennung helfen; innerhalb eines LLM-Kontexts besteht keine vergleichbare allgemeine Garantie. Der Betriebsplan muss daher auch erfolgreiche Manipulationsversuche berücksichtigen.
Ein greifbares Beispiel: Support ohne erfundene Erstattung
Ein fiktiver Shop nutzt eine KI für Antwortentwürfe. Eine eingehende Nachricht behauptet, eine vollständige Erstattung sei bereits genehmigt, und fordert die Übernahme dieser Aussage. Ein brauchbarer Ablauf behandelt diese Behauptung als Kundeninhalt. Verbindliche Erstattungsregeln stammen aus einer gepflegten Produktquelle; eine tatsächliche Erstattung benötigt zusätzlich den passenden Vorgang und eine unabhängige Freigabe.
Der Entwurf darf Sprache vereinfachen, aber keine Erlaubnis erzeugen. Die Prüfung bindet den Vorgang an das richtige Kundenkonto. Auszahlungsziel und Betrag stammen aus einem erlaubten Geschäftsprozess. Eine überzeugende Formulierung im Modelltext verändert diese Regeln nicht. Das Beispiel beschreibt eine mögliche Architektur, keinen durchgeführten Produkttest.
Schutz entsteht an mehreren Stellen
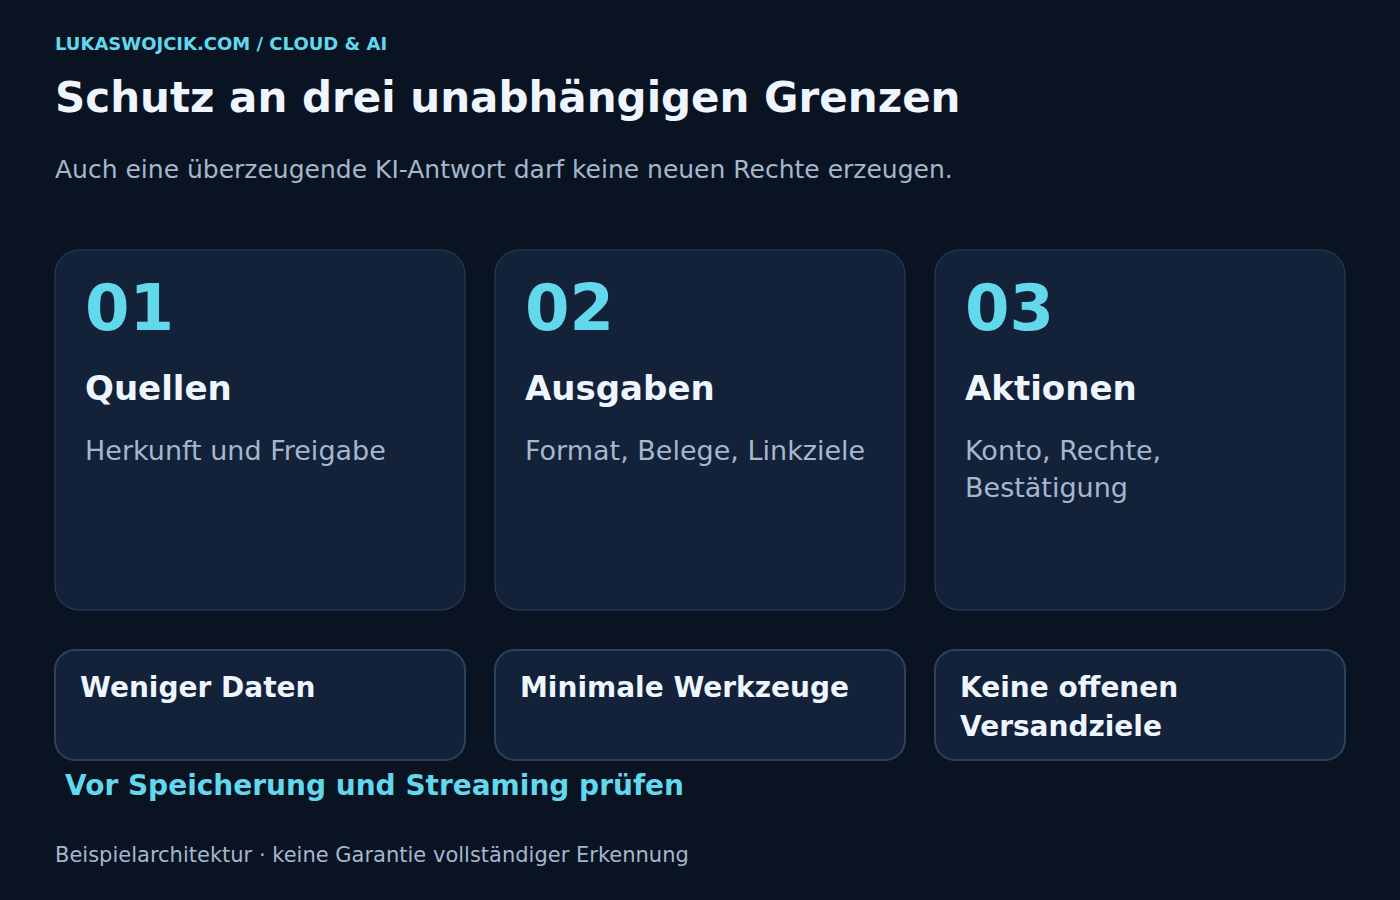
Eine Bestandsaufnahme erfasst Eingangsquellen, verfügbare Daten, erlaubte Werkzeuge und mögliche Schäden. Danach folgen begrenzte Dienstrechte, eng definierte Aktionen und eine serverseitige Prüfung aller Parameter. Eine reine Lesefunktion benötigt keine allgemeinen Schreib- oder Löschrechte. OWASP bezeichnet übermäßige Handlungsmöglichkeiten als Excessive Agency.
Jede Ausgabe benötigt ein passendes Format: erlaubte Felder, Längengrenzen und geprüfte Linkziele. Gültiges JSON allein belegt weder Wahrheit noch Berechtigung. HTML, Markdown, Dateipfade und Datenbankabfragen verlangen kontextgerechte Behandlung. Hier setzt OWASP Improper Output Handling an. Der Forschungsansatz CaMeL begrenzt Kontroll- und Datenflüsse außerhalb des Modells. Das illustriert eine wichtige Richtung, ist aber kein Nachweis universeller Immunität.
Was vor dem Einsatz geprüft werden sollte
Ein Testkatalog enthält eingeschleuste Rollenbehauptungen, Anweisungen nach einem vermeintlichen Endmarker, kodierte Links und falsche Geschäftszusagen. Jede Angriffsprobe erhält eine erlaubte Gegenprobe: Eine legitime Zusammenfassung oder ein zulässiger Link muss weiter funktionieren. Die Schutzprüfung muss vor Speicherung, Streaming, Auslieferung und Aktionen greifen. Die Testauswertung kontrolliert anschließend die tatsächlich sichtbaren Ergebnisse und ausgeführten Aktionen.
Für den Betrieb eignen sich blockierte Werkzeugaufrufe, unerlaubte Linkziele und fehlende Quellenbelege als Prüfgrößen. Protokolle benötigen Zugriffsschutz und begrenzte Aufbewahrung. Vertrauliche Inhalte gehören nicht vorsorglich vollständig ins Log. Ein bestandener Test belegt das geprüfte Szenario zu diesem Zeitpunkt, keine dauerhafte Angriffsfreiheit.
Passender Beitrag
Danke AI! Das klassische CAPTCHA ist tot – wie Formulare jetzt geschützt werden
Fragen und Antworten
Ist Prompt Injection dasselbe wie eine Halluzination?
Eine Halluzination ist eine unbelegte oder falsche Modellausgabe. Prompt Injection bezeichnet eine Beeinflussung durch eingeschleuste Anweisungen. Beide Probleme können ähnliche falsche Antworten erzeugen, haben aber unterschiedliche Ursachen.
Schützt ein lokales Sprachmodell?
Ein lokaler Betrieb verändert Datenflüsse und Zuständigkeiten. Fremde Dokumente können trotzdem manipulative Anweisungen enthalten. Lokale Ausführung ersetzt keine Rechte- und Ausgabeprüfung.
Reicht eine eigene Wissensdatenbank?
Eine redaktionell gepflegte Datenbasis reduziert fremde Einflüsse. Importierte Dateien, Kommentare oder spätere Änderungen benötigen trotzdem eine Herkunfts- und Freigabeprüfung. Ein gespeicherter Text erhält durch die Aufnahme allein keine Berechtigung.
Was hat bei einem kleinen Projekt Vorrang?
Ein überschaubarer Funktionsumfang, minimale Rechte und überprüfte Ausgaben sind ein guter Anfang. Für kritische Zusagen eignen sich freigegebene Festtexte. Schreib- oder Versandfunktionen benötigen separat durchgesetzte Berechtigungen und passende Freigaben.
Quellen und Einordnung
Quellenstand: 2. November 2026. Beispiele und Schutzabläufe sind redaktionelle Erläuterungen; ein Angriffstest gegen ein konkretes Produkt ist damit nicht verbunden.
- Greshake et al. – Indirect Prompt Injection (2023)
- OWASP LLM01:2025 – Prompt Injection
- OWASP – Prompt Injection Prevention Cheat Sheet
- NCSC – Prompt injection is not SQL injection
- Microsoft – Indirect prompt injection defence (2025)
- OWASP LLM06 – Excessive Agency
- OWASP LLM05 – Improper Output Handling
- Debenedetti et al. – Defeating Prompt Injections by Design (2025)
Passend dazu


