English
 Deutsch
 Polski
Vom Download zur ersten Antwort: Wie aufwendig ist ein lokales LLM wirklich?

Management Summary
Ein lokales Sprachmodell erzeugt KI-Antworten auf dem eigenen Rechner statt in einem externen Dienst. Der Artikel erklärt den Weg vom Herunterladen bis zum ersten nutzbaren Chat. Für einen einzelnen Arbeitsplatz kann eine passende Desktop-Anwendung den Einstieg erleichtern. Gerät, Speicher und Software müssen trotzdem zusammenpassen. Die Übersicht macht den tatsächlichen Aufwand sichtbar: Einrichtung und Fehlersuche gehören ebenso dazu wie spätere Pflege. Ein gemeinsamer Zugang für mehrere Personen erhöht die Anforderungen.
Inhalt
Ein lokales LLM ist ein Sprachmodell, das auf dem eigenen Rechner Antworten erzeugt. Für einen ersten Chat reicht häufig eine Desktop-Anwendung mit passender Modelldatei. Ein Dienst für mehrere gleichzeitige Anfragen braucht zusätzliche Einrichtung. Die wichtigsten Hürden sind passende Treiber, ausreichend Speicher und die Erkennung der Grafikkarte.
Dieser Vergleich erklärt die einzelnen Schritte, nennt aber keine gemessene Installationsdauer. Die benötigte Zeit hängt von Rechner, Software und Modell ab. Ein langer Download bedeutet nicht automatisch eine schwierige Einrichtung; beide Zeiten werden getrennt erfasst.
Der passende Einstieg je Betriebssystem
| System | Überschaubarer Einstieg | Zusätzlicher Aufwand |
|---|---|---|
| Windows | LM Studio oder Ollama | Passender Grafiktreiber; vLLM nicht nativ unter Windows |
| macOS / Apple Silicon | LM Studio oder Ollama | Passende Modelldatei und freie Speichermenge |
| Linux | Ollama oder vorgefertigtes llama.cpp-Programm | Passendes Paket, GPU-Zugriff und Dienststart |
| Mehrere Anfragen unter Linux | vLLM mit unterstützter GPU | Unterstütztes Modell, Zahlenformat und Rechenfunktionen |
Fünf Angaben vor dem Download
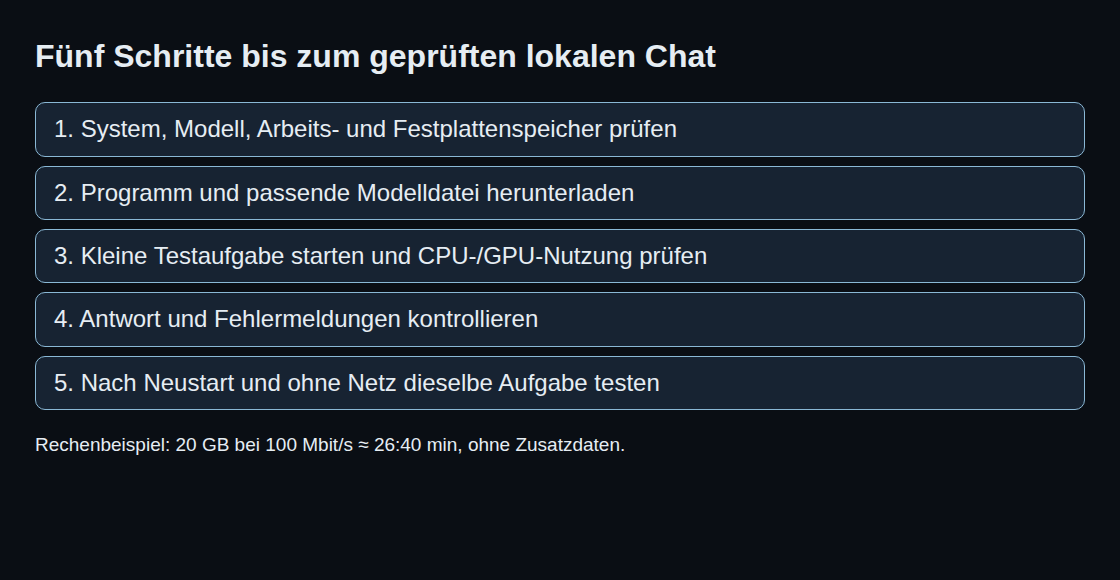
Vor dem Download stehen fünf Angaben fest: Betriebssystem, Grafikchip (GPU), freier Arbeitsspeicher beziehungsweise Grafikspeicher, freier Festplattenplatz und gewünschtes Modell. Die Dokumentation muss die konkrete Kombination unterstützen. Das Backend ist der Teil der Software, der Berechnungen auf CPU oder GPU ausführt. Mehrere Modellversionen benötigen zusammen mehr Festplattenplatz als eine einzelne Datei.
Für den ersten Test eignet sich ein kleines unterstütztes Modell mit einer kurzen, überprüfbaren Aufgabe, etwa zwei Stichpunkte aus einem vorgegebenen Absatz. Erst nach diesem Test folgen längere Eingaben oder gleichzeitige Anfragen. So lassen sich Installationsfehler und Speichergrenzen getrennt untersuchen. Der Kontext bezeichnet den Textumfang, den das Modell während einer Anfrage berücksichtigen kann.
Downloadzeit ist kein Installationsbenchmark
Ein Rechenbeispiel: Eine Modelldatei mit 20 GB enthält 160 Gigabit, weil ein Byte aus acht Bit besteht. Bei konstanten 100 Mbit/s dauert die Übertragung theoretisch 1.600 Sekunden, also 26 Minuten und 40 Sekunden. Bei 1 Gbit/s sind es 160 Sekunden. Gemeint sind Dezimal-GB; zusätzliche Übertragungsdaten, Schwankungen und Serverlimits sind nicht eingerechnet.
Für einen brauchbaren Zeitvergleich werden vier Zeiten getrennt notiert: Download, Installation, erster Modellstart und Fehlersuche. Ein schneller Download kann mit aufwendiger Fehlersuche zusammentreffen. Umgekehrt kann eine einfach bedienbare Anwendung lange auf eine große Datei warten.
GPU-Ausführung nachweisen
Eine Antwort beweist keine GPU-Nutzung. Bei Ollama zeigt ollama list gespeicherte Modelle; ollama ps zeigt gerade geladene Modelle. Die Spalte PROCESSOR unterscheidet CPU, GPU und gemischte Speicherbelegung. Protokolle und GPU-Auslastung während einer Anfrage ergänzen diese Information. Eine leere Prozessliste nach dem Entladen ist kein Nachweis eines Treiberfehlers.
ollama list
ollama ps
Schlechte oder langsame Antworten können verschiedene Ursachen haben. CPU-Betrieb kann langsamer sein. Eine falsche Chat-Vorlage kann Rollen oder Nachrichten falsch an das Modell übergeben. Eine nicht unterstützte Quantisierung, also eine platzsparende Zahlenformatierung, kann das Laden verhindern. Speicherfehler bei längeren Eingaben sprechen dagegen für eine Prüfung von Kontextlänge und Speicherreserve. Die konkrete Fehlermeldung bestimmt den nächsten Schritt.
Erstinstallation von Dauerbetrieb unterscheiden
Nach dem ersten Erfolg folgen Modellwechsel, Rechnerneustart und dieselbe Testaufgabe ohne Netzverbindung. Dafür müssen Modelldateien und benötigte Rechenmodule bereits installiert sein. Externe Werkzeuge und Cloud-Modelle bleiben ausgeschaltet. Dieser Test bestätigt die geprüfte Konfiguration; spätere Updates oder andere Funktionen können erneut eine Verbindung benötigen.
Eine API erlaubt anderen Programmen, Antworten beim Modell anzufordern. Für den Einstieg sollte der Dienst nur über die Loopback-Adresse 127.0.0.1 auf demselben Rechner erreichbar sein. Die Freigabe im Netz erfordert zusätzlich Zugangsschutz, Begrenzung gleichzeitiger Anfragen und Wartung. Für einen einzelnen Desktop-Chat ist ein solcher Dienst nicht nötig. Der Speicherrechner hilft bei der Modell- und Hardwarewahl; ein Protokoll der Einrichtung zeigt den tatsächlichen Aufwand.
Speicherbedarf für die Modellwahl: LLM-VRAM-Rechner.
Passende Werkzeuge
Fragen und Antworten
Bedeutet ein erfolgreicher Modellstart, dass die GPU arbeitet?
Ein Modell kann auch auf dem Hauptprozessor (CPU) oder verteilt auf CPU und GPU laufen. Die Speicherzuordnung in ollama ps und die Auslastung während einer Anfrage helfen bei der Prüfung.
Funktioniert ein lokales LLM ohne Internet?
Mit vollständig heruntergeladenen Dateien und geeigneter Software können Antworten ohne Internet entstehen. Externe Werkzeuge und Cloud-Modelle können dagegen eine Verbindung benötigen. Ein Test ohne Netz zeigt, ob die konkrete lokale Aufgabe funktioniert.
Quellen
- Ollama: unterstützte Hardware
- vLLM: Installation mit GPU-Unterstützung
- llama.cpp: Projekt und Backends
- LM Studio: Dokumentation
- Ollama: FAQ
- Ollama: Befehlsübersicht
- LM Studio: Offline-Betrieb
- LM Studio: Systemvoraussetzungen
Quellen geprüft: 26. Oktober 2026.
Passend dazu