English
 Deutsch
 Polski
Cookielose Analyse: Warum synthetische IDs keine Sitzungen rekonstruieren

Management Summary
Berechnete Kennungen aus Netzwerk- und Browsermerkmalen stellen Besuche ohne Cookies nicht zuverlässig wieder her. Unterschiedliche Personen können zusammenfallen; ein Netzwechsel kann einen Besuch aufteilen. Eine täglich neue Kennung löscht zudem keine früheren Aufzeichnungen. Ausgangspunkt sollte die benötigte Kennzahl sein: Tagesgesamtzahlen brauchen möglicherweise weniger Wiedererkennung als einzelne Besuchswege. Berichte müssen Messungen, Schätzungen und künstliche Gruppen unterscheiden und das Verfahren zulässig gestalten.
Inhalt
- Was eine synthetische Kennung tatsächlich verbindet
- Cookie-Ablehnung bedeutet nicht immer eine gemessene Einzelsitzung
- Kein Cookie ist kein Anonymitätsnachweis
- Ein Tageswechsel löscht keine gespeicherten Daten
- Warum ein universeller Codebaustein nicht genügt
- Zielsysteme nicht blind mit Ersatzkennungen versorgen
- Eine belastbare Messentscheidung treffen
- Fragen und Antworten
- Quellen
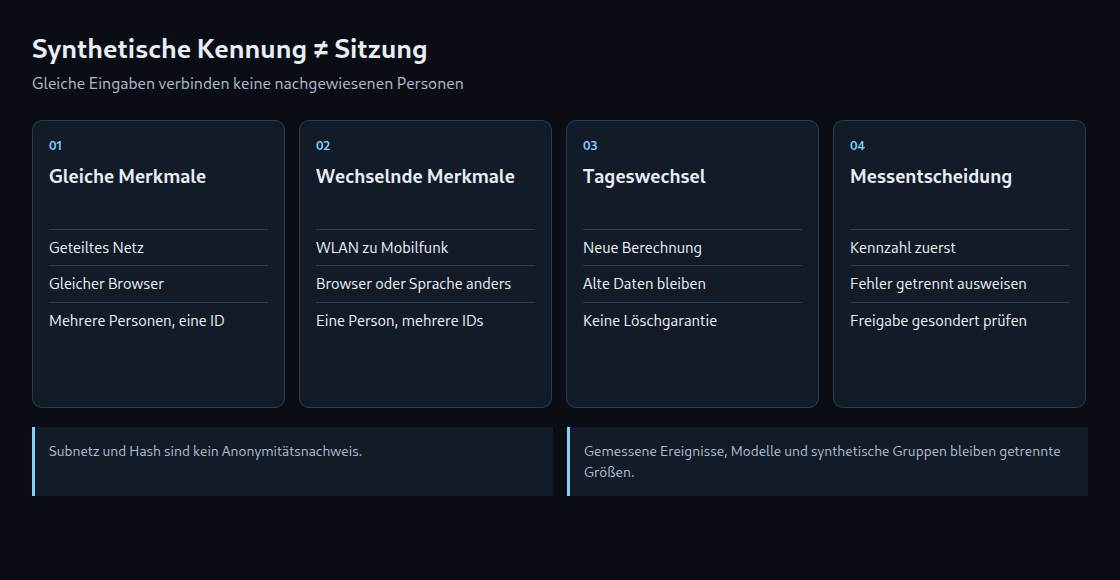
Ohne wiedererkennbare Kennung lassen sich Seitenaufrufe nicht ohne Weiteres zu Besuchen verbinden. Ein Hash aus IP-Subnetz und Browsermerkmalen löst dieses Problem nicht zuverlässig: Verschiedene Personen können dieselbe Kennung erhalten, während eine Person mehrere Kennungen erzeugt. Eine solche Kennung beschreibt zunächst eine Gruppe gleicher Eingaben, keine nachgewiesene Sitzung.
Die folgende Einordnung erklärt die technischen Grenzen synthetischer Kennungen. Eine Cookie-Ablehnung wird dadurch nicht zur Freigabe für eine alternative Wiedererkennung.
Was eine synthetische Kennung tatsächlich verbindet
Ein Hash ist ein aus Eingaben berechneter Code. Ein typisches Verfahren kombiniert den Netzanteil einer IP-Adresse, die Browserbeschreibung im User-Agent, die bevorzugte Sprache und einen täglich wechselnden Wert. Gleiche Eingaben ergeben denselben Hash. Das ist eine Eigenschaft der Berechnung, kein Beweis für denselben Browser.
| Beispiel | Ergebnis | Messfehler |
|---|---|---|
| Zwei Beschäftigte im selben Firmennetz mit gleichem Browser und gleicher Sprache | Gleiche Eingaben und Kennung | Zwei Personen werden zusammengeführt. |
| Ein Telefon wechselt vom WLAN ins Mobilfunknetz. | Anderes IP-Netz, neue Kennung | Ein Besuch kann auseinanderfallen. |
| Ein Browser besucht morgens und abends dieselbe Website. | Möglicherweise gleiche Tageskennung | Getrennte Besuche werden ohne zusätzliche Zeitregel vermischt. |
| Ein Besuch überschreitet den Tageswechsel. | Neuer Tageswert, neue Kennung | Ein laufender Besuch wird geteilt. |
Diese Fehler entstehen schon vor dem Hashing. Ein längerer Hash beseitigt keine identischen Eingaben. Eine auf 16 Hexzeichen gekürzte Ausgabe hat zusätzlich nur 64 Bit; mögliche kryptografische Kollisionen sind ein anderes Problem als das absichtliche Zusammenlegen gleicher Merkmale.
Cookie-Ablehnung bedeutet nicht immer eine gemessene Einzelsitzung
Das Verhalten hängt vom Produkt und der Konfiguration ab. Ein vollständig blockierter Analytics-Tag sendet keine Messereignisse. Der erweiterte Google Consent Mode kann ohne Analyse-Cookies Signale senden. GA4 kann unter geeigneten Voraussetzungen modellierte Nutzer- und Sitzungsmetriken anbieten. Das sind Schätzungen, keine Wiederherstellung der individuellen Wege.
Deshalb ist die Behauptung falsch, jeder abgelehnte Seitenaufruf werde zwangsläufig zu einer vollständigen Einzelsitzung und sämtliche Berichte seien wertlos. Ebenso falsch wäre das Gegenversprechen, ein Subnetz-Hash stelle die tatsächlichen Wege wieder her. Gemessene Ereignisse, modellierte Werte und eigene Gruppierungen benötigen getrennte Kennzeichnungen.
Kein Cookie ist kein Anonymitätsnachweis
Hashing ist keine Verschlüsselung. Eine gekürzte IP und Browsermerkmale können weiterhin eine Zuordnung oder Verknüpfung ermöglichen. Pseudonymisierung ist deshalb von nachgewiesener Anonymisierung zu unterscheiden. Die Kürzungen IPv4 /24 und IPv6 /48 sind technische Entscheidungen, keine gesetzlichen Grenzwerte für Anonymität.
Art. 5 Abs. 3 der ePrivacy-Richtlinie ist nicht auf Cookies beschränkt. Die EDSA-Leitlinien behandeln auch IP-basiertes Tracking; die konkrete Herkunft und Verarbeitung der Informationen zählen. In Deutschland ist § 25 TDDDG zu prüfen. Eine erforderliche Einwilligung oder eine einschlägige Ausnahme und die datenschutzrechtliche Grundlage der weiteren Verarbeitung sind getrennte Fragen.
Auch der Satz „keine Verarbeitung vollständiger IP-Adressen“ wäre bei einer Funktion falsch, die zuerst die vollständige Adresse empfängt und anschließend kürzt. Netzwerk, Proxy und Protokollierung können weitere Verarbeitungsstellen sein. Eine Kontrolle allein der Set-Cookie-Antwortheader erfasst diese Datenwege nicht.
Ein Tageswechsel löscht keine gespeicherten Daten
Ein neuer Tageswert verändert zukünftige Hashes. Bereits gespeicherte Kennungen, Ereignisse und Verknüpfungen bleiben davon unberührt. Zeitpunkte, Konten, URLs oder andere Felder können weiterhin Zusammenhänge herstellen. Mehrtägige Zuordnung wird daher nicht mathematisch unmöglich.
Ein Salt ist ein zusätzlicher Wert, der in die Hash-Berechnung eingeht. Dieser Wert ist üblicherweise kein Geheimnis. Ein gesondert geschützter HMAC-Schlüssel kann das Durchprobieren ohne Schlüssel erschweren, löst aber weder Gruppenfehler noch Rechtsfragen. Speicherung, Sicherung, Zugriff und Löschung des Schlüssels sowie der Ereignisdaten brauchen jeweils ein eigenes Konzept.
Ein WordPress-Transient speichert einen Wert vorübergehend, damit eine erneute Berechnung oder Abfrage entfällt. Als Schlüsselspeicher ist dieser Zwischenspeicher unzuverlässig: Einträge können vorzeitig verschwinden. Gleichzeitige Erstaufrufe können bei ungeschützter Erzeugung unterschiedliche Werte verwenden. Datenbank- und Cache-Sicherungen können alte Werte erhalten. Ablaufzeit und nachgewiesene Löschung sämtlicher Kopien sind verschiedene Dinge.
Warum ein universeller Codebaustein nicht genügt
IP-Adressen benötigen einen Parser: ein Programmteil, der ihren Aufbau und gültige Kurzschreibweisen erkennt. Das Abschneiden von durch Doppelpunkte getrennten Textteilen behandelt komprimiertes IPv6 und IPv4-abgebildete IPv6-Adressen falsch. Hinter einem Proxy bezeichnet REMOTE_ADDR häufig den Proxy; beliebige weitergeleitete Header sind wiederum manipulierbar. Eine fehlende Adresse darf nicht still alle Anfragen unter einem Ersatzwert zusammenfassen.
Node.js-Code mit require(‘crypto’) ist kein direkt einsetzbares sGTM-Template. GTM verwendet eigene Sandbox-APIs. Cloudflare Workers besitzen eine eigene Laufzeit und Kompatibilitätskonfiguration. Ein kopierter Hashgenerator enthält außerdem noch keine Freigabeprüfung, sichere Schlüsselverwaltung, Ereigniserfassung oder getestete Empfängerzuordnung.
Zielsysteme nicht blind mit Ersatzkennungen versorgen
Eine GA4-Client-ID ist keine Sitzungs-ID. Eine eigene Tageskennung als client_id verändert die Identitätslogik; non_personalized_ads=1 stellt weder fehlende Einwilligung her noch implementiert dieser Parameter allein Consent Mode. Eine passende Schnittstelle ersetzt keine zulässige Verarbeitung.
Matomo dokumentiert für _id genau 16 Hexzeichen. Der Wert syn_ plus 16 Hexzeichen entspricht diesem Format nicht. Piwik PRO benötigt eine eigene Prüfung der aktuellen Schnittstelle; gleich klingende Produkte sind nicht austauschbar. Ein BigQuery-Export bekommt durch die Erzeugung einer Kennung auch nicht automatisch eine neue oberste Spalte. Ein eigenes Schema oder eine ausdrücklich modellierte Auswertung ist erforderlich.
Eine belastbare Messentscheidung treffen
Zuerst zählt die benötigte Kennzahl. Für tägliche Gesamtzahlen kann es ausreichen, Ereignisse früh zusammenzuzählen, ohne wiedererkennbare Besucher zuzuordnen. Voraussetzung bleibt, dass die konkrete Erfassung zulässig ist. Um die aufeinanderfolgenden Schritte einzelner Besuche zu beschreiben, sind zuverlässige, erlaubte Kennungen und festgelegte Regeln für Beginn und Ende einer Sitzung nötig. Berechnete Gruppen dürfen nicht als echte Personen oder vollständige Besuchsverläufe erscheinen.
Eine Prüfung verwendet künstlich erstellte Testfälle oder zulässig erhobene Vergleichsdaten: gemeinsame Netze, wechselnde Adressen, identische Browser, Tageswechsel und fehlende Felder. Auszuweisen sind Zusammenführungen, Aufspaltungen und unbekannte Fälle. Eine Vergleichsgruppe mit Einwilligung kann anders zusammengesetzt sein als die übrigen Besuche und ist kein automatischer Qualitätsbeweis.
Fragen und Antworten
Beweist eine neue Kennung nach Mitternacht die Löschung?
Nein. Der Test zeigt nur eine geänderte Berechnung. Gespeicherte Daten und Sicherungen benötigen eigene Löschkontrollen.
Ist eine Tageskennung bereits eine Sitzung?
Nein. Eine Sitzung benötigt eine definierte Zeit- und Ereignislogik. Selbst mit einer Inaktivitätsgrenze bleiben Fehler der zugrunde liegenden Wiedererkennung bestehen.
Quellen
Passend dazu