

 English
 Deutsch
 Polski
Failover WAN: co dzieje się z otwartymi połączeniami przy przełączeniu łącza

Management Summary
Automatyczne przełączenie internetu uruchamia zapasowe łącze po awarii głównego. Poprawia dostępność sieci domowej lub firmowej, ale nie musi zachować trwających rozmów, pobierania plików czy innych zadań. Zmiana publicznego adresu może zerwać istniejące połączenia. Dlatego szybkie przełączenie routera nadal może oznaczać zauważalną przerwę w pracy. Wznowienie zależy również od aplikacji. Łącze zapasowe zwiększa dostępność, lecz samo nie gwarantuje nieprzerwanego działania każdej usługi.
Spis treści
Failover WAN przełącza ruch na inny dostęp do internetu po wykryciu awarii. Działająca trasa nie oznacza jednak automatycznego zachowania otwartych połączeń. Decydują adresy widoczne na zewnątrz, stan routera, protokół transportowy i sposób wznawiania pracy aplikacji.
Typowy przypadek w tym artykule to dwa niezależne łącza z różnymi publicznymi adresami IPv4 i NAT. NAT zamienia adresy lokalne na publiczny adres używany w internecie. Router zapisuje, które połączenie wewnętrzne odpowiada danemu przypisaniu adresu zewnętrznego i portu. Rozwiązanie zachowujące stały adres zewnętrzny lub korzystające z odpowiedniego tunelu ma inne warunki działania. Twierdzenie, że każde przełączenie kończy wszystkie sesje, byłoby więc nieprawdziwe.
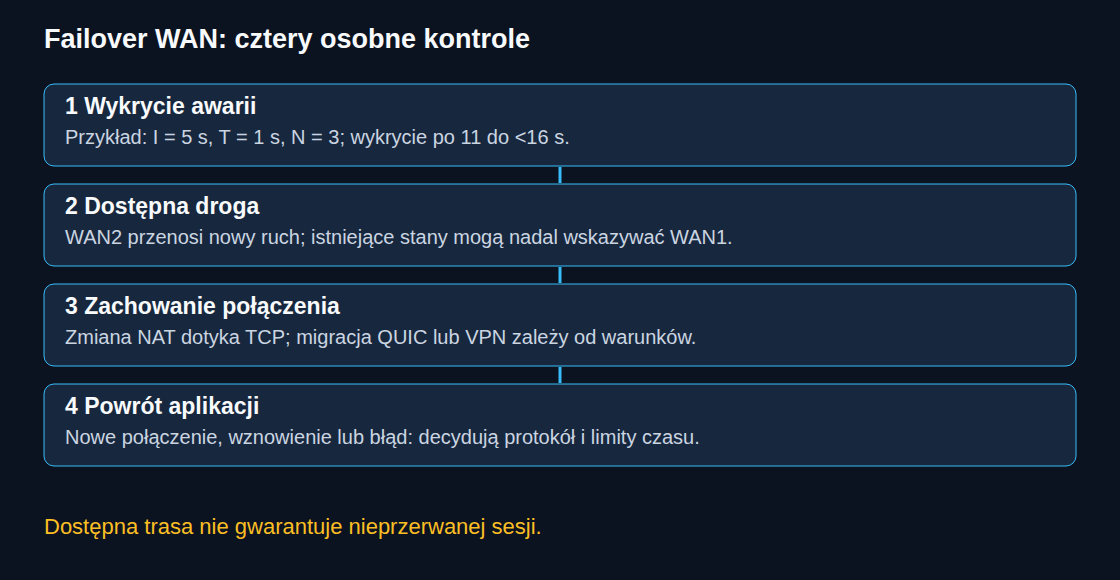
Dlaczego zmiana adresu przerywa zwykłe TCP
Zwykłe połączenie TCP identyfikują adresy źródła i celu oraz porty. Jeśli po przełączeniu ruch jest tłumaczony na inny publiczny adres źródłowy, serwer nie może traktować tego ruchu jako poprzedniego połączenia. Sama nowa trasa nie przenosi stanu TCP na nowy adres.
Błąd nie musi stać się widoczny dokładnie w chwili przełączenia. Stan NAT może początkowo pozostać przypisany do WAN1; aplikacje mogą czekać na retransmisje lub wcześniej przerwać pracę przez własne limity czasu. Jeśli pierwotna droga wróci odpowiednio szybko z zachowanym stanem, połączenie może działać dalej. Zwykła zmiana adresu źródłowego wymaga natomiast zazwyczaj nowego połączenia SSH lub z bazą danych.
Wykrycie awarii, zmiana trasy i powrót aplikacji
Żaden wzór oparty wyłącznie na interwale i liczbie błędów nie opisuje wszystkich routerów. Prosty model można jednak wyprowadzić jednoznacznie: testy rozpoczynają się co I, każdy nieudany test kończy się po T, a dokładnie N kolejnych niepowodzeń uruchamia decyzję. Obowiązuje T < I, a ostatni test przed awarią zakończył się powodzeniem. d oznacza oczekiwanie na pierwszy start testu po awarii, a D to czas wykrycia.
I = 5 s, T = 1 s, N = 3
0 <= d < I
D = d + (N - 1) * I + T

11 s <= D < 16 s
średnia D = 13,5 s  (równomierny rozkład d)
Średnia zakłada, że awaria jest równie prawdopodobna w każdej chwili między rozpoczęciem dwóch kolejnych testów. Obliczenie nie obejmuje późniejszej zmiany tras ani powrotu aplikacji. Inna definicja tolerowanych błędów, ocena utraconych pakietów w stale przesuwanym przedziale czasu, opóźniona ocena lub rozpoczynanie testów dopiero po zakończeniu poprzednich zmieniają model. Przykładowo pfSense dokumentuje także progi strat, okresy oceny i interwały alarmów.
Co może działać dalej
| Ruch | Przy typowej zmianie adresu NAT |
|---|---|
| SSH lub baza danych przez TCP | Istniejące połączenie zwykle nie może migrować; potrzebne jest nowe połączenie i ewentualne odtworzenie stanu aplikacji. |
| Pobieranie przez HTTP/1.1 lub HTTP/2 | Połączenie TCP jest dotknięte zmianą. Obsługa Range i kontrola tej samej wersji pliku mogą umożliwić wznowienie, jeśli aplikacja to realizuje. |
| HTTP/3 przez QUIC | Zmiana drogi jest możliwa, zależnie od implementacji, stanu połączenia, sprawdzenia nowej drogi i limitów czasu. |
| Telefonia i wideokonferencje | Media mogą zostać przerwane. Koniec rozmowy albo znalezienie nowej drogi zależą między innymi od sygnalizacji i obsługi ICE. |
| DNS | Zapytanie UDP może zginąć i zostać ponowione. DNS korzysta też z TCP i innych transportów połączeniowych; nie ma gwarancji przetrwania każdej operacji. |
| VPN | W odpowiednich warunkach połączenia wewnętrzne mogą przetrwać; samo automatyczne odbudowanie tunelu tego nie gwarantuje. |
QUIC potrafi przypisywać pakiety do połączenia za pomocą identyfikatorów połączenia. Nowa droga nadal musi działać i przejść weryfikację. Aktywna migracja wymaga potwierdzonego handshake i może być ograniczona; zmiana adresu wywołana przez NAT wymaga osobnego rozpatrzenia. Samo HTTP/3 nie gwarantuje nieprzerwanego działania aplikacji.
VPN musi zachować adresy wewnętrzne i istotne stany. Ruch internetowy przez zdalne wyjście VPN potrzebuje również stabilnego mapowania zewnętrznego w tym miejscu. WireGuard obsługuje roaming, a IKEv2 może korzystać z MOBIKE. Jeżeli przerwa przekroczy limit czasu aplikacji wewnętrznej, sam stały adres nie zachowa sesji.
Powrót bez zbędnej drugiej przerwy
Powrót do WAN1 nie musi natychmiast przenosić istniejących połączeń z WAN2. Router może preferować WAN1 dla nowych połączeń, pozostawiając dotychczasowe stany WAN2 do naturalnego wygaśnięcia. Wymuszone przekierowanie lub usunięcie stanów może natomiast wywołać kolejną przerwę. Rzeczywiste zachowanie zależy od konfiguracji.
Opóźniony powrót i odrębne kryteria awarii oraz przywrócenia ograniczają częste przełączanie. Stała proporcja timerów nie jest uniwersalnym rozwiązaniem. Decydują stabilność łącza, wymagania aplikacji i obsługa stanów.
Miarodajny test przełączania awaryjnego
Ruch kontrolny musi rzeczywiście przechodzić przez sprawdzane łącze. Odpowiedź modemu nie dowodzi dostępności internetu, a niedostępny pojedynczy cel testowy nie dowodzi awarii łącza. Kilka odpowiednich sygnałów lub celów może poprawić ocenę, jeżeli router to obsługuje. W pfSense każda brama wymaga odrębnego adresu IP monitorowania.
Planowany test osobno rejestruje moment awarii, decyzję dotyczącą bramy, udane nowe połączenie i powrót trwających operacji aplikacji. Test powinien obejmować także powrót na łącze główne, rozmowy przychodzące i rzeczywiście używane protokoły. Wznawialne pobieranie i kopie zapasowe zmniejszają skutki bez obietnicy zachowania każdej sesji.
Pytania i odpowiedzi
Dlaczego telefon IP może pozostać nieosiągalny po przełączeniu?
Rejestracja albo istniejący przepływ SIP mogą nadal wskazywać poprzednie łącze. Stan NAT lub zapory może dodatkowo wiązać ruch z WAN1. Operatorzy SIP różnią się obsługą rejestracji, przepływów, keep-alive i ponownego zgłaszania. Krótszy interwał rejestracji nie rozwiązuje więc każdego przypadku.
Selektywne usunięcie odpowiednich stanów może pomóc. Wyczyszczenie całej tablicy może jednak przerwać także działające połączenia. Fałszywy alarm monitorowania nie czyni tej operacji nieszkodliwą. Zmiany wymagają przetestowanej konfiguracji konkretnego routera i usługi telefonicznej.
Czy krótszy interwał testów przyspiesza przełączenie?
W opisanym modelu skraca część związaną z wykryciem awarii. Przy I=1 s, T=0,2 s i N=3 wynosi ona od 2,2 do niecałych 3,2 sekundy. Inne modele monitorowania mogą działać inaczej. Zbyt czułe progi mogą wywoływać zbędne przełączenia przy obciążeniu lub pojedynczych stratach pakietów kontrolnych.
Czy jednoczesne używanie obu łączy pomaga?
Równoważenie obciążenia według połączeń rozdziela nowe połączenia między kilka dróg. Po awarii jednego łącza połączenia na drugim mogą działać dalej, jeśli obsługa stanów nie wywoła dodatkowej przerwy. To inne rozwiązanie niż agregacja przenosząca pojedyncze połączenia przez kilka dróg.
Logowanie związane z adresem IP może sprawiać problemy przy zmianie adresów wyjściowych. W pfSense sticky connections wiążą host źródłowy z tą samą bramą przez czas obowiązywania przypisania. Inne produkty mogą grupować ruch inaczej. Ogranicza to możliwości rozdziału ruchu jednego urządzenia i nie zastępuje migracji otwartych połączeń.
Źródła
- IETF RFC 9293: Transmission Control Protocol
- IETF RFC 9000: migracja połączeń QUIC
- IETF RFC 4555: mobilność i wiele łączy w IKEv2 (MOBIKE)
- WireGuard: wbudowana obsługa zmiany sieci
- IETF RFC 8445: ponowne uruchomienie ICE
- IETF RFC 7766: DNS przez TCP
- IETF RFC 9110: żądania zakresów pliku przez HTTP
- IETF RFC 5626: połączenia SIP inicjowane przez klienta
- Netgate: ustawienia i monitorowanie bram
- Netgate: stany połączeń podczas awarii i powrotu bramy
- Netgate: równoważenie obciążenia i przełączanie awaryjne
Powiązane artykuły


