English
 Deutsch
 Polski
Struktury map witryn zmierzone na 24 stronach: indeksy, podział, rozszerzenia i naruszenia

Spis treści
W małym serwisie mapa witryny jest listą. W dużym to budowla z plików: indeks wskazujący pliki podrzędne, podział według rodzaju treści, języka lub kolejnego numeru oraz rozszerzenia dla obrazów, wideo, newsów i wersji językowych. Każda z tych decyzji ma w protokole własny limit i przy każdej zdarzają się błędy, które nie psują widocznie żadnej strony.
Na potrzeby tego artykułu 1 października 2026 odczytano mapy witryn 24 domen i sprawdzono je rdzeniem nowego narzędzia Sitemap Checker & Validator: wyszukiwarki, infrastruktura, wiadomości, administracja, handel i podróże w trzech krajach, a do tego ta strona.
Jak przeprowadzono pomiar
Mapę szukano tak, jak znajduje ją crawler: najpierw pierwszy wiersz Sitemap: w robots.txt, w przeciwnym razie /sitemap.xml i /sitemap_index.xml. Jeśli plik był indeksem, pobierano trzy pliki podrzędne: pierwszy, jeden ze środka i ostatni. Pliki spakowane (.gz) rozpakowywano. Sprawdzał ten sam kod, który działa w narzędziu w przeglądarce, tutaj pod Node na własnym serwerze.
Nie sprawdzano, czy adresy z map są osiągalne. To osobne pytanie z własnymi pułapkami, a do niego służy audytor map witryn XML, który pobiera próbkę adresów. Tu chodzi o same pliki: budowę, format oraz reguły sitemaps.org i Google.
Sześć domen bez czytelnej mapy
Z 24 domen czytelną mapę dostarczyło 18. Cztery nie podają mapy w robots.txt i pod /sitemap.xml odpowiadają 404, jedna z nich dopiero po przekierowaniu. Dwie odprawiły pobierającego klienta kodem 403, jedna z nich przy pliku, który podaje jej własny robots.txt.
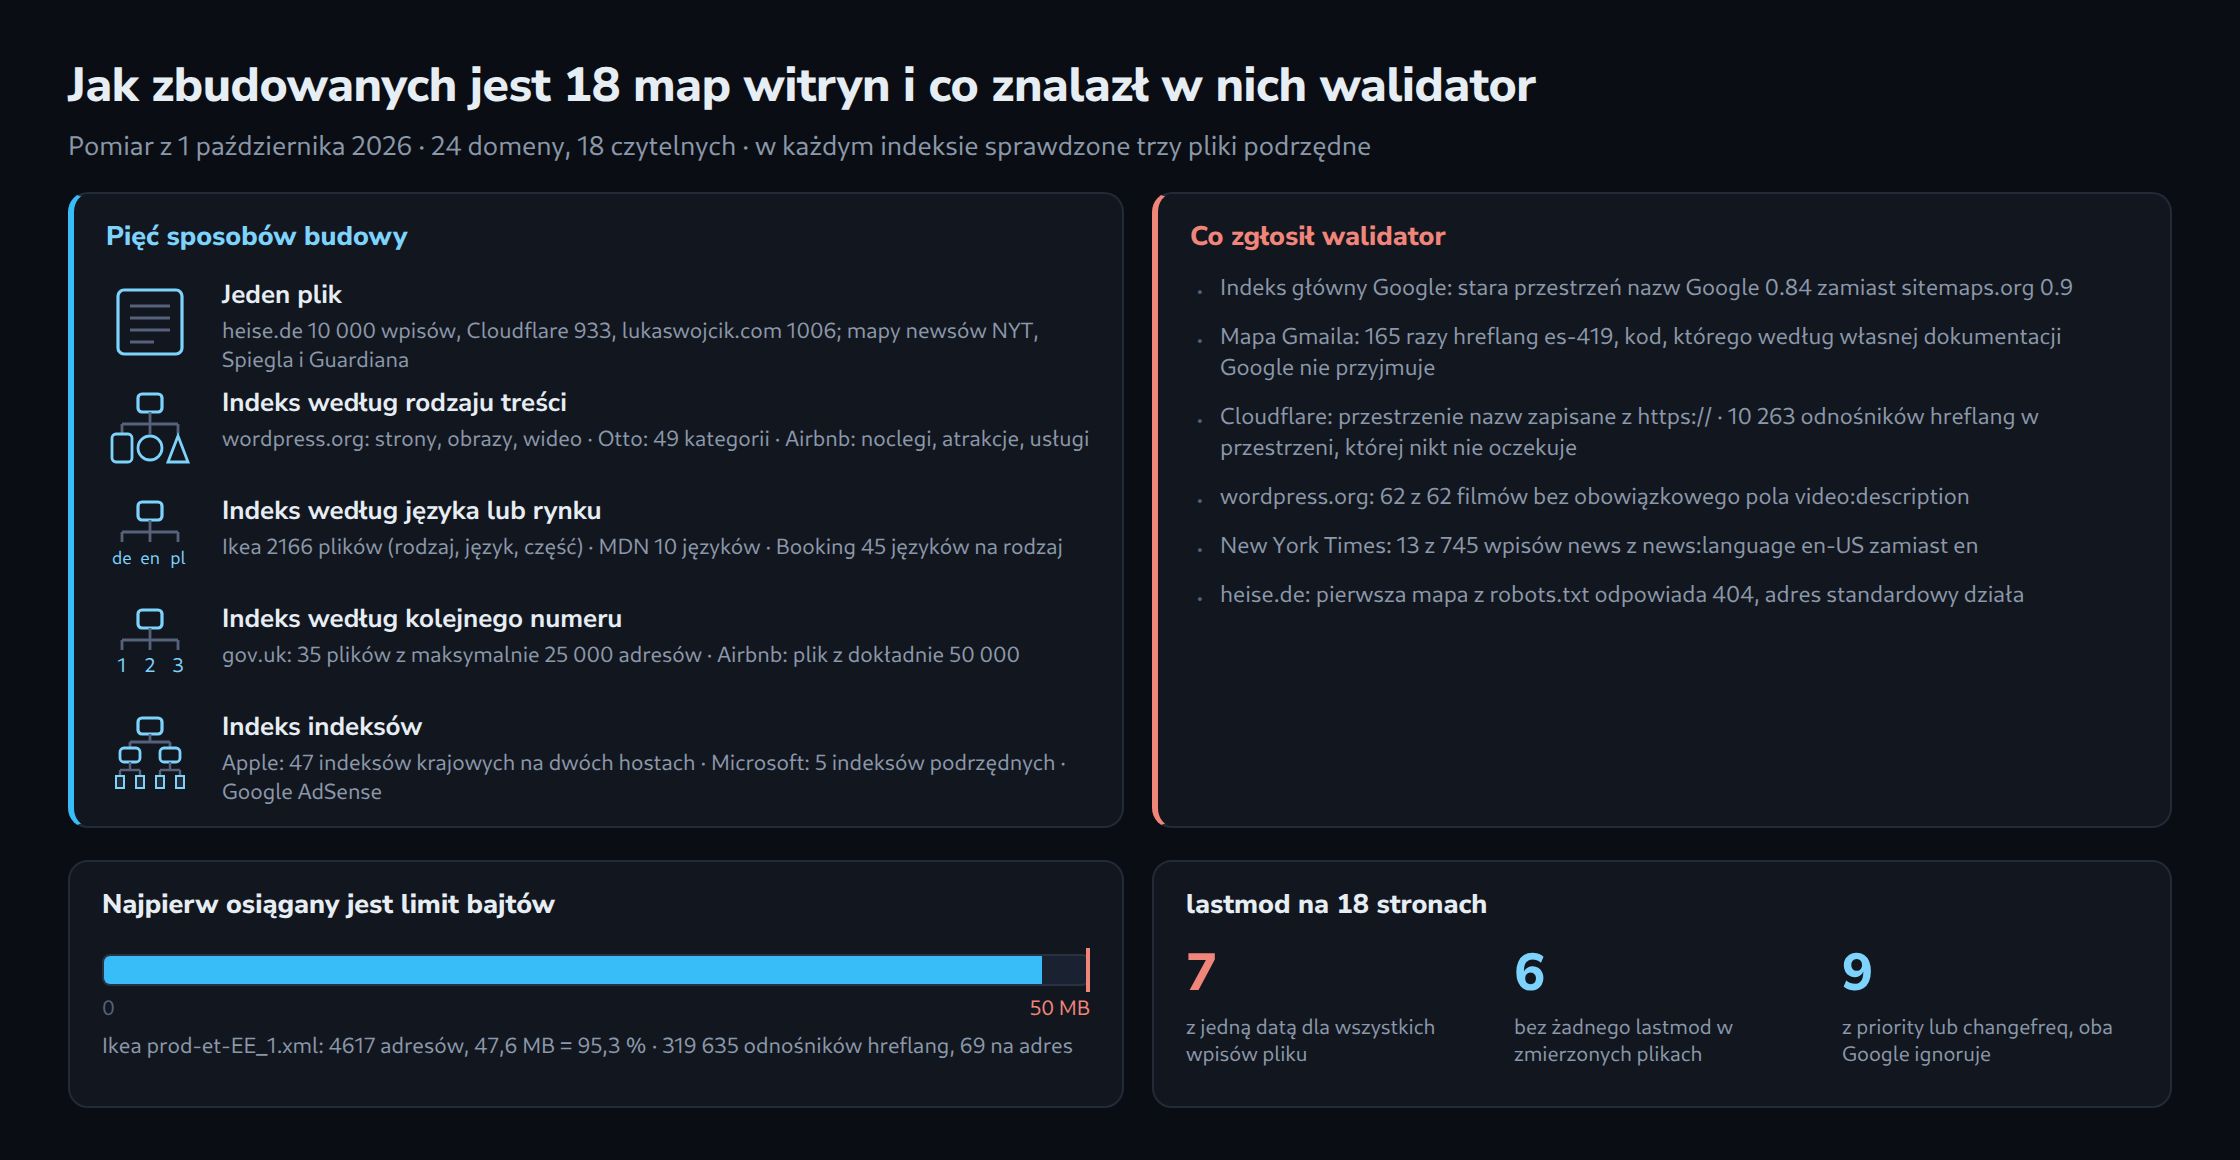
Jeden przypadek leży pośrodku. heise.de wymienia w robots.txt siedem map, a pierwsza z nich, /sitemapindex.xml, odpowiada 404. Adres standardowy /sitemap.xml dostarcza natomiast plik z 10 000 wpisów. Crawler, który czyta wszystkie wiersze, nic nie traci; narzędzie, które bierze tylko pierwszy, zgłasza brak mapy.
robots.txt jako spis treści
Protokół dopuszcza dowolną liczbę wierszy Sitemap: i właśnie tak działa kilka dużych serwisów: zamiast indeksu lista plików stoi od razu w robots.txt.
| Domena | Wiersze Sitemap: |
|---|---|
| booking.com | 434 |
| nytimes.com | 25 |
| microsoft.com | 22 |
| otto.de | 19 |
| bbc.co.uk | 13 |
| wordpress.org | 9 |
| heise.de | 7 |
| siedem kolejnych | od 1 do 5 |
Ma to zaletę, o której nie mówi żadna specyfikacja: każdy wiersz jest zarazem dowodem, że operator hosta chce tego pliku. Według sitemaps.org mapa może zawierać adresy innego hosta tylko wtedy, gdy wskazuje na nią robots.txt tego hosta.
Pięć sposobów budowy
18 map da się przypisać do pięciu form, a niektóre serwisy łączą dwie z nich.
| Forma | Przykłady z pomiaru |
|---|---|
| jeden plik | heise.de (10 000 wpisów), lukaswojcik.com (1006), Cloudflare (933); mapy newsów New York Timesa, Spiegla i Guardiana, każda wymieniona jako pierwsza w ich robots.txt |
| indeks według rodzaju treści | wordpress.org (strony, obrazy, wideo), Otto (49 kategorii), Airbnb (noclegi, atrakcje, cele podróży, strony pomocy) |
| indeks według języka lub rynku | Ikea z 2166 plikami według wzoru prod-et-EE_1.xml, MDN z dziesięcioma językami, Booking z 45 językami na rodzaj treści, Shopify z 568 plikami |
| indeks według kolejnego numeru | gov.uk z 35 plikami po maksymalnie 25 000 adresów, Airbnb ze 140 plikami samych noclegów |
| indeks indeksów | Apple (47 indeksów krajowych, jeden z nich na apple.com.cn), Microsoft (pięć indeksów podrzędnych), jeden plik podrzędny Google |
Ostatnia forma zasługuje na drugie spojrzenie. sitemaps.org opisuje indeks jako listę map, a przewodnik Google po dużych mapach nie mówi nic o zagnieżdżaniu. Indeks wskazujący kolejne indeksy polega więc na zachowaniu, którego nikt nie gwarantuje. Indeks główny Apple wymienia przy tym pliki na drugim hoście, co według protokołu pokrywa tylko robots.txt tamtego hosta.
Limit osiągany jako pierwszy
Mapa witryny może zawierać najwyżej 50 000 adresów i mieć najwyżej 50 MB bez kompresji. gov.uk zatrzymuje się na połowie z 25 000 adresów na plik, jeden plik Airbnb stoi z dokładnie 50 000 na samej granicy. U Ikei działa drugi limit.
Plik prod-et-EE_1.xml zawiera tylko 4617 adresów, ale ma 47,6 MB, czyli 95,3 procent dozwolonego rozmiaru. Każdy adres niesie średnio 69 wpisów xhtml:link dla wersji językowych, łącznie 319 635, a do tego 22 797 obrazów i 1585 filmów. Około 10,8 KB na wpis to już nie adres, lecz jego opis.
Taki rachunek przynosi hreflang w mapie witryny: każda wersja strony wymienia wszystkie pozostałe wersje i samą siebie. We wszystkich plikach łącznie liczba odnośników rośnie więc z kwadratem liczby wersji językowych, a nie z liczbą stron. Przy mapach z hreflang lepszą miarą podziału jest limit bajtów niż liczba adresów.
Gdzie tkwią naruszenia
W formacie podstawowym z loc, lastmod, changefreq i priority walidator znalazł niewiele: kilka zdublowanych wpisów, w heise.de trzy adresy z fragmentem (#) i dwa na innym hoście oraz puste pliki podrzędne w Shopify i Ikei. Naruszenia o znaczeniu niemal w całości tkwią w przestrzeniach nazw i rozszerzeniach.
- Indeks główny Google: stoi w starej przestrzeni nazw Google
http://www.google.com/schemas/sitemap/0.84zamiast whttp://www.sitemaps.org/schemas/sitemap/0.9. Przestrzenie nazw porównuje się znak po znaku; dla ścisłego czytnika to nie jest indeks map witryny. - Mapa Gmaila: 166 adresów z 9075 odnośnikami hreflang, z czego 165 z kodem
es-419dla hiszpańskiego z Ameryki Łacińskiej. Strona pomocy Google o wersjach językowych podaje właśnie ten kod jako przykład nieobsługiwanego, bo liczą się tylko regiony według ISO 3166-1. Sama strona pomocy ma w nagłówku HTML wersję zhreflang="es-419". - Cloudflare: przestrzenie nazw mapy i
xhtmlzapisano zhttps://. Przestrzeń nazw jest identyfikatorem, nie adresem; zhttpsto inny identyfikator, a 10 263 odnośników hreflang leży w przestrzeni, której żaden czytnik nie oczekuje. - wordpress.org: żaden z 62 filmów w mapie wideo nie ma
video:description, które Google prowadzi jako pole obowiązkowe. Mapa obrazów tego samego serwisu wymienia strony wielokrotnie, raz na obraz, samą stronę główną 91 razy; 521 z 693 wpisów powtarza już wymieniony adres, choć jeden wpisurlmoże nieść do 1000 obrazów. - New York Times: 13 z 745 wpisów mapy newsów ma
news:languageo wartościen-US. Wymagany jest kod ISO 639 z dwóch lub trzech liter, wyjątki dotyczą tylkozh-cnizh-tw. - BBC: indeks wymienia trzy mapy dotyczące wyborów z 2014 roku, jedną z nich z 204 adresami, wszystkimi nadal na
http://.
Czy Google odrzuca te przypadki pojedynczo, czy czyta je wyrozumiale, z zewnątrz zmierzyć się nie da. Wykazać da się tylko, że przeczą one regułom samych formatów i że ścisły czytnik się na nich zatrzymuje.
lastmod: jedna data dla wszystkiego
Z pól dobrowolnych Google korzysta tylko z lastmod, i to tylko wtedy, gdy da się je zweryfikować. priority i changefreq Google ignoruje; mimo to stoją one na 9 z 18 stron.
Na 7 stronach co najmniej jeden plik ma przy każdym wpisie tę samą datę, w tym Cloudflare (933 wpisy, jedna data), plik Ikei (4617 wpisów, jedna data) i Booking (3032 wpisy na plik językowy, jedna data). Taka wartość opisuje przebieg generatora, nie strony. Na 6 stronach żaden zmierzony plik nie zawiera lastmod. Wiarygodnie wyglądają wartości w heise.de (8913 różnych na 10 000), w New York Timesie (736 na 745) i w wordpress.org (51 na 52).
Przypadek, którego żaden walidator nie widzi w obrębie jednego pliku, znalazł się na tej stronie. W dniu pomiaru indeks Yoast podawał dla post-sitemap.xml 28 września jako ostatnią zmianę, a najnowszy wpis w tym pliku miał datę 1 października. lastmod w indeksie ma opisywać zmianę pliku podrzędnego; sprawdzenie tego wymaga obu plików obok siebie.
Reguła lokalizacji i XSD
Dwie reguły protokołu duże serwisy łamią niemal bez wyjątku. Pierwsza to reguła lokalizacji: według sitemaps.org mapa pod /sitemaps/sitemap.xml może zawierać tylko adresy poniżej /sitemaps/. Na dziesięciu z 18 stron co najmniej jeden zmierzony plik narusza tę regułę, zwykle dlatego, że leży w podfolderze takim jak /sitemaps/ i wymienia adresy powyżej. W gov.uk, Ikei, Otto, MDN i trzech serwisach informacyjnych dotyczy to każdego adresu zmierzonych plików. Google uwzględnia takie pliki mimo to, jeśli zgłoszono je w Search Console. Walidator zgłasza więc regułę lokalizacji jako uwagę i tylko wtedy, gdy podany jest adres pliku.
Druga to schemat. XSD z sitemaps.org dopuszcza elementy z obcych przestrzeni nazw tylko z processContents="strict". Poprawna mapa obrazów z jednym image:image nie przechodzi więc samej walidacji XSD; libxml2 2.9.14 zgłosił „No matching global element declaration available, but demanded by the strict wildcard”. Walidacja względem XSD wymaga więc wczytania także schematów rozszerzeń. Równie ścisłe jest XSD w kwestii czasu: 2026-10-01T14:05 bez sekund jest tam niepoprawne, z sekundami, ale bez strefy czasowej poprawne, choć nie w formacie W3C, do którego odsyła sitemaps.org.
Sprawdzenie mapy przed publikacją
Łańcucha z poprawności składni, protokołu i rozszerzeń nie obejmie jedno polecenie. Sitemap Checker & Validator w zestawie narzędzi przyjmuje wklejony XML albo plik, także spakowany, i sprawdza w przeglądarce:
- poprawność składni z wierszem i kolumną, np. niezamaskowane
&albo ucięty koniec pliku, - przestrzeń nazw, kodowanie oraz limity 50 000 wpisów i 50 MB,
loc,lastmod,changefreq,priorityi ich kolejność według XSD,- hreflang z poprawnymi kodami, odwołaniem do siebie i odnośnikami zwrotnymi w obrębie pliku,
- pola obowiązkowe i limity rozszerzeń dla obrazów, wideo i newsów wraz z wycofanymi tagami,
- przy podanym adresie pliku regułę lokalizacji.
Plik nie opuszcza przy tym przeglądarki. Co adresy odpowiadają na żywo, czy przekierowują, mają noindex albo canonical wskazujący gdzie indziej, sprawdza audytor map witryn XML na opublikowanej wersji.
Kontekst i ograniczenia
Zmierzono 24 domeny jednego dnia, po trzy pliki podrzędne na indeks. Sama Ikea ma 2166 plików; o reszcie pomiar nic nie mówi. Sześć domen pozostało nieczytelnych, dwie z nich z powodu odmowy, której crawler o znanej nazwie być może nie dostaje. Pomiar opisuje też naruszenia formatów, nie ich skutki w wyszukiwarce: jak wyrozumiale Google traktuje błędną przestrzeń nazw albo en-US, nie jest udokumentowane.
Pytania i odpowiedzi
Dlaczego poprawna mapa obrazów nie przechodzi walidacji względem XSD z sitemaps.org?
Schemat dopuszcza elementy z obcych przestrzeni nazw tylko z processContents="strict". Ściśle sprawdzający parser musi więc znaleźć deklarację dla image:image, a ta nie stoi w schemacie mapy witryny, lecz w osobnym schemacie rozszerzenia. Wczytanie samego sitemap.xsd daje błąd przy każdym rozszerzeniu, nawet gdy plik jest w pełni poprawny. Rozwiązaniem jest wczytanie także schematów używanych rozszerzeń albo sprawdzanie rozszerzeń według ich udokumentowanych reguł zamiast według XSD.
Czy hreflang lepiej umieścić w mapie witryny, czy w nagłówku strony?
Google przyjmuje wersje językowe na trzy sposoby: jako element link w nagłówku HTML, jako nagłówek HTTP i w mapie witryny. Dla oceny są one równoważne; różnią się kosztem.
W mapie liczba wpisów rośnie z kwadratem liczby wersji, bo każda wersja wymienia wszystkie pozostałe i samą siebie. Tak zmierzony plik Ikei przy 4617 adresach doszedł do 95,3 procent limitu 50 MB. W zamian same strony pozostają lekkie, a adnotacje stoją w jednym miejscu, w którym walidator sprawdzi odwołania do siebie i odnośniki zwrotne w jednym przebiegu.
W nagłówku HTML każda strona niesie tylko własną grupę, a adnotacje zmieniają się razem ze stroną. Przy kilku językach to zwykle prostsza droga; przy dziesiątkach rynków więcej przemawia za mapą, ale wtedy z podziałem według bajtów, a nie według adresów. Utrzymywanie obu dróg naraz podwaja źródła błędów, bo dwie listy tej samej grupy mogą się rozjechać.
Jak czysto podzielić mapę witryny z ponad 50 000 adresów?
Za pomocą indeksu wskazującego kilka plików. Pomagają w tym cztery reguły:
- Pliki podrzędne leżą w folderze indeksu lub niżej, czego Google wymaga dla indeksów.
- Podział opiera się na cesze, która nie zmienia się ciągle, np. rodzaju treści lub języku; kolejny numer przy każdej przebudowie przesuwa adresy do innych plików.
lastmodw indeksie opisuje ostatnią zmianę danego pliku podrzędnego i jest zapisywany razem z nim.- Indeks wskazuje mapy, a nie kolejne indeksy, bo zagnieżdżania nie gwarantuje żadna z obu specyfikacji.
Źródła
- sitemaps.org – Sitemaps XML format
- sitemaps.org – sitemap.xsd
- Google Search Central – Build and submit a sitemap
- Google Search Central – Manage your sitemaps with a sitemap index file
- Google Search Central – Tell Google about localized versions of your page
- Google Search Central – Image sitemaps
- Google Search Central – Video sitemaps and alternatives
- Google Search Central – Create a news sitemap
- W3C – Date and Time Formats
Powiązane artykuły