English
 Deutsch
 Polski
Wykrywanie botów: listy adresów IP a podpisy kryptograficzne

Spis treści
Apple powiększył w sierpniu 2026 pulę adresów stojącą za Applebotem. Zgłaszane liczby to skok z około 2400 adresów w dwunastu prefiksach do mniej więcej 7056 w trzydziestu trzech, a opublikowana lista zakresów jest tam nadal nazywana niepełną. Każda witryna sprawdzająca tego robota wobec zapisanej kopii listy musiała pobrać nową – albo po cichu zaczęła brać uprawnionego robota za oszusta.
Nie jest to wada tego jednego wydania. To cecha definiująca dowód tożsamości przez adres i bardziej zasługuje na zestawienie z alternatywą niż na narzekanie.
Dowód adresowy i jego samoutrzymująca się odmiana
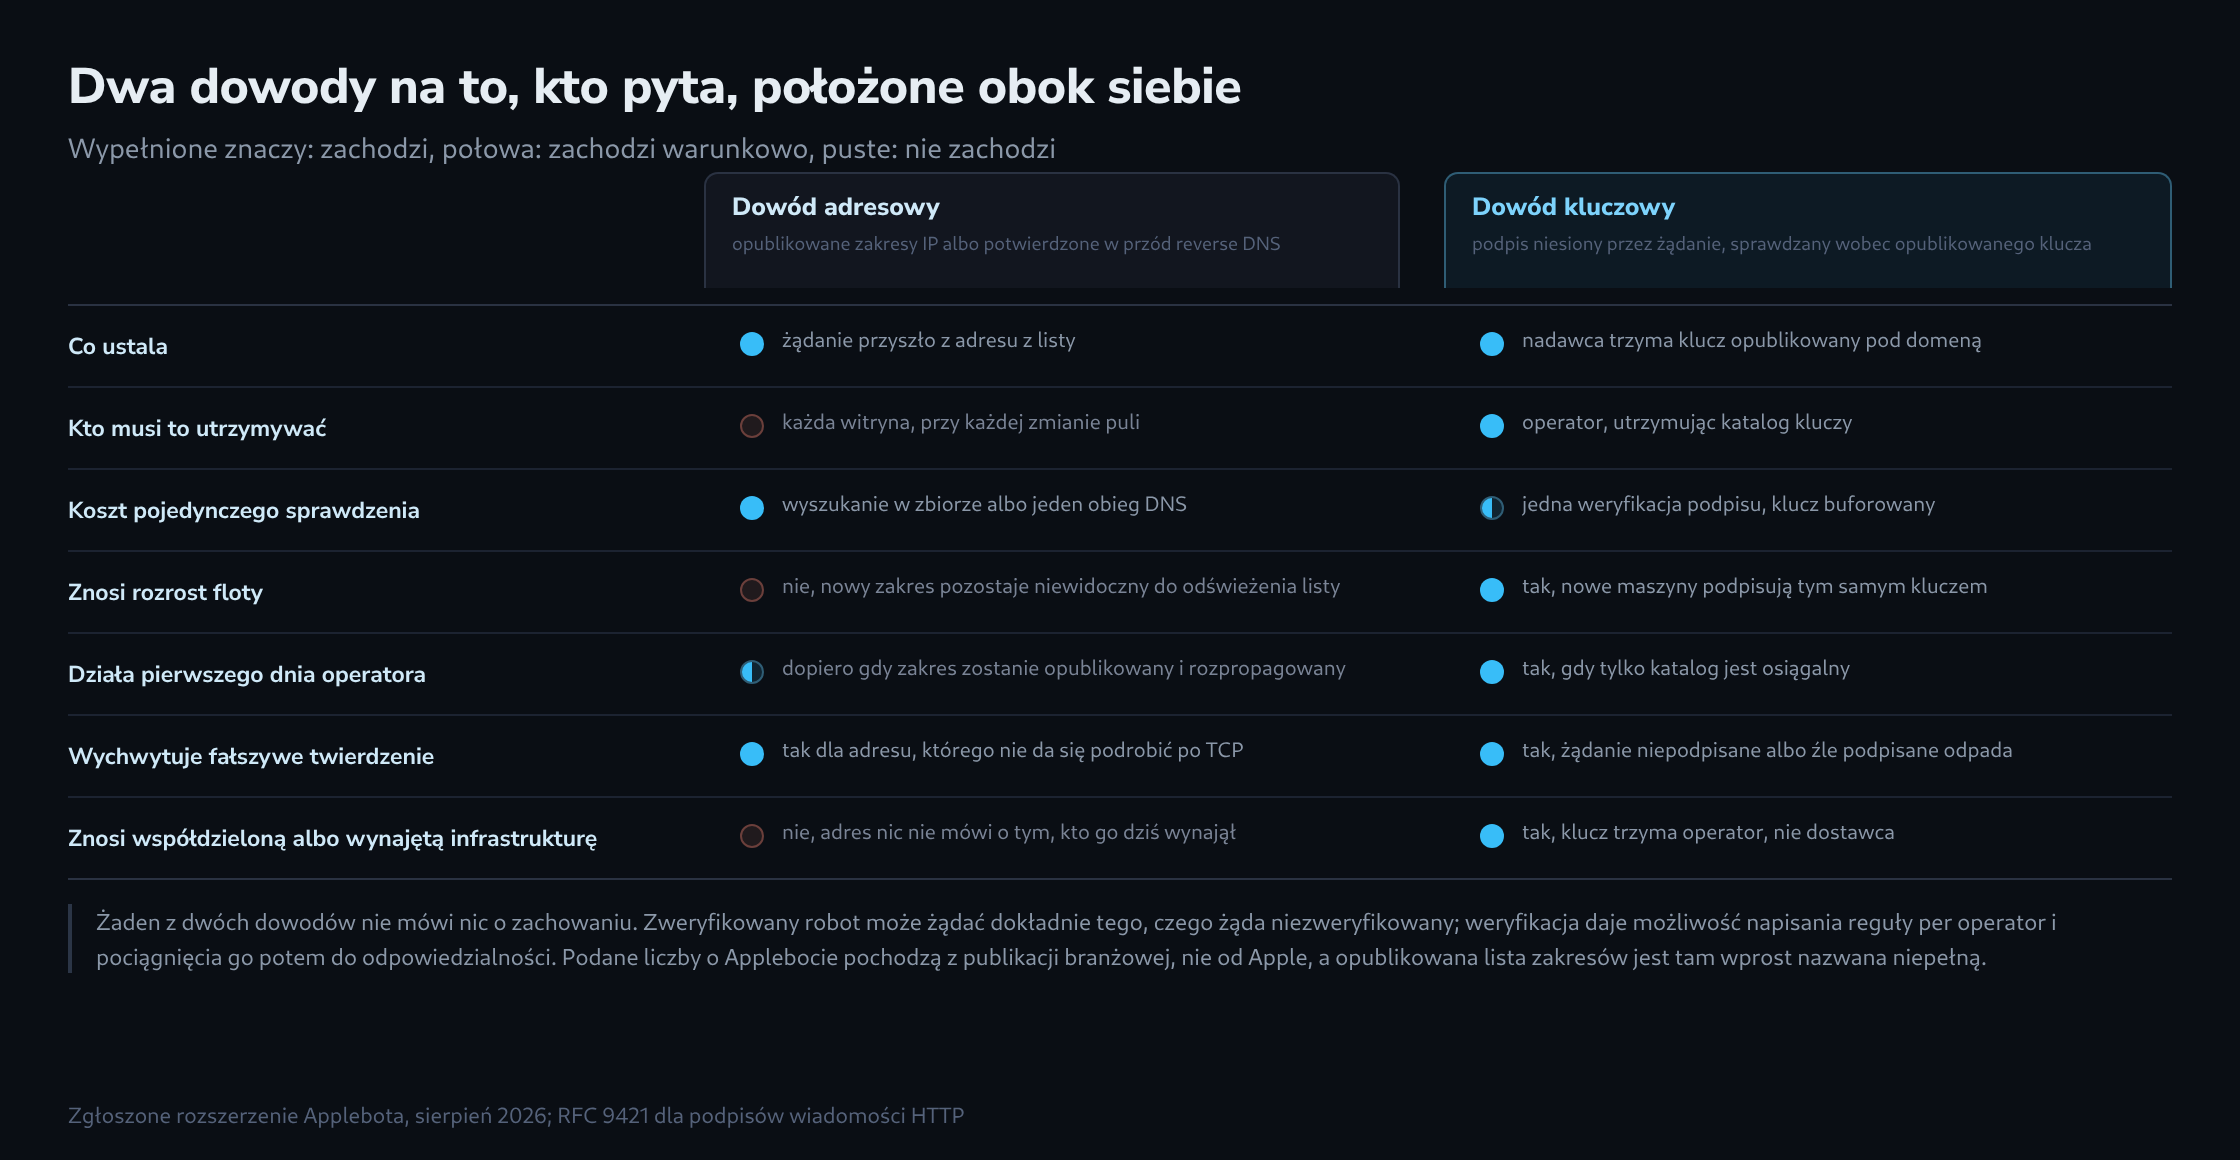
Najprostsza postać to lista zakresów, którą operator publikuje, a każda witryna pobiera. Działa, bo adresu nadawcy nie da się podrobić przez zakończone uzgodnienie TCP – to czyni z niego prawdziwy dowód pochodzenia, a nie twierdzenie.
Przy reverse DNS z potwierdzeniem w przód witryna sprawdza adres bez przechowywania własnej listy zakresów. Najpierw ustala nazwę hosta dla adresu IP. Następnie ustala adres IP dla otrzymanej nazwy i sprawdza, czy jest to ten sam adres, od którego zaczęła.
adres w zadaniu              17.241.75.12

  rozwiazanie wsteczne       -> jakis.applebot.apple.com
  sprawdzenie koncowki       konczy sie domena operatora
  rozwiazanie w przod        -> 17.241.75.12
  porownanie                 ten sam adres, wiec twierdzenie trzyma

  psuje sie bezpiecznie: podrobiony wpis wsteczny nie przezyje
  rozwiazania w przod, bo napastnik nie kontroluje strefy
  w przod nalezacej do operatora
Ta odmiana kosztuje jeden do dwóch obiegów DNS na nowy adres, potem buforowanych, i nie starzeje się, gdy pula rośnie. Dowodem adresowym pozostaje mimo to, ze wszystkim, co z tego wynika.
Ile naprawdę kosztuje rozszerzenie
Pula, która niemal się potraja, tworzy dwa rodzaje usterek, a głośny jest tylko jeden. Głośny to zablokowany robot, zauważony w ciągu dnia, bo treści przestają być indeksowane. Cichy jest gorszy: witryna traktująca niezweryfikowany ruch jak zwykły ruch ludzki ma teraz aktywność robota z kilku tysięcy adresów zapisaną w analityce jako sesje.
Żaden z tych rodzajów nie zgłasza się jako problem z listą. Oba wyglądają na coś innego i właśnie dlatego rytm odświeżania każdej opublikowanej listy zakresów należy do zaplanowanego zadania, a nie do czyjejś pamięci.
Dowód kluczowy
Druga droga przenosi dowód do żądania. Operator trzyma parę kluczy, publikuje połowę publiczną pod kontrolowaną przez siebie domeną i podpisuje każde wychodzące żądanie; witryna sprawdza podpis wobec opublikowanego klucza. Mechanizmem są podpisy wiadomości HTTP według RFC 9421, a Web Bot Auth to ich odmiana wycelowana w agentów.
Przewaga nad adresem jest strukturalna. Klucz idzie za operatorem, nie za maszyną – nowa pojemność podpisuje tym samym kluczem w dniu uruchomienia i żadna lista nigdzie nie wymaga ruszania. Znosi też wynajętą infrastrukturę, gdzie adres naprawdę nie pomaga: blok adresowy należy do dostawcy serwerowni, a to nikomu nie mówi, kto go wynajmuje w tym miesiącu.
Ceną jest to, że istnieje tylko tam, gdzie operator się na to zdecydował. Dowód adresowy działa wobec każdego robota publikującego zakresy, a to prawie wszystkie ugruntowane; dowód kluczowy działa wobec podzbioru, który podpisuje, a ten jest dziś mały.
Który i kiedy
W praktyce te dwa nie konkurują. Sprawdzenie adresu odpowiada na pytanie, na które podpis odpowiedzieć nie może: czy ruch podający się za znanego robota naprawdę pochodzi stamtąd, gdzie ten robot mieszka. Podpis odpowiada na pytanie, na które nie może odpowiedzieć adres: który z kilku operatorów dzielących serwerownię to wysłał.
Rozsądnie jest więc puścić najpierw sprawdzenie adresu, bo jest tanie i pokrywa ugruntowane roboty, a ważny podpis przyjmować jako niezależną drugą drogę dla operatorów, którzy go oferują. Czego nie daje żaden z nich, to ocena, czemu żądanie służy. Oba ustalają, kto pyta. O tym, co dzieje się z odpowiedzią, nie mówi żaden z dwóch dowodów.
Pytania i odpowiedzi
Czy nie wystarczy sprawdzić nagłówka User-Agent?
Nie. User-Agent ustawia każdy klient sam; to twierdzenie, które ma zostać sprawdzone, a nie jego dowód. Przydaje się do wyboru właściwej kontroli: ruch podający się za Applebota jest sprawdzany na podstawie zakresów albo nazw hostów Apple.
Co się zmienia, gdy przed serwerem stoi CDN albo odwrotne proxy?
Adres widziany przez serwer należy wtedy do usługi pośredniczącej. Zakończone uzgodnienie TCP dowodzi już tylko tego, że żądanie przyszło z CDN; adres robota znajduje się w nagłówku takim jak X-Forwarded-For, który usługa dopisuje. Obie kontrole, czy to przez listę zakresów, czy przez rozwiązanie wsteczne i w przód, muszą wychodzić od tego adresu, inaczej sprawdzają CDN.
Niepodrabialność staje się przez to warunkiem: nagłówek jest dokładnie tak wiarygodny jak jego nadawca. Klient, który dociera do serwera bezpośrednio, może wpisać do X-Forwarded-For dowolny adres z zakresów Apple i przejdzie wtedy każdą kontrolę adresu. Nagłówek wolno więc brać pod uwagę tylko wtedy, gdy samo połączenie pochodzi z opublikowanych zakresów CDN, a przy kilku wpisach liczy się ostatni, dopisany przez sam CDN, a nie pierwszy.
Wiele sieci CDN samo przeprowadza weryfikację robotów i udostępnia jej wynik w swoich regułach. To wygodne, ale przenosi jedynie na dostawcę pytanie, czy powiększona pula jest już rozpoznawana.
Czy ważne podpisane żądanie może zostać wysłane ponownie przez kogoś trzeciego?
Co do zasady tak, na przykład gdy operator innej witryny przekazuje skierowane do niego podpisane żądanie dalej, do cudzej witryny. Podpis dowodzi, kto podpisał wiadomość, a nie kto ją właśnie wysyła. RFC 9421 przewiduje dlatego parametry ograniczające powtórzenie: created i expires dla okresu ważności podpisu oraz nonce dla wartości przyjmowanej tylko raz. Da się też ustalić, które części żądania są podpisane, na przykład host docelowy przez komponent @authority; podpis złożony dla innej domeny nie przechodzi wtedy kontroli.
Ile z tego witryna wymaga, rozstrzyga ona sama przy weryfikacji. Krótka ważność utrzymuje okno małe, a przechowywana lista już widzianych wartości nonce je zamyka, ale kosztuje pamięć, przy kilku serwerach zaś wymaga wspólnego magazynu.
Dlaczego ruch robotów pojawia się w jednych statystykach, a w innych nie?
Bo narzędzia liczą w różnych miejscach. Logi serwera zapisują każde żądanie, narzędzie oparte na JavaScripcie tylko wizyty, w których skrypt się wykonuje i wysyła swoje trafienie. Wiele robotów pobiera wyłącznie HTML i nigdy się tam nie pojawia; inne renderują strony razem z JavaScriptem i mogą wtedy tworzyć sesje.
Do tego dochodzi wbudowane filtrowanie. GA4 automatycznie wyklucza ruch znanych botów i pająków; nie da się tego wyłączyć, a GA4 nie pokazuje, ile wykluczono. Co nie figuruje na tej liście, liczy się jako zwykła wizyta. Liczenie po stronie serwera bez weryfikacji i tak obejmuje wszystko.
Dla cichego rodzaju usterki oznacza to, że najpierw dotyka ona własnych liczników po stronie serwera i analiz logów, które odejmują zweryfikowane roboty, a całą resztę traktują jako ruch ludzki. Nieaktualna lista zakresów sprawia tam, że każdy nowy prefiks Applebota wygląda jak człowiek. Nagły wzrost rzekomo ludzkich żądań z nowych prefiksów jest więc pierwszym powodem, by podejrzewać zapisaną listę.
Kontrola praktyczna: analiza grup ruchu GA4
Narzędzie kontroli ruchu GA4 grupuje raportowane dane według przeglądarki, systemu, kraju oraz źródła/medium sesji. Zamiast prawdopodobieństwa botów pokazuje konkretne wskazówki: brak sesji z zaangażowaniem, zerowy średni czas, brakujące wymiary lub termin automatyzacji w nazwie przeglądarki. Zmienny próg minimalny wyłącza małe grupy z tych reguł, ale ich wiersze pozostają widoczne.
Te obserwacje nie potwierdzają tożsamości robota. Kampanie, zachowanie związane ze zgodą, niepełny pomiar lub testy wewnętrzne mogą tworzyć podobne wzorce. Kraj i ruch Direct nie dowodzą automatyzacji. Eksport CSV wspiera porównanie z logami serwera lub CDN; raport nie zawiera jednak adresów IP klientów ani zweryfikowanych podpisów. Dane nie są wykluczane ani zmieniane.
Google automatycznie wyklucza znane boty i nie ujawnia ich wykluczonej liczby w GA4. Brak pasujących reguł oznacza więc tylko brak wskazań wybranych kontroli w zwróconych wierszach. Źródła: wykluczanie znanych botów przez Google i schemat Data API.
Powiązane artykuły