

 English
 Deutsch
 Polski
Ewolucja analityki internetowej: Od plików logów po przyszłość Server-Side Tracking
Część 1 z 5 serii Od piksela do serwera: śledzenie, które wytrzyma

Management Summary
Analityka internetowa rejestruje korzystanie z witryn, aby oceniać treści, usługi i reklamę. Obok dawnych zapisów żądań serwera pojawiły się pomiary działań w przeglądarce oraz dane systemów biznesowych, na przykład potwierdzone zamówienia. Artykuł wyjaśnia, dlaczego metody współistnieją: każda widzi inną część wizyty. Rozróżnienie ułatwia interpretację raportów i wybór źródeł danych. Przeniesienie pomiaru na serwer nie odtwarza automatycznie brakujących działań ani nie usuwa wymagań prywatności.
Spis treści
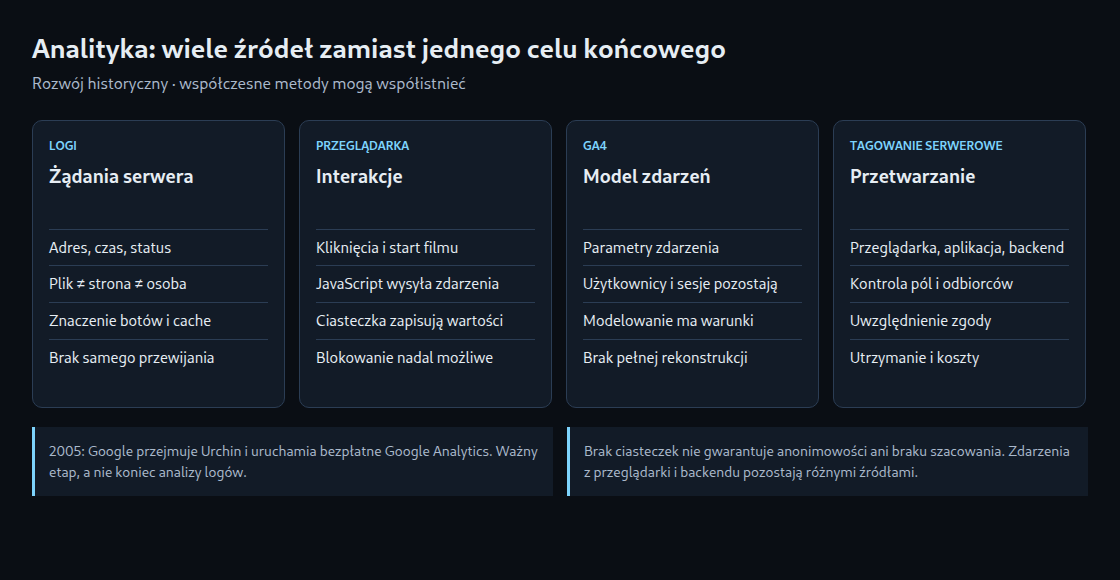
Analityka internetowa korzysta z kilku źródeł: żądań w logach serwera, zdarzeń z przeglądarki i operacji biznesowych w systemach backendowych, takich jak zamówienia zapisane na serwerze sklepu. Nowe metody uzupełniały wcześniejsze rozwiązania, zamiast całkowicie zastępować starsze techniki. Śledzenie po stronie serwera często uzupełnia pomiar w przeglądarce; nie oznacza prostego powrotu do analizy logów.
Logi: liczenie żądań i interpretacja ruchu
Logi serwera stanowiły ważną podstawę wczesnych statystyk internetowych i nadal służą utrzymaniu usług oraz diagnozowaniu błędów. Log dostępu może zawierać czas, żądany adres, status odpowiedzi i adres IP. Konfiguracja określa zakres zapisywanych żądań oraz pól.
Żądanie nie oznacza osoby ani koniecznie odsłony. Jedna strona często pobiera wiele plików, a boty również wysyłają żądania. Pamięć podręczna przeglądarki lub warstwa cache przed serwerem źródłowym może obsłużyć treść bez kontaktu z tym serwerem. Samo przewinięcie strony bez dodatkowego żądania nie pojawia się w jego logu. Analiza wymaga więc odpowiednich filtrów i jasnych definicji wskaźników.
Urchin przekształcał dane internetowe w raporty. Google przejęło firmę w 2005 roku, a 14 listopada 2005 roku udostępniło Google Analytics bez opłat. Ułatwiło to wielu witrynom dostęp do analityki jako usługi.
Pomiar w przeglądarce: dodatkowe zdarzenia
JavaScript może wykrywać interakcje, takie jak rozpoczęcie odtwarzania filmu czy kliknięcie, i wysyłać zdarzenia. Piksel śledzący oznacza zależnie od kontekstu żądanie obrazu albo szerzej żądanie pomiarowe. Ciasteczka przechowują wartości; nie są wykonywalnym kodem.
Google Analytics wykorzystuje głównie ciasteczka własne, czyli first-party, zapisywane w domenie danej witryny. Połączenie z zewnętrznym serwerem analitycznym nie oznacza zatem automatycznie użycia ciasteczka podmiotu trzeciego. Universal Analytics raportowało odsłony, zdarzenia, użytkowników i sesje. Wycofana już generacja produktu stanowi tutaj kontekst historyczny.
Różni dostawcy i modele utrzymania
Historia analityki nie ogranicza się do produktów Google. Adobe przejęło Omniture w 2009 roku. Webtrekk dołączył do Mapp w 2019 roku. Matomo do 2018 roku nosiło nazwę Piwik i oferuje między innymi instalację na własnej infrastrukturze organizacji. Do narzędzi analityki internetowej należy również etracker.
Przy wyborze liczą się konkretne funkcje, przepływy danych, umowy, lokalizacje przechowywania i koszty utrzymania. Europejski dostawca, otwarty kod lub własny hosting nie potwierdzają samodzielnie zgodności konfiguracji z prawem. Znaczenie ma aktualna konfiguracja i rzeczywiste przetwarzanie danych.
Ochrona w przeglądarkach i model zdarzeń GA4
Intelligent Tracking Prevention w Safari oraz Enhanced Tracking Protection w Firefoksie ograniczają określone techniki śledzenia. Zależnie od przeglądarki, kontekstu i ustawień ochrona może blokować dostęp lub rozdzielać obszary przechowywania danych. Nie oznacza to ogólnego zakazu wszystkich ciasteczek.
GA4 organizuje zbieranie danych wokół zdarzeń i dodatkowych parametrów. Wskaźniki użytkowników oraz sesji pozostają częścią raportowania. Modelowanie może w określonych warunkach statystycznie uzupełniać brakujące informacje: na podstawie zaobserwowanych wzorców szacowane są wartości, których nie zmierzono bezpośrednio. Nie gwarantuje odtworzenia każdego utraconego zdarzenia; nawet wystarczająca ilość danych nie zapewnia zakwalifikowania usługi do modelowania.
Tagowanie po stronie serwera: dodatkowy etap przetwarzania
Tagowanie serwerowe odbiera dane pomiarowe pod kontrolowanym adresem odbiorczym, nazywanym punktem końcowym, a następnie przetwarza lub przekazuje zdarzenia. Źródłem może być przeglądarka, aplikacja albo system backendowy. Google Tag Manager zaleca własną domenę first-party w środowisku produkcyjnym. Wspólna domena główna nie stanowi jednak ogólnej definicji komunikacji serwer-serwer.
Korzyścią jest przepływ danych możliwy do sprawdzenia: jakie pola trafiają do poszczególnych odbiorców, które zdarzenia są odrzucane i jaka zgoda obowiązuje? Poprawna konfiguracja może ograniczyć pracę przeglądarki. Dodatkowa infrastruktura oznacza jednak koszty oraz konieczność monitorowania, kontroli dostępu i utrzymania.
Serwer nie wykryje samego przewijania bez sygnału z przeglądarki. Potwierdzone zamówienie może natomiast pochodzić bezpośrednio z systemu zamówień. Równoległe przesyłanie z przeglądarki i backendu wymaga odpowiedniej deduplikacji. Na przykład to samo zamówienie przesłane obiema drogami powinno zostać policzone jako jeden zakup, a nie dwa. Droga serwerowa nie udostępnia automatycznie danych zablokowanych, niezebranych lub niedopuszczalnych.
Udział brakujących zdarzeń wymaga zbadania konkretnej witryny. Różne źródła rejestrują różne części wizyty, dlatego rozbieżność nie oznacza automatycznie błędu pomiaru. Przydatna architektura łączy odpowiednie źródła i dokumentuje ograniczenia.
Pytania i odpowiedzi
Czy pomiar bez ciasteczek wyklucza modelowanie?
Nie. „Cookieless” opisuje przede wszystkim brak ciasteczek w określonej ścieżce zbierania danych. Nie określa innych identyfikatorów, sposobu tworzenia sesji ani późniejszego szacowania statystycznego. Nawet grupowanie żądań według krótkotrwałych cech może być niedokładne. Zliczone zdarzenie i wywnioskowana liczba osób to różne informacje.
Zbieranie danych bez ciasteczek i modelowanie mogą współistnieć. W GA4 trzeba rozróżniać wartości obserwowane oraz modelowane. Brak trwałego identyfikatora ogranicza rozpoznawanie powrotów; dostępność wskaźników powracających użytkowników zależy od innych dozwolonych sygnałów i zastosowanej metody.
Czy własny serwer zastępuje ocenę prywatności?
Nie. Techniki bez ciasteczek mogą nadal przetwarzać dane osobowe lub podlegać zasadom dostępu do urządzeń końcowych. Cel, podstawa prawna, ewentualna zgoda i wyjątki wymagają oceny rzeczywistej metody. Haszowanie, domena first-party i własny serwer nie gwarantują samodzielnie anonimowości.
Źródła
- Apache: logi dostępu
- Google: przejęcie Urchin w 2005 roku
- Uruchomienie Google Analytics 14 listopada 2005 roku
- Google Analytics: ciasteczka i identyfikatory
- Google Analytics: porównanie wskaźników UA i GA4
- Universal Analytics: dokumentacja wycofanego produktu
- Raport roczny Adobe 2009: Omniture
- Mapp: przejęcie Webtrekk w 2019 roku
- Matomo: zmiana nazwy Piwik w 2018 roku
- etracker Analytics
- WebKit: ochrona przed śledzeniem
- Firefox: Enhanced Tracking Protection
- GA4: modelowanie zachowań
- Tagowanie serwerowe: wprowadzenie
- Tagowanie serwerowe: własna domena
- Tagowanie serwerowe: przegląd
- Wytyczne EROD 2/2023, wersja 2.0
Od piksela do serwera: śledzenie, które wytrzyma
- Ewolucja analityki internetowej: Od plików logów po przyszłość Server-Side Tracking
- GA4 i Server-Side GTM: Wyjaśnienie funkcji „Migrate from JavaScript Managed Client ID” w GA4
- Server-Side GTM na GCP Cloud Run: Architektura, Auto-Scaling i optymalizacja kosztów
- GA4 Measurement Protocol: Serwerowa integracja konwersji offline z CRM
- Meta Conversions API: Maksymalizacja Event Match Quality (EMQ) i deduplikacja
Powiązane artykuły


