English
 Deutsch
 Polski
Data Blending w Looker Studio: joiny, metryki i pułapki pomiędzy

Spis treści
Data Blending to funkcja Looker Studio, dawniej Data Studio, która łączy kilka źródeł danych w jednym wykresie. Jest zarazem funkcją generującą najbardziej pewne siebie błędne liczby, ponieważ blend zawodzi po cichu: raport się renderuje, sumy wyglądają wiarygodnie, a nic nie wskazuje, że jakaś wartość została policzona trzykrotnie albo że dwie zdeduplikowane liczby dodano do siebie tak, jakby były ilościami.
Powód jest taki, że blend nie zachowuje się jak wyszukiwanie w arkuszu. Kolejność jego operacji tłumaczy niemal każdy dziwny wynik — i od niej zaczyna się ten tekst.
Co blend faktycznie robi
Blend wykonuje dwie operacje, w tej kolejności: każda tabela jest najpierw agregowana po własnych wymiarach, a zagregowane wyniki są dopiero potem łączone po skonfigurowanym kluczu. Obie połowy tego zdania mają znaczenie. Agregacja następuje przed złączeniem, więc wymiary wybrane dla tabeli decydują, ile wierszy ta tabela wnosi do złączenia — a złączenie dopasowuje te wiersze do drugiej tabeli, wiersz po wierszu.
Dlatego blend nie jest wyszukiwaniem i dlatego dobór wymiarów nie jest kwestią kosmetyczną. Dodanie wymiaru do tabeli nie dokłada po prostu kolumny; zmienia liczbę wierszy, jakie ta tabela wnosi, a więc i wynik złączenia.
Pięć typów złączeń
Looker Studio oferuje standardowy zestaw, a wybór rozstrzyga, które wiersze przetrwają, gdy klucz istnieje tylko po jednej stronie:
- Left outer — każdy wiersz lewej tabeli plus pasujące wiersze prawej. Niedopasowane wiersze z prawej odpadają. Ustawienie domyślne i powód, dla którego dzień, w którym aktywność miało tylko drugie źródło, potrafi zniknąć z raportu.
- Right outer — odbicie lustrzane; rzadko najczytelniejszy sposób wyrażenia intencji, bo przestawienie tabel i użycie left join zwykle czyta się lepiej.
- Inner — wyłącznie klucze obecne w obu tabelach. Przydatne, gdy wiersz ma sens tylko wtedy, gdy oba źródła mają dane, i niebezpieczne, gdy w rzeczywistości tak nie jest.
- Full outer — wszystkie wiersze z obu stron, dopasowane tam, gdzie się da. Najbezpieczniejszy wybór, gdy kompletność liczy się bardziej niż zwięzłość, kosztem wierszy pełnych wartości pustych, które muszą obsłużyć pola obliczeniowe.
- Cross — każdy wiersz połączony z każdym. Uzasadnione przy budowie rusztowania, na przykład listy dat z listą kanałów, i katastrofalne, gdy wybrane przypadkiem.
Reguła praktyczna: jeśli pytanie brzmi „jak te dwie rzeczy rozwijały się w tym samym okresie”, full outer po dacie chroni przed cicho gubionymi dniami. Jeśli pytanie brzmi „co stało się z rekordami istniejącymi w obu systemach”, uczciwym wyborem jest inner — a liczba wierszy, które przy tym odpadają, sama zasługuje na zaraportowanie.
Gdzie klucze złączenia pękają bez ostrzeżenia
Klucz złączenia musi zgadzać się dokładnie, a większość niepowodzeń bierze się z wartości wyglądających dla człowieka identycznie, a dla maszyny nie.
Najczęstszy przypadek to poziom szczegółowości daty: jedno źródło podające znacznik czasu i drugie podające datę nigdy się nie dopasują, a rozwiązaniem jest udostępnienie czystego pola daty w każdym źródle, a nie liczenie na to, że blend to pogodzi. Dalej idzie wielkość liter i białe znaki — Newsletter, newsletter i newsletter to trzy różne klucze. Normalizacja przez LOWER() i TRIM() należy do źródła danych jako pole obliczeniowe, bo pole utworzone tam jest dostępne jako klucz złączenia — edytor blendu nie jest miejscem na naprawianie danych wejściowych. Formatowanie walut i ustawienia regionalne powodują tę samą klasę awarii przy kluczach liczbowych i identyfikatorach.
Jeszcze jedno ograniczenie ma charakter strukturalny: klucze o bardzo wysokiej kardynalności, jak identyfikator transakcji, spowalniają blendy — a blend, który przekroczy limit czasu, to pusty wykres, a nie komunikat o błędzie.
Wymiary decydują, co znaczy jeden wiersz
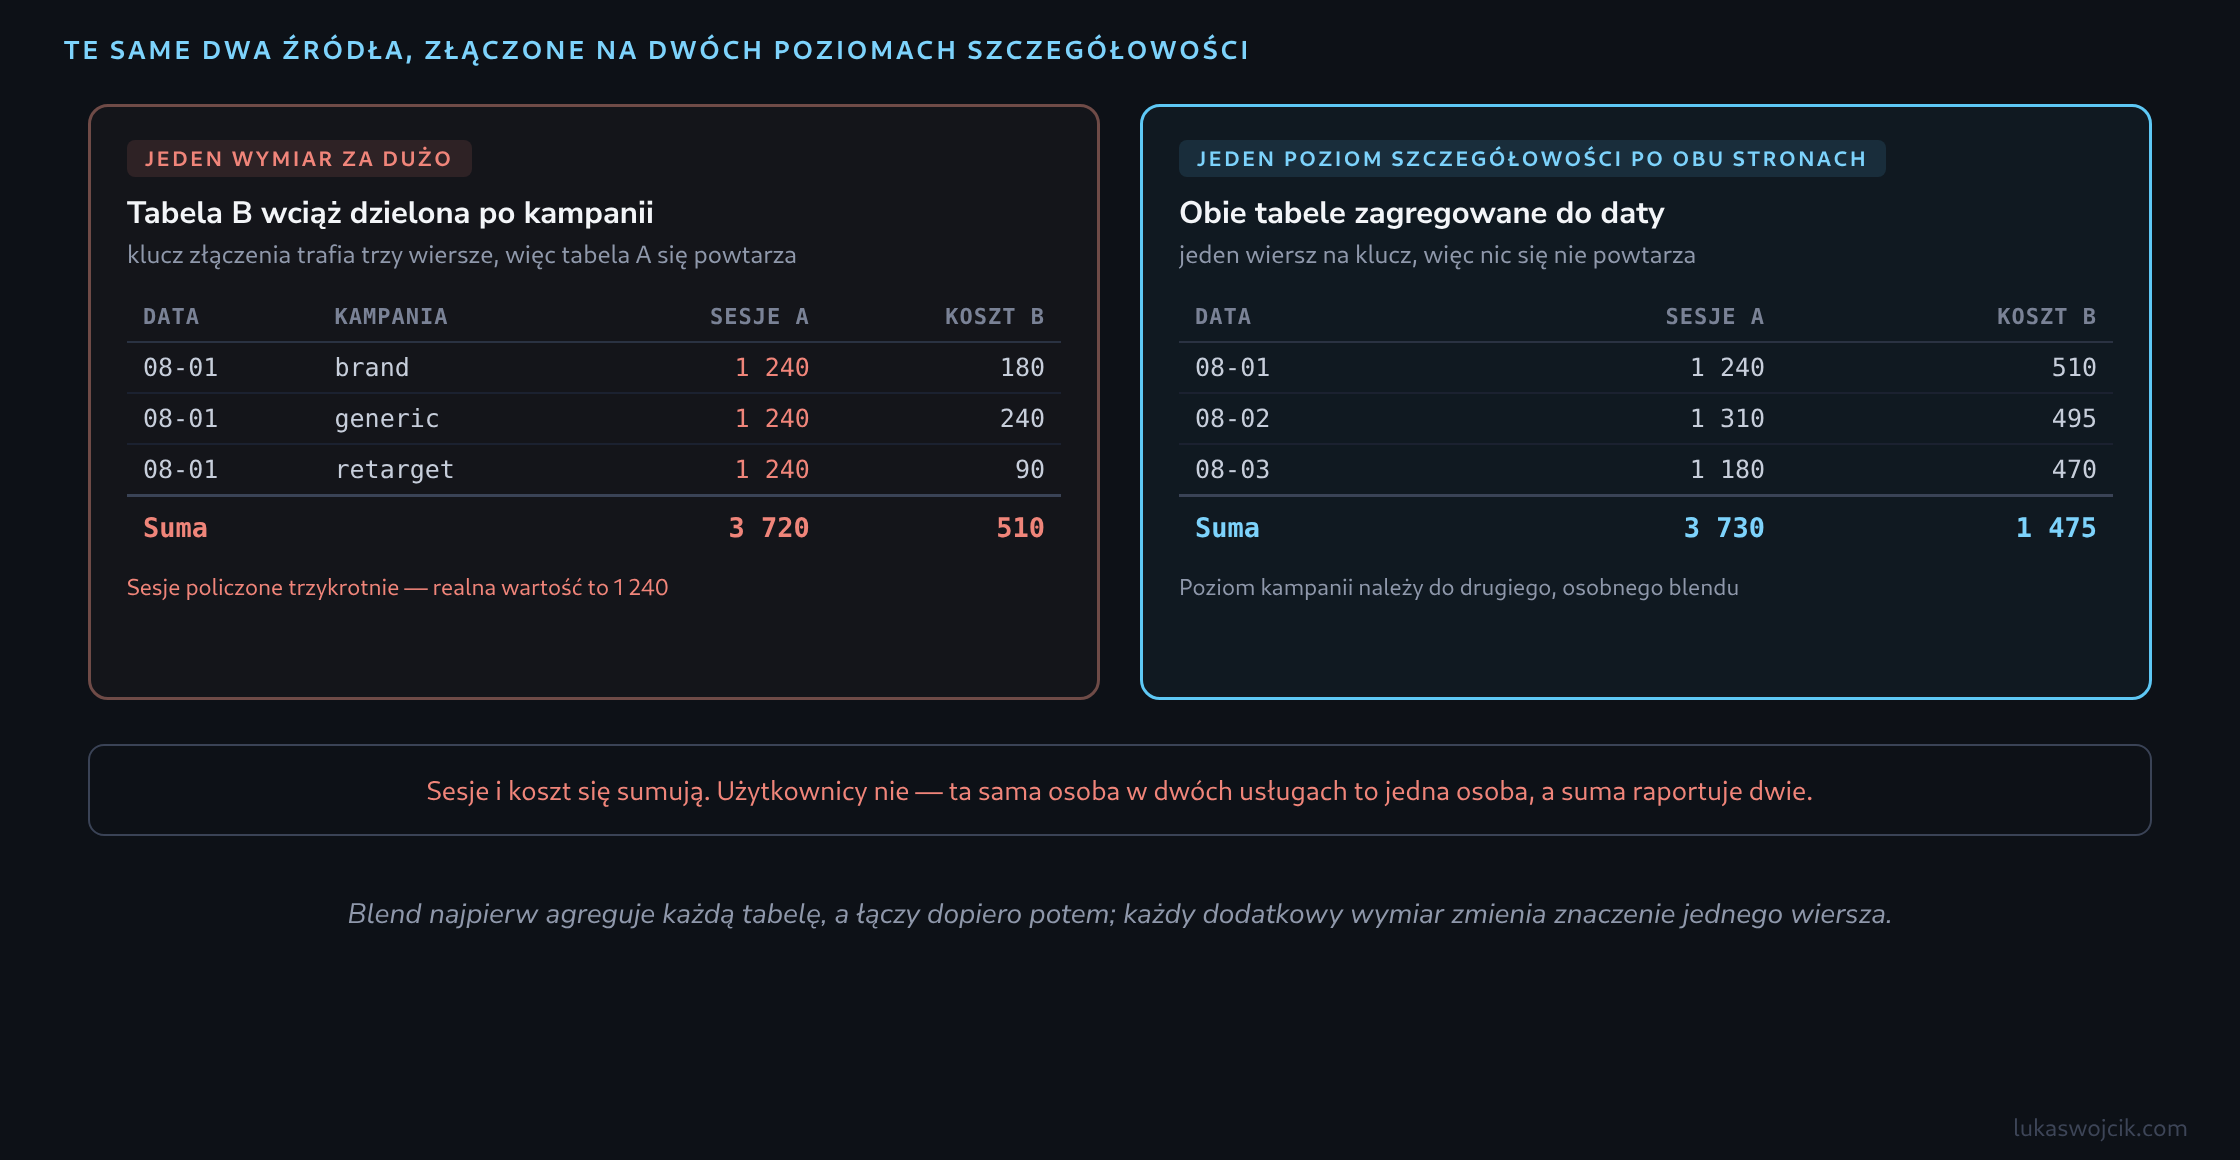
Najkosztowniejszym pojedynczym błędem jest pozostawienie w jednej tabeli wymiaru, którego druga nie ma. Jeśli tabela A jest zagregowana po dacie, a tabela B po dacie i kampanii, klucz złączenia po dacie dopasuje jeden wiersz z A do trzech wierszy z B, a metryka z A powtórzy się trzykrotnie. Suma jest wtedy dokładnie trzy razy za duża — i nadal jest okrągłą, wiarygodnie wyglądającą liczbą.
Zapobiegają temu dwa nawyki. Pierwszy: ustalić poziom szczegółowości blendu przed wyborem jakiegokolwiek pola i zagregować każdą tabelę dokładnie do tego poziomu — jeśli blend jest na poziomie daty, żadna tabela nie niesie kampanii. Drugi to diagnostyka: dodanie Record Count z każdej tabeli do tymczasowego widoku tabelarycznego natychmiast pokazuje, czy klucz trafia więcej wierszy, niż powinien, bo czyste złączenie jeden-do-jednego zwraca record count równy jeden na wiersz i tabelę.
Gdy poziom kampanii jest naprawdę potrzebny, należy do drugiego blendu zbudowanego na tym poziomie, a nie do tego samego. Pojedynczy blend obsługujący dwa poziomy szczegółowości to żądanie, którego nie da się spełnić.
Nazwy metryk i sumy między usługami
Łączenie tej samej metryki z kilku usług — na przykład łącznej liczby użytkowników z trzech regionalnych usług GA4 — trafia na zachowanie, które łatwo wziąć za błąd rachunkowy.
Każda tabela w blendzie zachowuje nazwy pól ze swojego źródła. Gdy trzy tabele wnoszą po polu o nazwie Total users, do blendu trafiają trzy pola o tej samej nazwie, a pole obliczeniowe zapisane jako dodawanie tej nazwy nie ma jednoznacznego sposobu, by związać się z właściwym. Wychodzi z tego liczba powstająca bez komunikatu o błędzie i niebędąca zamierzoną sumą.
Rozwiązaniem jest zmiana nazwy każdej metryki w edytorze blendu, zanim powstanie jakiekolwiek pole obliczeniowe. Wyraźne, rozróżnialne nazwy — users_de, users_at, users_ch — czynią odwołanie jednoznacznym, a dodawanie zaczyna zachowywać się zgodnie z oczekiwaniem:
-- Wiarygodne dopiero, gdy kazda metryka zrodlowa ma unikalna nazwe
users_de + users_at + users_ch
Przy tej samej okazji warto sprawdzić agregację ustawioną dla każdej metryki w blendzie. Pole z agregacją automatyczną może zachować się inaczej niż takie, które ma jawnie ustawione SUM — a ponieważ oba renderują się bez zastrzeżeń, lepiej wybrać ustawienie jawne.
Metryki, których nie wolno sumować w ogóle
Zmiana nazw sprawia, że dodawanie działa mechanicznie. Czy dodawanie cokolwiek znaczy, to osobne pytanie — a dla dwóch kategorii metryk odpowiedź brzmi: nie.
Zliczenia zdeduplikowane — użytkownicy, użytkownicy aktywni, każde zliczenie unikalnych — nie są addytywne. Osoba odwiedzająca dwie z trzech usług to jedna osoba; dodanie trzech liczb raportuje dwie. To samo dotyczy czasu: zsumowanie dziennych użytkowników w miesiącu nie daje użytkowników miesięcznych. Żadna konfiguracja blendu tego nie naprawi, bo informacji potrzebnej do deduplikacji w zagregowanych wartościach już nie ma. Gdy potrzebna jest rzetelna liczba użytkowników w skali kilku usług, deduplikacja musi nastąpić przed Looker Studio — w praktyce na danych surowych w hurtowni.
Wskaźniki i średnie — CTR, współczynnik konwersji, współczynnik odrzuceń, średnia wartość zamówienia — trzeba przeliczyć po blendzie, a nie łączyć. Średnia dwóch współczynników konwersji nie jest współczynnikiem konwersji danych połączonych, chyba że obie strony mają przypadkiem identyczne mianowniki. Poprawna forma sumuje składniki i dzieli na końcu:
-- Zle: usrednianie dwoch wskaznikow
(conv_rate_a + conv_rate_b) / 2

-- Dobrze: przeliczenie z zsumowanych skladnikow
(conversions_a + conversions_b) / (sessions_a + sessions_b)
Dalsze techniki warte poznania
- Tabela kalendarzowa jako kotwica. Zblendowanie obu źródeł z małą tabelą zawierającą każdą datę zakresu, z left joinami wychodzącymi od niej, gwarantuje, że żaden dzień nie zniknie dlatego, że jedno źródło nie miało aktywności.
- Trzymać blendy wąsko. Blend odpytuje swoje źródła ponownie, więc każde nieużywane pole kosztuje czas ładowania. Wybranie tylko pól potrzebnych wykresowi to decyzja wydajnościowa w takim samym stopniu jak porządkowa.
- Kolejność tabel nie jest kosmetyczna. Pierwsza tabela jest lewą stroną każdego left joina — a więc tabelą, której kompletność dziedziczy raport.
- Limit pięciu tabel to warunek projektowy, który lepiej zaplanować, niż odkryć: blend wymagający większej liczby wejść zwykle sygnalizuje, że łączenie należy do hurtowni.
- Obsługa wartości pustych. Złączenia zewnętrzne generują wartości puste, a działanie arytmetyczne z wartością pustą daje wartość pustą zamiast drugiego składnika. Opakowanie składników przed dodaniem —
IFNULL(metryka, 0)— zapobiega znikaniu wierszy z sumy bez widocznego powodu. - Nie każde pole przetrwa blend. Pola obliczeniowe oparte w źródle na agregacji nieaddytywnej nie zawsze są dostępne w blendzie, co bywa sygnałem, by przenieść obliczenie w górę, do źródła danych.
Podsumowanie
Data Blending jest niezawodny, gdy potraktuje się poważnie jego kolejność operacji: najpierw agregacja, potem złączenie. Niemal każdy niewiarygodny wynik sprowadza się do jednej z czterech przyczyn. Wymiar pozostawiony w jednej tabeli zwielokrotnił wiersze. Klucz złączenia nie trafił z powodu typu lub formatowania. Nazwa metryki była niejednoznaczna między tabelami. Albo metryka od początku nie była addytywna.
Odpowiadająca temu dyscyplina jest krótka. Ustalić poziom szczegółowości przed wyborem pól i zagregować do niego każdą tabelę. Wybrać typ złączenia świadomie, zamiast przyjmować ustawienie domyślne. Zmienić nazwę każdej metryki w blendzie na unikalną, zanim powstanie pole obliczeniowe, i ustawić jej agregację jawnie. Przeliczać wskaźniki z zsumowanych składników zamiast je uśredniać, a zliczenia zdeduplikowane traktować jako coś, czego blend nie potrafi dostarczyć. I zanim zblendowana liczba trafi na prezentację — zestawić ją z tą samą liczbą w jej własnym źródle: blend zgodny ze swoimi wejściami jest godny zaufania, a taki, który zgodny nie jest, ma konkretną i możliwą do znalezienia przyczynę.
Co mówią dwie sumy
Porównanie ze źródłem zajmuje minutę, a już kierunek różnicy wskazuje przyczynę. Ta sama metryka trafia raz do karty wyniku na własnym źródle danych i raz do drugiej karty wyniku na blendzie:
- Suma w blendzie jest większa. Złączenie pomnożyło wiersze. Iloraz obu sum to liczba wierszy na klucz po drugiej stronie, na przykład trzydzieści, gdy jedna tabela jest na poziomie kampanii, a druga na poziomie kampanii i dnia w okresie trzydziestu dni.
- Suma w blendzie jest mniejsza. Wiersze bez pary odpadły, zwykle przez złączenie inner albo dlatego, że tabela z metryką nie jest lewą tabelą w left join.
- Obie sumy są równe. Dla tej metryki blend robi to, na co wygląda.
Wskaźniki potrafią ukryć zwielokrotnienie
Wskaźnik nie jest wiarygodnym alarmem. Jeśli licznik i mianownik pochodzą z tej samej tabeli, oba mnożą się przez ten sam czynnik, a wskaźnik pozostaje dokładnie poprawny: transakcje na sesję wyglądają zdrowo, choć każda sesja została policzona trzydzieści razy. Wskaźnik łączący obie strony zdradza natomiast błąd. Kampania z 1000 sesji i 300 € kosztów w ciągu 30 dni, złączona wyłącznie po kampanii z dziennymi wierszami kosztów, pokazuje 30 000 sesji obok niezmienionych kosztów, a koszt na sesję spada z 0,30 € do 0,01 €. Taka wartość bywa odczytywana raczej jako wyjątkowo tania kampania niż jako błąd rachunkowy.
Warunek złączenia może obejmować kilka pól
Gdy właściwym rozwiązaniem jest złączenie na poziomie kampanii i dnia, pomocnicze pole ze sklejonych wartości nie jest potrzebne. Warunek złączenia w Looker Studio może składać się z jednego lub kilku pól, a pola nie muszą mieć tej samej nazwy, o ile zawierają te same dane. Data i kampania trafiają wtedy razem do warunku, a obie strony stoją na tym samym poziomie szczegółowości. Dla metryk nieaddytywnych, takich jak użytkownicy, nadal obowiązuje sekcja o metrykach, których nie wolno sumować: w ich przypadku właściwym rozwiązaniem jest zagregowanie strony kosztów do kampanii.
Pytania i odpowiedzi
Co zrobić, gdy raport w Looker Studio potrzebuje szóstego źródła, skoro blend obejmuje najwyżej pięć tabel?
Blendu nie da się połączyć z kolejnym blendem, a potrzeba szóstego źródła to właśnie sygnał, o którym mowa w artykule: łączenie należy zwykle przenieść o poziom niżej, do hurtowni. Tam limit pięciu tabel nie obowiązuje, a wynik jest jedną tabelą, którą Looker Studio czyta bez żadnego blendu.
Zanim jednak dojdzie do przebudowy, warto policzyć, ile z tych sześciu źródeł faktycznie musi być w jednym wykresie. Bardzo często raport składa się z kilku wykresów, z których każdy potrzebuje dwóch albo trzech źródeł, i wtedy dwa osobne blendy rozwiązują problem bez żadnej infrastruktury.
I jedna rzecz do rachunku: tabela kalendarza zajmuje jedno z pięciu miejsc. Przy planowaniu blendu z kotwicą realnie zostają cztery źródła danych, co przy czterech systemach reklamowych wystarcza dokładnie do momentu, w którym ktoś poprosi o dołożenie piątego.
Powiązane artykuły