English
 Deutsch
 Polski
Tutorial: Dashboard widoczności SEO i GEO na bazie Google Search Console API

Spis treści
Interfejs Search Console odpowiada na jedno zapytanie naraz. Pokazuje górne wiersze, eksportuje ich tysiąc i nie daje sposobu, by zapytać, czy widoczność dla całego tematu rośnie, podczas gdy wyszukiwania markowe jedynie utrzymują poziom. To pytanie wymaga pogrupowanych zapytań, a grupowanie wymaga zarówno większej liczby wierszy, niż wydaje interfejs, jak i miejsca, w którym da się te grupy zdefiniować.
Poniższy przewodnik buduje dokładnie to: pobranie danych przez Search Console API, kategoryzację zapytań wyrażeniami regularnymi w Looker Studio i odczyt powstałych klastrów — wraz z uczciwym opisem tego, czego te dane nie pokażą o odpowiedziach generowanych wprost na stronie wyników.
Co daje API, a czego nie daje interfejs
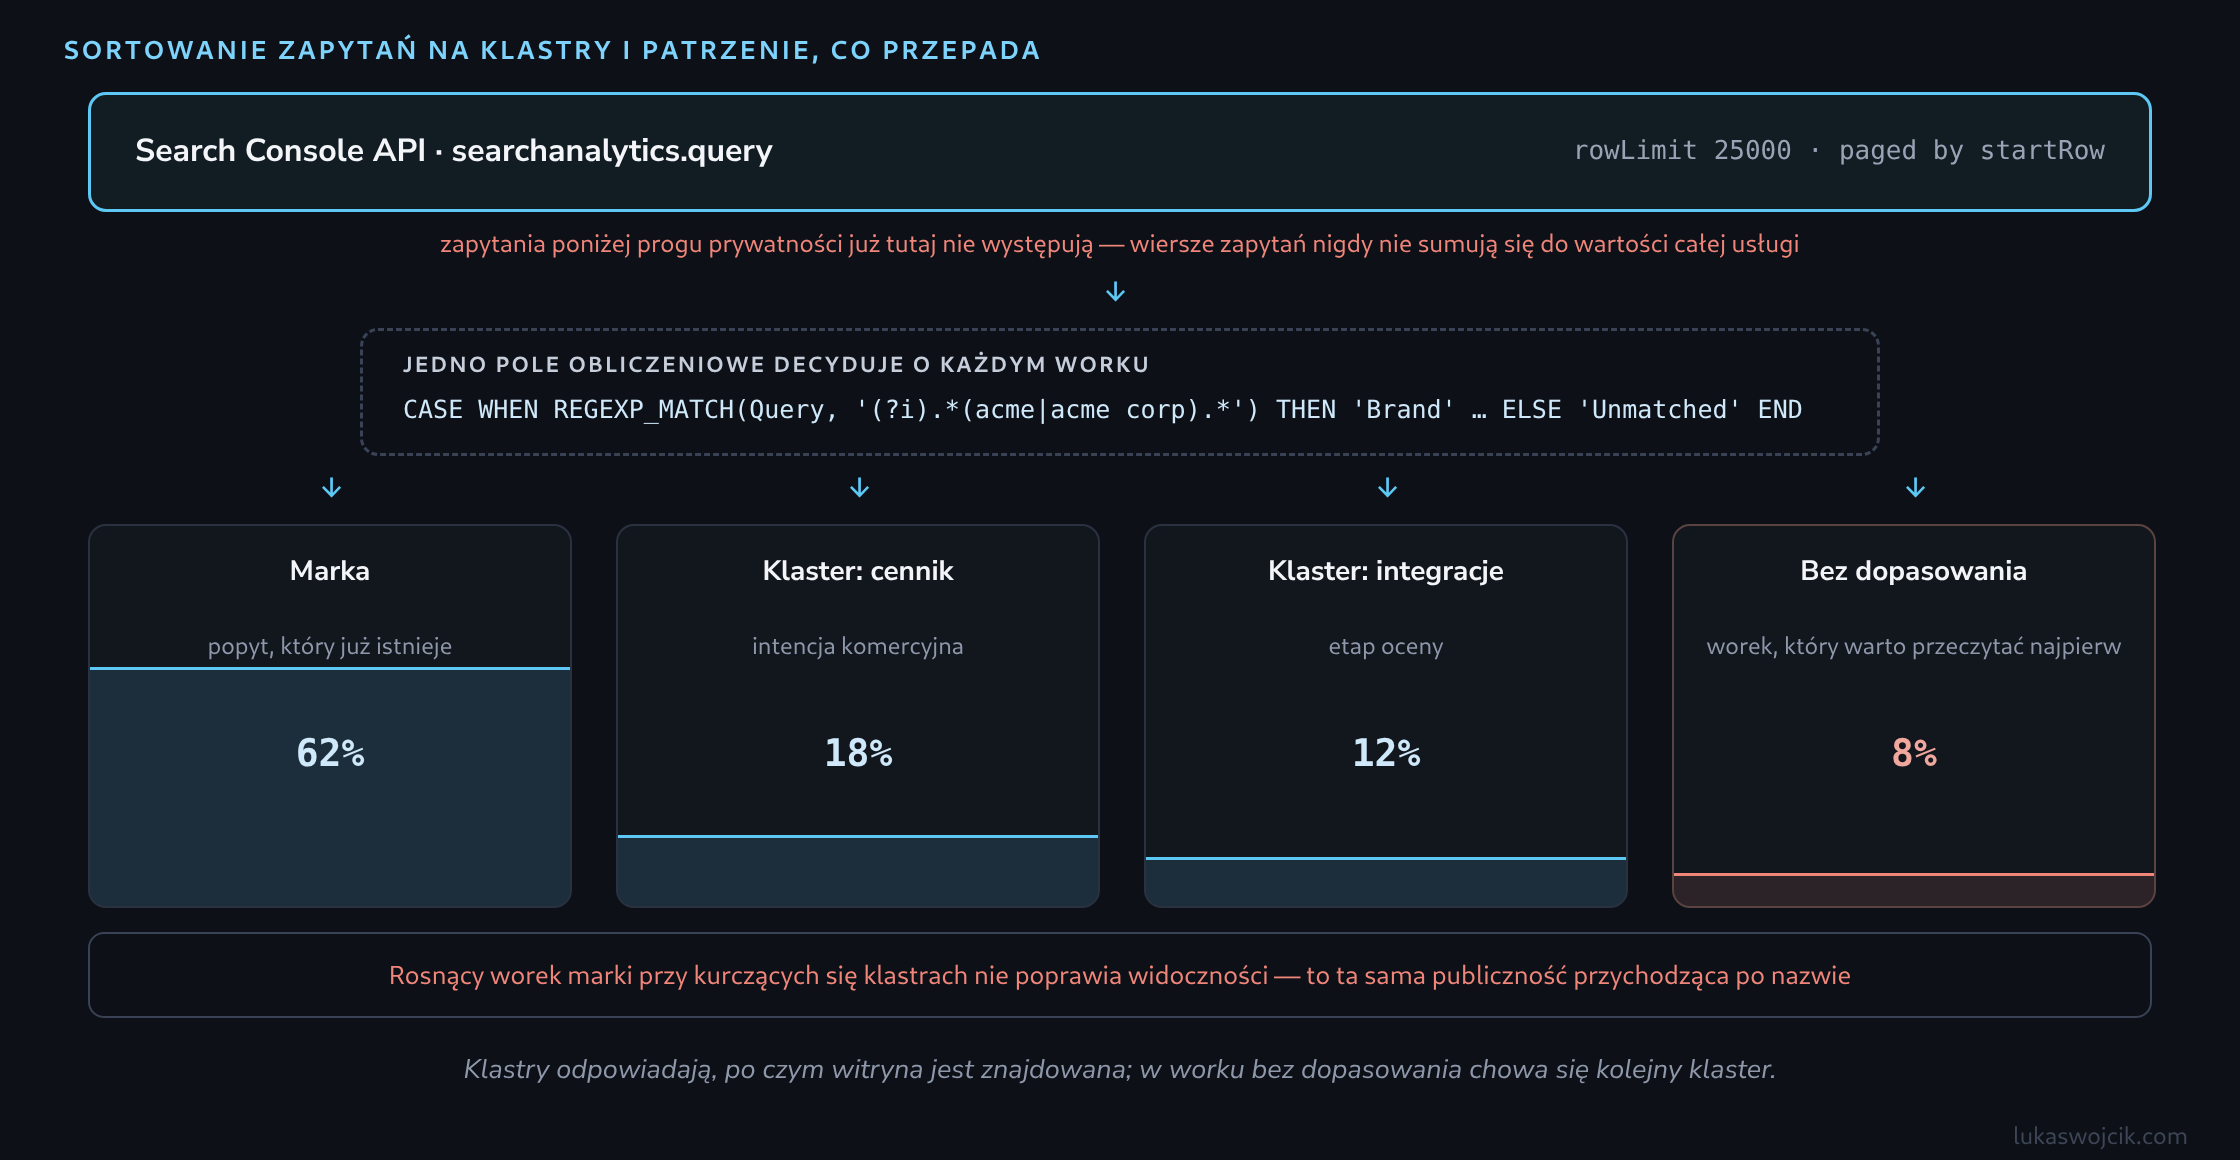
Raport skuteczności eksportuje do tysiąca wierszy. Metoda searchanalytics.query z API zwraca do 25 000 na żądanie i przechodzi przez resztę za pomocą startRow — to różnica między widzeniem czoła rozkładu a widzeniem długiego ogona, w którym nowe tematy pojawiają się najpierw.
POST https://searchconsole.googleapis.com/webmasters/v3/sites/
     https%3A%2F%2Fexample.com%2F/searchAnalytics/query

{
  "startDate": "2026-07-01",
  "endDate": "2026-07-31",
  "dimensions": ["query"],
  "rowLimit": 25000,
  "startRow": 0,
  "dimensionFilterGroups": [{
    "filters": [{
      "dimension": "query",
      "operator": "includingRegex",
      "expression": "(?i)(cena|koszt|licencj)"
    }]
  }]
}
Na potrzeby dashboardu natywny konektor Search Console w Looker Studio wywołuje to samo API bez żadnego kodu — praktyczna droga, o ile dane i tak nie trafiają do hurtowni. Jedno ograniczenie strukturalne warto znać przed jakimkolwiek projektowaniem: konektor oferuje tabelę na poziomie usługi oraz tabelę na poziomie adresu URL, a zapytanie i stronę docelową da się połączyć tylko w tabeli na poziomie adresu URL. Jej liczby są agregowane według stron i dlatego nie sumują się do wartości z poziomu usługi. To właściwość samych danych Search Console, a nie usterka konektora, i żadne pole obliczeniowe tego nie obejdzie.
Dwie reguły regexu, od których wszystko zależy
Oba miejsca, w których da się napisać wyrażenie regularne, zachowują się inaczej, niż przywykli ludzie znający regex skądinąd.
Search Console używa RE2, bez lookahead i bez lookbehind. Znana sztuczka na non-brand — negatywny lookahead wykluczający nazwę marki — po prostu się nie skompiluje. Wspieranym podejściem jest odwrócenie samego filtra: własny filtr regex ustawiony na nie pasuje, z wzorcem marki jako wyrażeniem.
REGEXP_MATCH w Looker Studio wymaga, żeby wzorzec dopasował całą wartość pola, a nie jej fragment. Wzorzec acme trafi wyłącznie zapytanie będące dokładnie słowem acme; żeby trafić każde zapytanie je zawierające, trzeba wypisać symbole wieloznaczne:
-- Pole: marka vs non-brand
CASE
  WHEN REGEXP_MATCH(Query, '(?i).*(acme|acme corp|acmecorp|acme app).*')
    THEN 'Marka'
  ELSE 'Non-brand'
END
Flaga (?i) czyni dopasowanie niewrażliwym na wielkość liter w obu systemach, a alternatywę marki warto od początku wypełnić hojnie: literówki, zapis z odstępem i bez oraz nazwa produktu należą do worka marki, ponieważ każda pozostawiona poza nim zawyża liczbę non-brand o wyszukiwania, których nigdy nie wygrano treścią.
Zamiana tematów w klastry
Ta sama konstrukcja, rozbudowana, staje się wymiarem, na którym opiera się dashboard. Kolejność ma znaczenie — wygrywa pierwsza pasująca gałąź, więc marka należy na początek, inaczej markowe wyszukiwanie funkcji wyląduje w klastrze tej funkcji:
-- Pole: klaster zapytania
CASE
  WHEN REGEXP_MATCH(Query, '(?i).*(acme|acmecorp).*')             THEN 'Marka'
  WHEN REGEXP_MATCH(Query, '(?i).*(cena|koszt|ile kosztuje).*')   THEN 'Cennik'
  WHEN REGEXP_MATCH(Query, '(?i).*(integrac|api|webhook|sync).*') THEN 'Integracje'
  WHEN REGEXP_MATCH(Query, '(?i).*(vs |alternatyw|porownan).*')   THEN 'Porownania'
  ELSE 'Bez dopasowania'
END
Zachowanie wyraźnej gałęzi Bez dopasowania zamiast etykiety zbiorczej sprawia, że pole daje się utrzymywać. Ten worek jest listą roboczą: posortowany po wyświetleniach wypisuje popyt, którego taksonomia jeszcze nie ujmuje — i każdy klaster po pierwszych dwóch powstaje zwykle z lektury tej listy.
Odczyt dashboardu
Przy wymiarze klastra wystarczą trzy wykresy. Wyświetlenia według klastra w czasie pokazują, czy widoczność się poszerza, czy zawęża. Kliknięcia i CTR według klastra pokazują, czy ta widoczność zamienia się w wizyty. Tabela zapytań bez dopasowania zasila kolejną iterację taksonomii.
Pułapką tego widoku jest klaster marki. Wyszukiwania markowe rosną wraz z rozpoznawalnością, kampaniami i sezonowością, a konwertują znacznie lepiej niż cokolwiek innego — zdrowo wyglądająca suma może więc ukrywać pod sobą kurczące się klastry non-brand. Raportowanie marki i non-brand jako osobnych linii, zamiast jednej sumy widoczności, utrzymuje to na widoku.
Czego te dane nie powiedzą o wynikach generatywnych
Search Console nie ma wymiaru dla odpowiedzi generowanych przez AI. Wyświetlenia, które nastąpiły wewnątrz wyniku generatywnego, znajdują się w tych samych danych skuteczności co zwykłe wyniki i nie ma filtra, który by je oddzielił — każdy dashboard twierdzący, że mierzy z tego źródła widoczność generatywną, wnioskuje, a nie mierzy.
Warto obserwować klaster informacyjny, którego wyświetlenia utrzymują się lub rosną, a kliknięcia i CTR spadają w okresie bez utraty pozycji, która tłumaczyłaby ten spadek. Jednym z możliwych wyjaśnień jest to, że użytkownicy znajdują odpowiedzi już na stronie wyników. Ten sam wzorzec pasuje jednak także do zmienionego snippetu albo innego składu zapytań w klastrze. W raporcie powinien więc być pytaniem do zbadania, a nie metryką widoczności generatywnej.
Pozostając w granicach
Trzy właściwości danych źródłowych ograniczają to, co dashboard może uczciwie twierdzić. Rzadkie zapytania są w całości wstrzymywane ze względów prywatności, więc wiersze zapytań zawsze zsumują się do mniej niż wartości całej usługi — ta różnica nie jest usterką do uzgodnienia, a udziały klastrów należy czytać jako udziały w zapytaniach, które są raportowane. Historia kończy się po szesnastu miesiącach, co umożliwia porównanie rok do roku, ale nie drugi taki rok; wszystko dłuższe wymaga własnego składowania. A średnia pozycja jest już średnią ważoną wyświetleniami w obrębie każdego wiersza; uśrednianie tych średnich w klastrze daje liczbę, która wygląda precyzyjnie i znaczy niewiele — dlatego wyświetlenia i kliknięcia niosą argument lepiej niż pozycja.
Pytania i odpowiedzi
Jak bez lookahead wyrazić warunek dwuczęściowy, na przykład objąć markę i nazwy produktów, ale wykluczyć konkurencję?
Za pomocą kolejności i osobnych filtrów zamiast negacji we wzorcu. Taki zamiennik pozostaje przy RE2 do dyspozycji i sprawdza się szerzej, niż mogłoby się na pierwszy rzut oka wydawać.
W polu obliczeniowym decyduje pierwsza pasująca gałąź. Gałąź dla konkurencji umieszcza się więc przed gałęzią dla marki i produktu: zapytanie zawierające obie nazwy trafia do klastra konkurencji, a nie do marki. W ten sposób wyjątek jest wyrażony bez potrzeby, by jakikolwiek wzorzec coś wykluczał.
Przy filtrowaniu to samo zadanie przejmuje odwrócenie filtra. W API jedna grupa filtrów mieści dwa filtry obowiązujące łącznie: jeden z includingRegex i wzorcem marki, drugi z excludingRegex i wzorcem konkurencji. W Looker Studio wykres również da się opatrzyć dwoma filtrami, uwzględniającym i wykluczającym. Dwa filtry zamiast jednego wyrażenia.
Kolejność gałęzi i podział na dwa filtry należy opisać w komentarzu, ponieważ jedno i drugie wygląda później na przypadek. Krótka notatka przy polu, która gałąź jest na początku i dlaczego, oszczędza następnej osobie odtwarzania tego z danych.
Powiązane artykuły