English
 Deutsch
 Polski
410 Gone na robots.txt: jak odpowiedź 4xx na plik reguł zmienia zachowanie crawlera

Spis treści
Odmowa ma zakończyć rozmowę. Najwyraźniejsza, jaką zna sieć, to 410 Gone: nie „spróbuj później”, nie „przeniesione”, lecz „to istniało i już nie istnieje”.
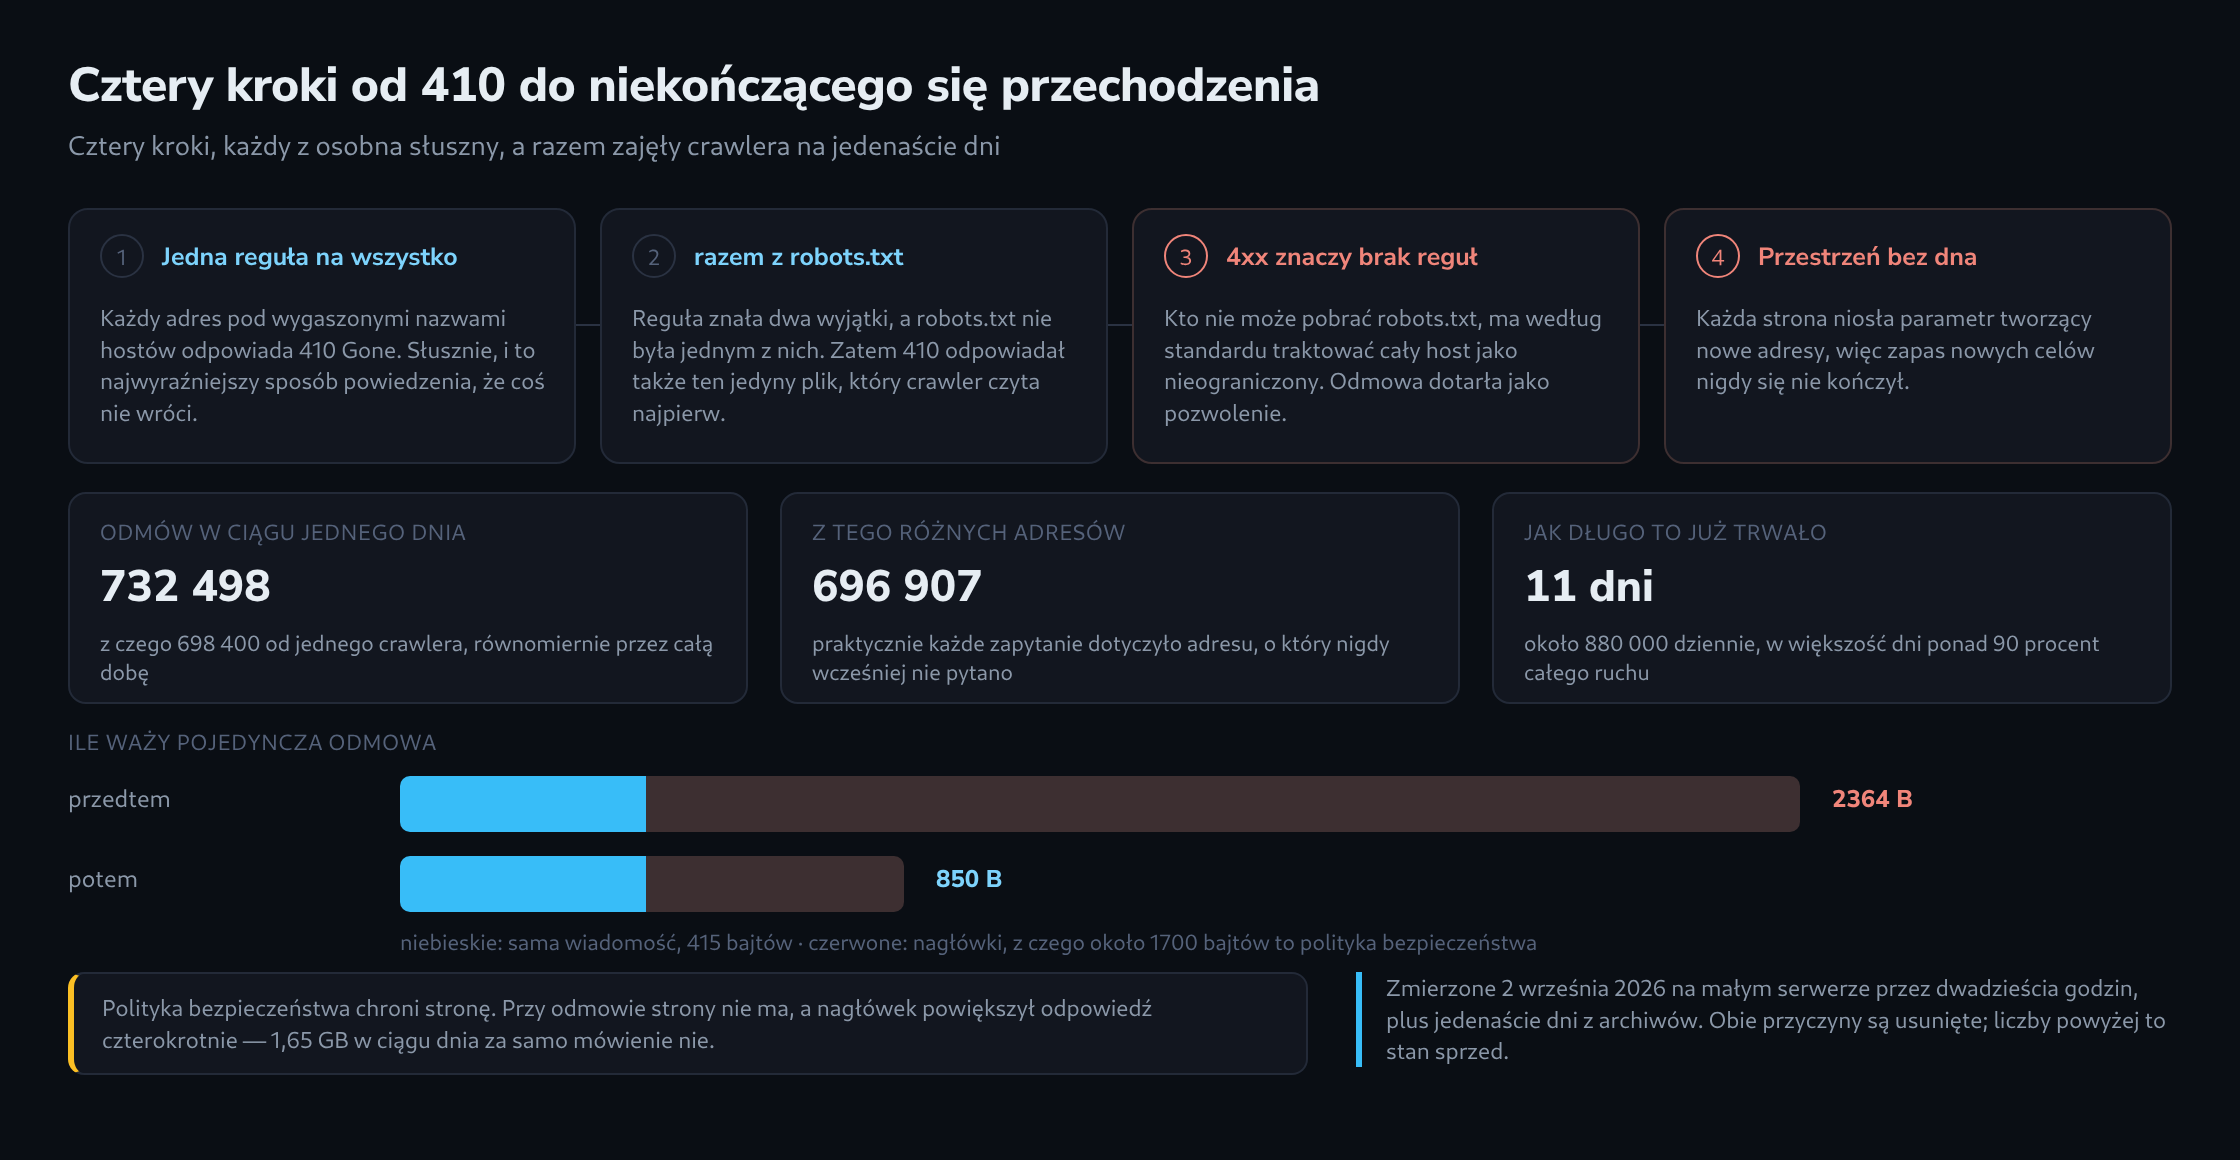
Mały serwer wysłał tę odmowę w ciągu jednego dnia 732 498 razy. Crawler, który dostał ich najwięcej, nie zwolnił – i nie zwalniał od jedenastu dni.
Co naprawdę mówi 410
Kilka odpowiedzi opisuje sposoby, na jakie strona bywa niedostępna, i mówią rzeczy dość różne.
404 Not Found znaczy: tutaj nic nie ma. Pozostaje otwarte, czy coś tu było wcześniej albo będzie jutro. Crawler traktuje to jako stan tymczasowy i wraca.
410 Gone znaczy: tutaj coś było, zostało celowo usunięte i nie ma nowego adresu. To najmocniejszy sposób powiedzenia, że strona jest zamknięta, a wyszukiwarki porzucają takie adresy szybciej niż po 404.
Odpowiadanie na tysiące martwych adresów przez 410 jest zatem wyborem słusznym. Błąd leżał w zupełnie innym miejscu.
Reguła objęła jedyny plik, który mógł to zakończyć
Odmowa tkwiła w jednej regule: każdy adres pod wygaszonymi nazwami hostów odpowiada 410. Wycięto dwa wyjątki, oba świadome i oba wąskie.
robots.txt nie była jednym z nich.
Łatwo to przeoczyć: plik robots.txt zawiera reguły dla crawlerów, ale sam nie jest stroną z treścią. Reguła mówiąca „tutaj wszystko przepadło” obejmuje jednak także jego adres. Dlatego, tak jak pozostałe adresy, zwracał odpowiedź 410.
Dlaczego odpowiedź 4xx znaczy brak ograniczeń
W tym miejscu z przeoczenia robi się zaproszenie.
Standard mówi jednoznacznie, co obowiązuje, gdy robots.txt nie da się pobrać. Odpowiedź 5xx – serwer jest zepsuty – znaczy: cała witryna liczy się jako zabroniona, spróbować później. Odpowiedź 4xx znaczy odwrotnie: na tym hoście nie ma reguł, wolno pobierać wszystko.
Rozumowanie za tym stoi solidne. Brakująca robots.txt zawsze znaczyła „brak ograniczeń”, a nic nie odróżnia „ten host nigdy nie miał reguł” od „ten host je usunął”. 404 i 410 trafiają do tej samej szuflady.
Odmowa dotarła więc dokładnie na opak. Nie mówiła „trzymaj się z daleka”. Mówiła w tym jednym zdaniu, które crawler czyta, zanim cokolwiek rozstrzygnie, że nic tu nie jest zamknięte.
Przestrzeń adresowa bez dna
Błędna odpowiedź robi się kosztowna dopiero wtedy, gdy jest na co ją wydać.
Pytane adresy niosły parametr zapisujący, skąd crawler przyszedł. Każda strona odsyłała więc do adresów, których wcześniej nigdy nie było, a tamte odsyłały dalej. Zapas nigdy się nie kończył.
Liczby pokazują to wyraźnie: z 698 400 zapytań jednego dnia 696 907 dotyczyło różnych adresów – dwa na tysiąc były powtórzeniami. Crawler przechodzący taką przestrzeń nie robi nic złego; podąża za odnośnikami, a to całe jego zadanie. Nigdy nie skończy.
Ile waży pojedyncza odmowa
Ostatnia niespodzianka tkwiła w rozmiarze.
Sama wiadomość jest mała: 415 bajtów zwykłego tekstu z informacją, że zasób przepadł. Nagłówki wokół niej dały 1949 bajtów, a około 1700 z nich to polityka bezpieczeństwa treści.
Ta polityka reguluje, co wolno załadować stronie. Przy odmowie strony nie ma – nie ma czego ładować, czego regulować ani czego nagłówek miałby chronić. Dołączono ją mimo to do każdej z 732 498 odpowiedzi, bo była ustawiona na „zawsze”, co dla prawdziwych stron jest właśnie słuszne.
Wynik: 2364 bajty za powiedzenie nie i 1,65 GB dziennie wydane na to.
Co z tego wynika
Trzy rzeczy, uszeregowane według skutku.
Reguła, która sprawia, że host znika, potrzebuje wyjątku dla pliku opisującego ten host. robots.txt i wszystko inne, co crawler czyta, żeby rozstrzygnąć, musi pozostać czytelne, nawet gdy wszystko opisane przepadło. Osiągalna robots.txt z jednym Disallow: / kończy ruch u źródła, zamiast go przyjmować.
Nagłówki przeznaczone dla stron nie należą do odmów. Ograniczenie ich do hostów, które faktycznie wydają strony, zmniejszyło każdą odpowiedź z 2364 do 850 bajtów – ta sama odmowa przy mniej więcej jednej trzeciej ciężaru.
A parametr tworzący nowe adresy zamienia każde przechodzenie w nieskończone. Tam, gdzie za usuniętą treścią leży taka przestrzeń, usunięcie nie jest końcem pracy.
Pytania i odpowiedzi
Czy Disallow: / usuwa stare adresy także z indeksu wyszukiwarki?
Nie od razu. Disallow zabrania pobierania, a nie indeksowania. Zablokowany adres nie jest już pobierany, więc crawler nie widzi też jego odpowiedzi 410. Adresy, które są już znane albo do których prowadzą odnośniki z innych miejsc, mogą zatem pozostać w indeksie jako sam adres bez treści. Znacznik noindex nic tu nie pomoże, bo on również znajdowałby się na stronie, której crawler już nie pobiera.
Kto chce osiągnąć jedno i drugie, musi ustalić kolejność: najpierw ważne adresy muszą mieć okazję zwrócić swoje 410, a dopiero potem blokada kończy ruch. Przy przestrzeni adresowej bez dna, takiej jak w artykule, ten plan się nie sprawdza, bo odmowy nigdy by się nie skończyły. Tam blokada jest lepszym wyborem, nawet jeśli pojedyncze adresy przez jakiś czas zostaną w indeksie.
Dlaczego nie odpowiadać na robots.txt kodem 503, żeby cała witryna liczyła się jako zablokowana?
Bo taka blokada działa tylko przez pewien czas. RFC 9309 traktuje błąd serwera przy robots.txt najpierw jako pełny zakaz, ale pozwala crawlerowi, gdy plik długo pozostaje nieosiągalny (standard podaje przykładowo 30 dni), postępować tak, jakby robots.txt nie istniała, albo nadal korzystać z kopii z pamięci podręcznej. W pierwszym przypadku host znów zostaje bez reguł, dokładnie tak jak przy 410. Osiągalny plik z Disallow: / to forma, która obowiązuje trwale.
Jak szybko działa poprawiona robots.txt?
Z opóźnieniem do jednej doby. RFC 9309 przewiduje, że crawler nie powinien korzystać z robots.txt z pamięci podręcznej dłużej niż 24 godziny; do tego czasu może jeszcze działać według starej odpowiedzi, czyli tak, jakby nie było żadnych reguł. To, czy poprawka działa, widać więc dopiero w ruchu następnego dnia, a nie w pierwszej godzinie.
Powiązane artykuły