English
 Deutsch
 Polski
Self-Hosted Large Language Model (LLM) z Ollama za serwerem proxy z autoryzacją

Spis treści
- 1. Architektura rozwiązania: Bezpieczny potok inferencji brzegowej
- 2. Wdrożenie kontenerów i akceleracji GPU krok po kroku
- 3. Konfiguracja proxy uwierzytelniającego Nginx krok po kroku
- 4. Weryfikacja działania skryptów i interfejsu Web UI krok po kroku
- 5. Podsumowanie i wartość architektoniczna
- Pytania i odpowiedzi
- Źródła
Przesyłanie poufnych dokumentów firmowych, danych klientów czy kodu źródłowego do publicznych interfejsów API dużych modeli językowych (LLM), takich jak OpenAI, Anthropic czy Google Gemini, wiąże się z poważnym ryzykiem utraty suwerenności danych oraz naruszeniami przepisów RODO. Hostowanie otwartych modeli AI – takich jak Llama 3.1, Mistral czy CodeLlama – na własnej infrastrukturze serwerowej gwarantuje całkowitą izolację informacji. Ponieważ popularny serwer inferencyjny Ollama domyślnie wystawia swoje API REST na porcie 11434 bez natywnego uwierzytelniania, jego bezpieczne wdrożenie w sieci przedsiębiorstwa wymaga zastosowania dodatkowej warstwy architektonicznej: serwera proxy odwrotnego Nginx wymuszającego rygorystyczne uwierzytelnianie oraz szyfrowanie TLS.
1. Architektura rozwiązania: Bezpieczny potok inferencji brzegowej
Profesjonalne lokalne wdrożenie modelu LLM oddziela wykonywanie obliczeń od bezpośredniej ekspozycji sieciowej poprzez warstwowe połączenie trzech odizolowanych usług w środowisku kontenerowym:
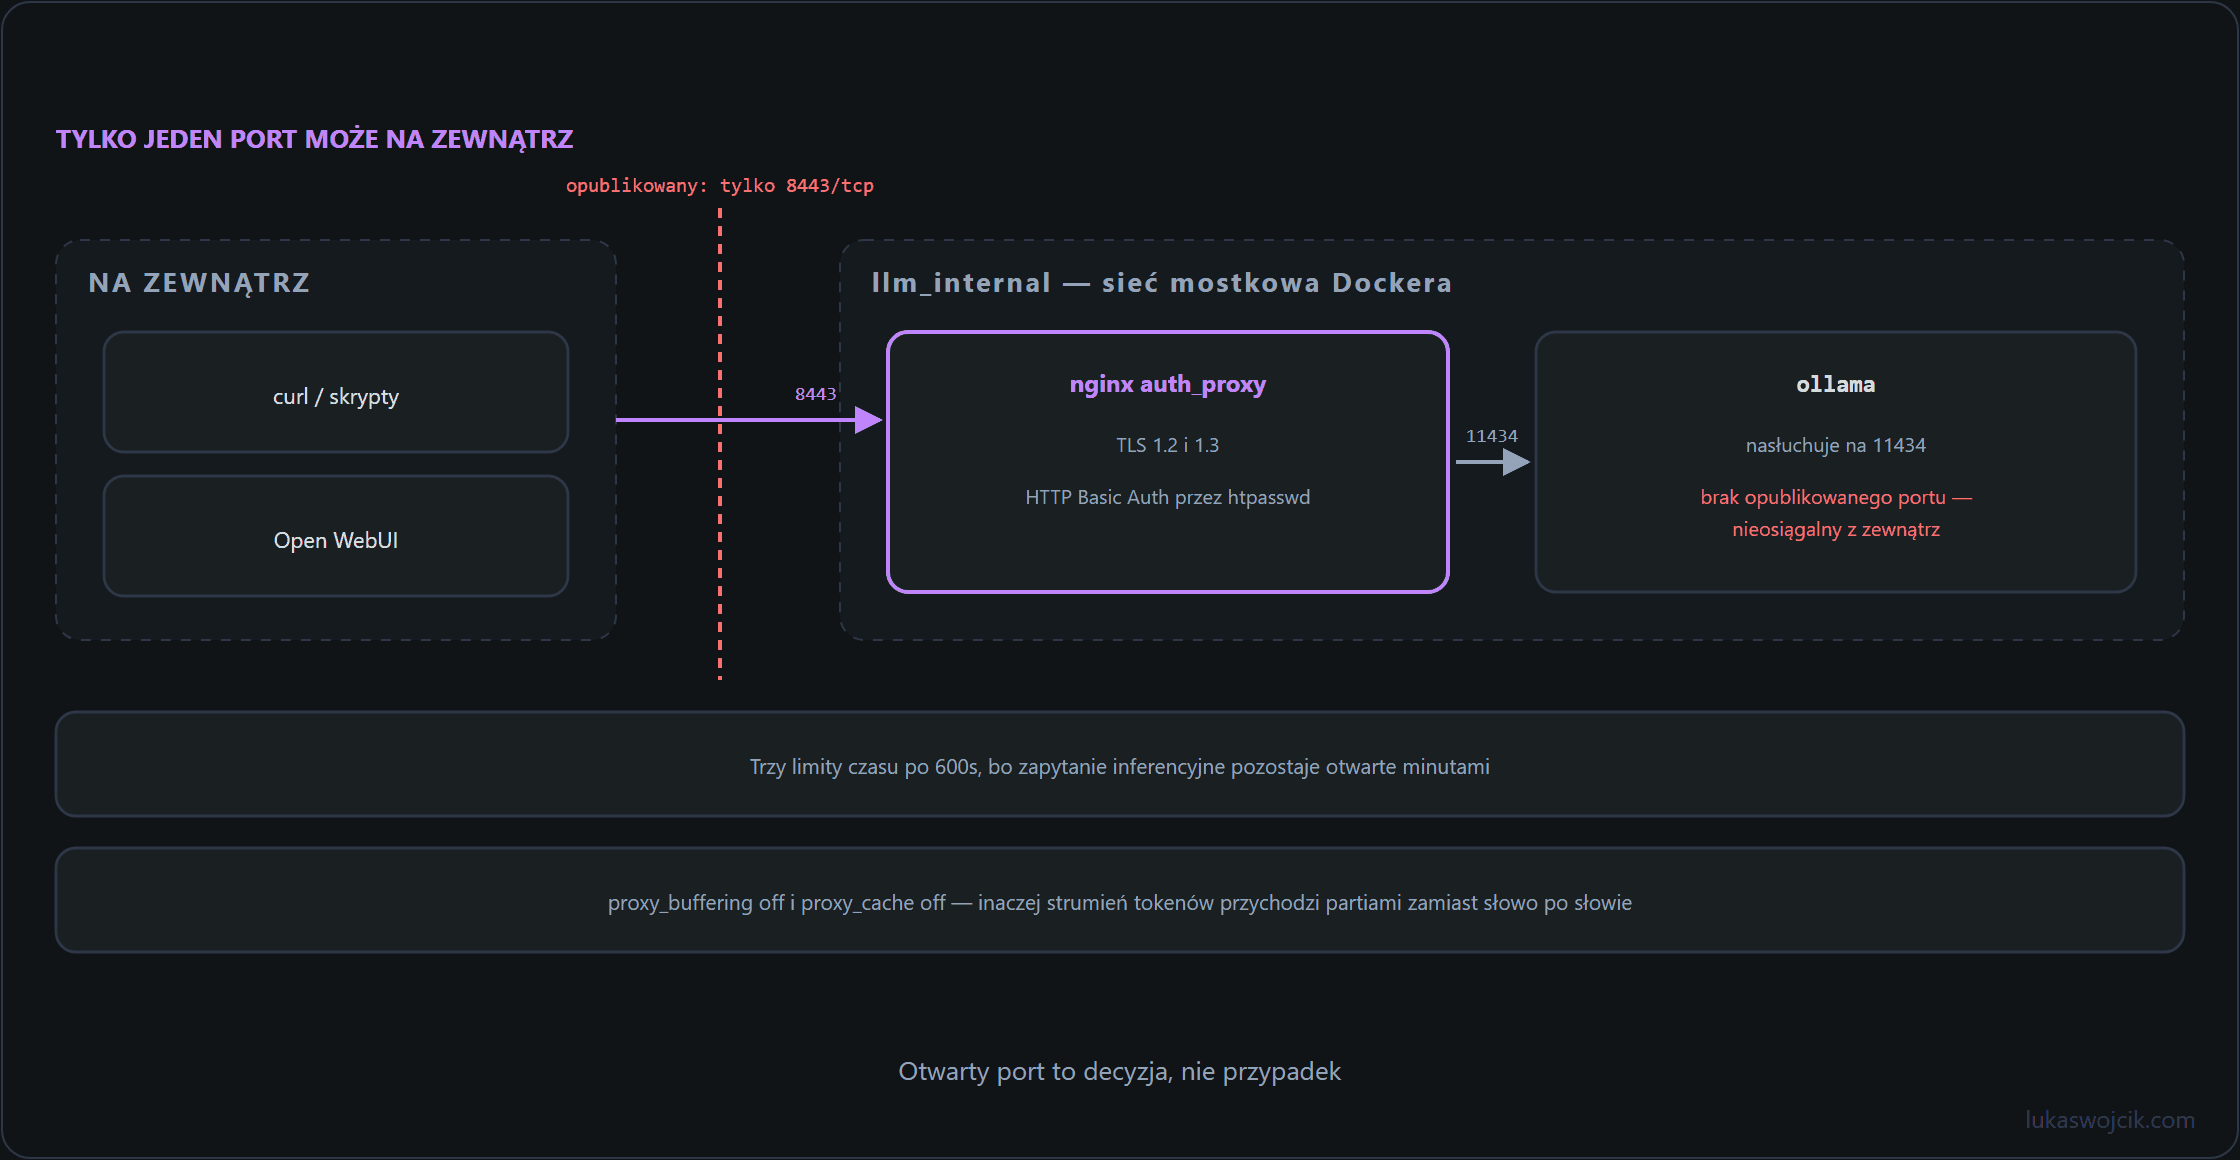
- Backend inferencyjny Ollama: Wykonuje obliczenia modeli o otwartych wagach przy użyciu akceleracji GPU NVIDIA (za pośrednictwem NVIDIA Container Toolkit) lub kwantyzacji CPU, komunikując się wyłącznie przez wewnętrzne interfejsy sieci kontenerowej.
- Serwer proxy uwierzytelniający i szyfrujący Nginx: Działa jako jedyny punkt wejścia, przechodząc przez który każde zapytanie HTTP podlega terminacji SSL/TLS oraz weryfikacji poświadczeń HTTP Basic Auth przed przekazaniem do serwera Ollama.
- Kompatybilny z OpenAI interfejs lub skrypty: Wewnętrzne interfejsy internetowe (np. Open WebUI) lub zautomatyzowane skrypty Python komunikują się z zabezpieczonym punktem końcowym przy użyciu standardowej składni SDK OpenAI, bez pomijania warstwy ochronnej.
2. Wdrożenie kontenerów i akceleracji GPU krok po kroku
W celu uruchomienia serwera Ollama wraz z dedykowanym proxy odwrotnym Nginx należy wdrożyć poniższy produkcyjny plik docker-compose.yml skonfigurowany pod kątem dostępu do procesorów graficznych (GPU Passthrough) oraz izolacji sieciowej:
services:
  ollama:
    image: ollama/ollama:latest
    container_name: enterprise_ollama
    restart: always
    environment:
      - OLLAMA_HOST=0.0.0.0
      - OLLAMA_ORIGINS=*
    volumes:
      - ./ollama_data:/root/.ollama
    deploy:
      resources:
        reservations:
          devices:
            - driver: nvidia
              count: all
              capabilities: [gpu]
    networks:
      - llm_internal

  auth_proxy:
    image: nginx:alpine
    container_name: ollama_auth_proxy
    restart: always
    ports:
      - "8443:443"
    volumes:
      - ./nginx.conf:/etc/nginx/nginx.conf:ro
      - ./certs:/etc/nginx/certs:ro
      - ./htpasswd:/etc/nginx/.htpasswd:ro
    depends_on:
      - ollama
    networks:
      - llm_internal

networks:
  llm_internal:
    driver: bridge
3. Konfiguracja proxy uwierzytelniającego Nginx krok po kroku
Aby ograniczyć dostęp do API wyłącznie do autoryzowanych systemów firmowych, Nginx jest konfigurowany z wymogiem HTTP Basic Auth. Poniższy skrypt nginx.conf egzekwuje uwierzytelnianie i wydłuża limity czasowe dla długotrwałego strumieniowania odpowiedzi modeli LLM:
events {
    worker_connections 1024;
}

http {
    upstream ollama_backend {
        server ollama:11434;
    }

    server {
        listen 443 ssl;
        server_name llm.internal.domain;

        ssl_certificate /etc/nginx/certs/server.crt;
        ssl_certificate_key /etc/nginx/certs/server.key;
        ssl_protocols TLSv1.2 TLSv1.3;

        # Wymuszenie HTTP Basic Auth (Generowanie przez: htpasswd -c ./htpasswd api_user)
        auth_basic "Enterprise LLM Secure Gateway";
        auth_basic_user_file /etc/nginx/.htpasswd;

        # Obowiązkowe wydłużenie timeoutów dla strumieniowania długich odpowiedzi
        proxy_read_timeout 600s;
        proxy_connect_timeout 600s;
        proxy_send_timeout 600s;

        location / {
            proxy_pass http://ollama_backend;
            proxy_set_header Host $host;
            proxy_set_header X-Real-IP $remote_addr;
            proxy_set_header X-Forwarded-For $proxy_add_x_forwarded_for;
            proxy_set_header X-Forwarded-Proto $scheme;

            # Obsługa strumieniowania Server-Sent Events (SSE)
            proxy_buffering off;
            proxy_cache off;
        }
    }
}
4. Weryfikacja działania skryptów i interfejsu Web UI krok po kroku
Po uruchomieniu proxy serwer inferencyjny da się bezpiecznie odpytywać za pomocą skryptów lub połączyć z interfejsami czatu:
- Pobieranie modeli: Początkowe pobranie modelu odbywa się wewnątrz kontenera przy użyciu wiersza poleceń:
docker exec -it enterprise_ollama ollama run llama3.1 - Weryfikacja przez API w Pythonie/cURL: Wysłanie uwierzytelnionego zapytania HTTPS REST do proxy z podaniem poświadczeń Basic Auth:
curl -k -u "api_user:SecretPassword123" https://localhost:8443/api/generate -d '{"model": "llama3.1", "prompt": "Podsumuj politykę prywatności firmy.", "stream": false}' - Połączenie z Open WebUI: Wdrożenie kontenera
open-webuiw tej samej sieci przy odpowiednim skonfigurowaniu zmiennej środowiskowej punktu końcowego:OLLAMA_BASE_URL=https://api_user:SecretPassword123@auth_proxy:443
5. Podsumowanie i wartość architektoniczna
Co da się osiągnąć dzięki temu poradnikowi: Wdrożenie własnego, akcelerowanego procesorami GPU serwera dużych modeli językowych (LLM) z wykorzystaniem platformy Ollama, zabezpieczonego przez serwer proxy Nginx z uwierzytelnianiem i szyfrowaniem SSL/TLS.
Wynikająca z tego wartość: Wewnętrzne zespoły, systemy programistyczne oraz interfejsy pracowników zyskują dostęp do prywatnego, wysoce wydajnego odpowiednika „ChatGPT” bez ryzyka wycieku danych do zewnętrznych komercyjnych interfejsów API. Zachowana zostaje pełna suwerenność informacji oraz zgodność z przepisami RODO, a obowiązkowe nagłówki uwierzytelniające uniemożliwiają nieuprawniony dostęp do firmowych zasobów obliczeniowych.
Pytania i odpowiedzi
Dlaczego proxy ustawia limity czasowe 600 sekund i czy obejmują one całą odpowiedź?
Nie obejmują całej odpowiedzi. Według dokumentacji nginx proxy_read_timeout ogranicza tylko czas między dwiema kolejnymi operacjami odczytu; wartość domyślna wynosi 60 sekund. Przy strumieniowaniu każdy wygenerowany token przynosi nowy fragment odpowiedzi i odliczanie zaczyna się od nowa. Krytyczna jest praca bez strumieniowania, jak w przykładowym poleceniu curl z "stream": false. Ollama wysyła wtedy dopiero gotową odpowiedź. Gdy model działa na CPU albo Ollama przy pierwszym zapytaniu dopiero ładuje go do pamięci, do tego momentu może minąć ponad 60 sekund i bez dłuższego limitu nginx przerywa połączenie ze statusem 504.
W przypadku proxy_connect_timeout wysoka wartość nic natomiast nie daje. Połączenie z kontenerem w tej samej sieci Dockera powstaje w ułamku sekundy, a według dokumentacji ten limit i tak zwykle nie może przekraczać 75 sekund.
Czy przy OLLAMA_HOST=0.0.0.0 serwer Ollama jest osiągalny z pominięciem proxy?
Z zewnątrz przy tym pliku Compose nie. Zmienna sprawia, że Ollama nasłuchuje na wszystkich interfejsach kontenera, co jest konieczne, aby proxy mogło dotrzeć do usługi pod adresem ollama:11434. Na zewnątrz udostępniony jest jednak tylko port 8443 proxy, bo usługa ollama nie ma wpisu ports.
Dwie zmiany podważyłyby tę ochronę:
- Wpis w rodzaju
"11434:11434"przy usłudzeollama. Docker udostępnia takie porty przez własne reguły iptables, które według dokumentacji Dockera omijają reguły zapory ufw. Jeśli port jest potrzebny do testów na hoście, zapis"127.0.0.1:11434:11434"ogranicza go do samego hosta. - Kolejne kontenery w sieci
llm_internal. Wewnątrz tej sieci każdy kontener dociera do serwera Ollama bezpośrednio i bez uwierzytelniania, także Open WebUI, jeśli tam działa. Droga przez proxy jest wtedy ustawieniem, a nie blokadą. Wyklucza to dopiero osobna sieć tylko dla serwera Ollama i proxy; proxy zostaje przy tym dołączone do drugiej sieci, przez którą łączy się z nim Open WebUI.
Czy z proxy da się korzystać za pomocą SDK OpenAI?
Nie przy pokazanej konfiguracji. Ollama udostępnia punkty końcowe zgodne z OpenAI pod ścieżką /v1/, a SDK je odnajduje, gdy jego bazowy adres URL wskazuje na proxy z tą ścieżką. SDK wysyła jednak klucz API w nagłówku Authorization: Bearer …, a auth_basic oczekuje w tym miejscu schematu Basic z nazwą użytkownika i hasłem. Proxy odpowiada więc kodem 401.
Konfiguracja realizuje tylko Basic Auth. Dla tokenów Bearer auth_basic da się zastąpić własnym sprawdzeniem: dyrektywą map w bloku http, która porównuje $http_authorization z listą ważnych tokenów, oraz return 401 w bloku server dla każdego zapytania bez dopasowania. Każdy program może wtedy dostać własny token, który da się unieważnić osobno.
Dlaczego w poleceniu curl występuje opcja -k i czy może ona pozostać w środowisku produkcyjnym?
Opcja -k wyłącza weryfikację certyfikatu, aby test przeszedł także z certyfikatem samopodpisanym. W środowisku produkcyjnym nie powinna się pojawiać: bez weryfikacji TLS nie chroni przed stroną podszywającą się pod proxy, a poświadczenia Basic Auth są jedynie zakodowane w Base64, więc każdy, kto je przechwyci, może je odczytać. Zamiast tego certyfikat lub wewnętrzny urząd certyfikacji zostaje dodany na klientach do zaufanych.
Źródła
Powiązane artykuły