English
 Deutsch
 Polski
Bot-Erkennung: IP-Listen und kryptografische Signaturen im Vergleich

Inhalt
Apple hat den Adressbestand hinter dem Applebot im August 2026 vergrößert. Berichtet wird ein Sprung von rund 2.400 Adressen über zwölf Präfixe auf etwa 7.056 über dreiunddreißig, und die veröffentlichte Bereichsliste gilt dort weiterhin als unvollständig. Jeder Auftritt, der diesen Crawler gegen eine gespeicherte Kopie der Liste prüft, musste eine neue holen – oder hat stillschweigend angefangen, einen berechtigten Crawler für einen Hochstapler zu halten.
Das ist kein Mangel dieser einen Ausgabe. Es ist die kennzeichnende Eigenschaft eines Identitätsnachweises über die Adresse, und sie lohnt einen Vergleich mit der Alternative mehr als eine Beschwerde.
Der Adressbeleg und seine selbstpflegende Spielart
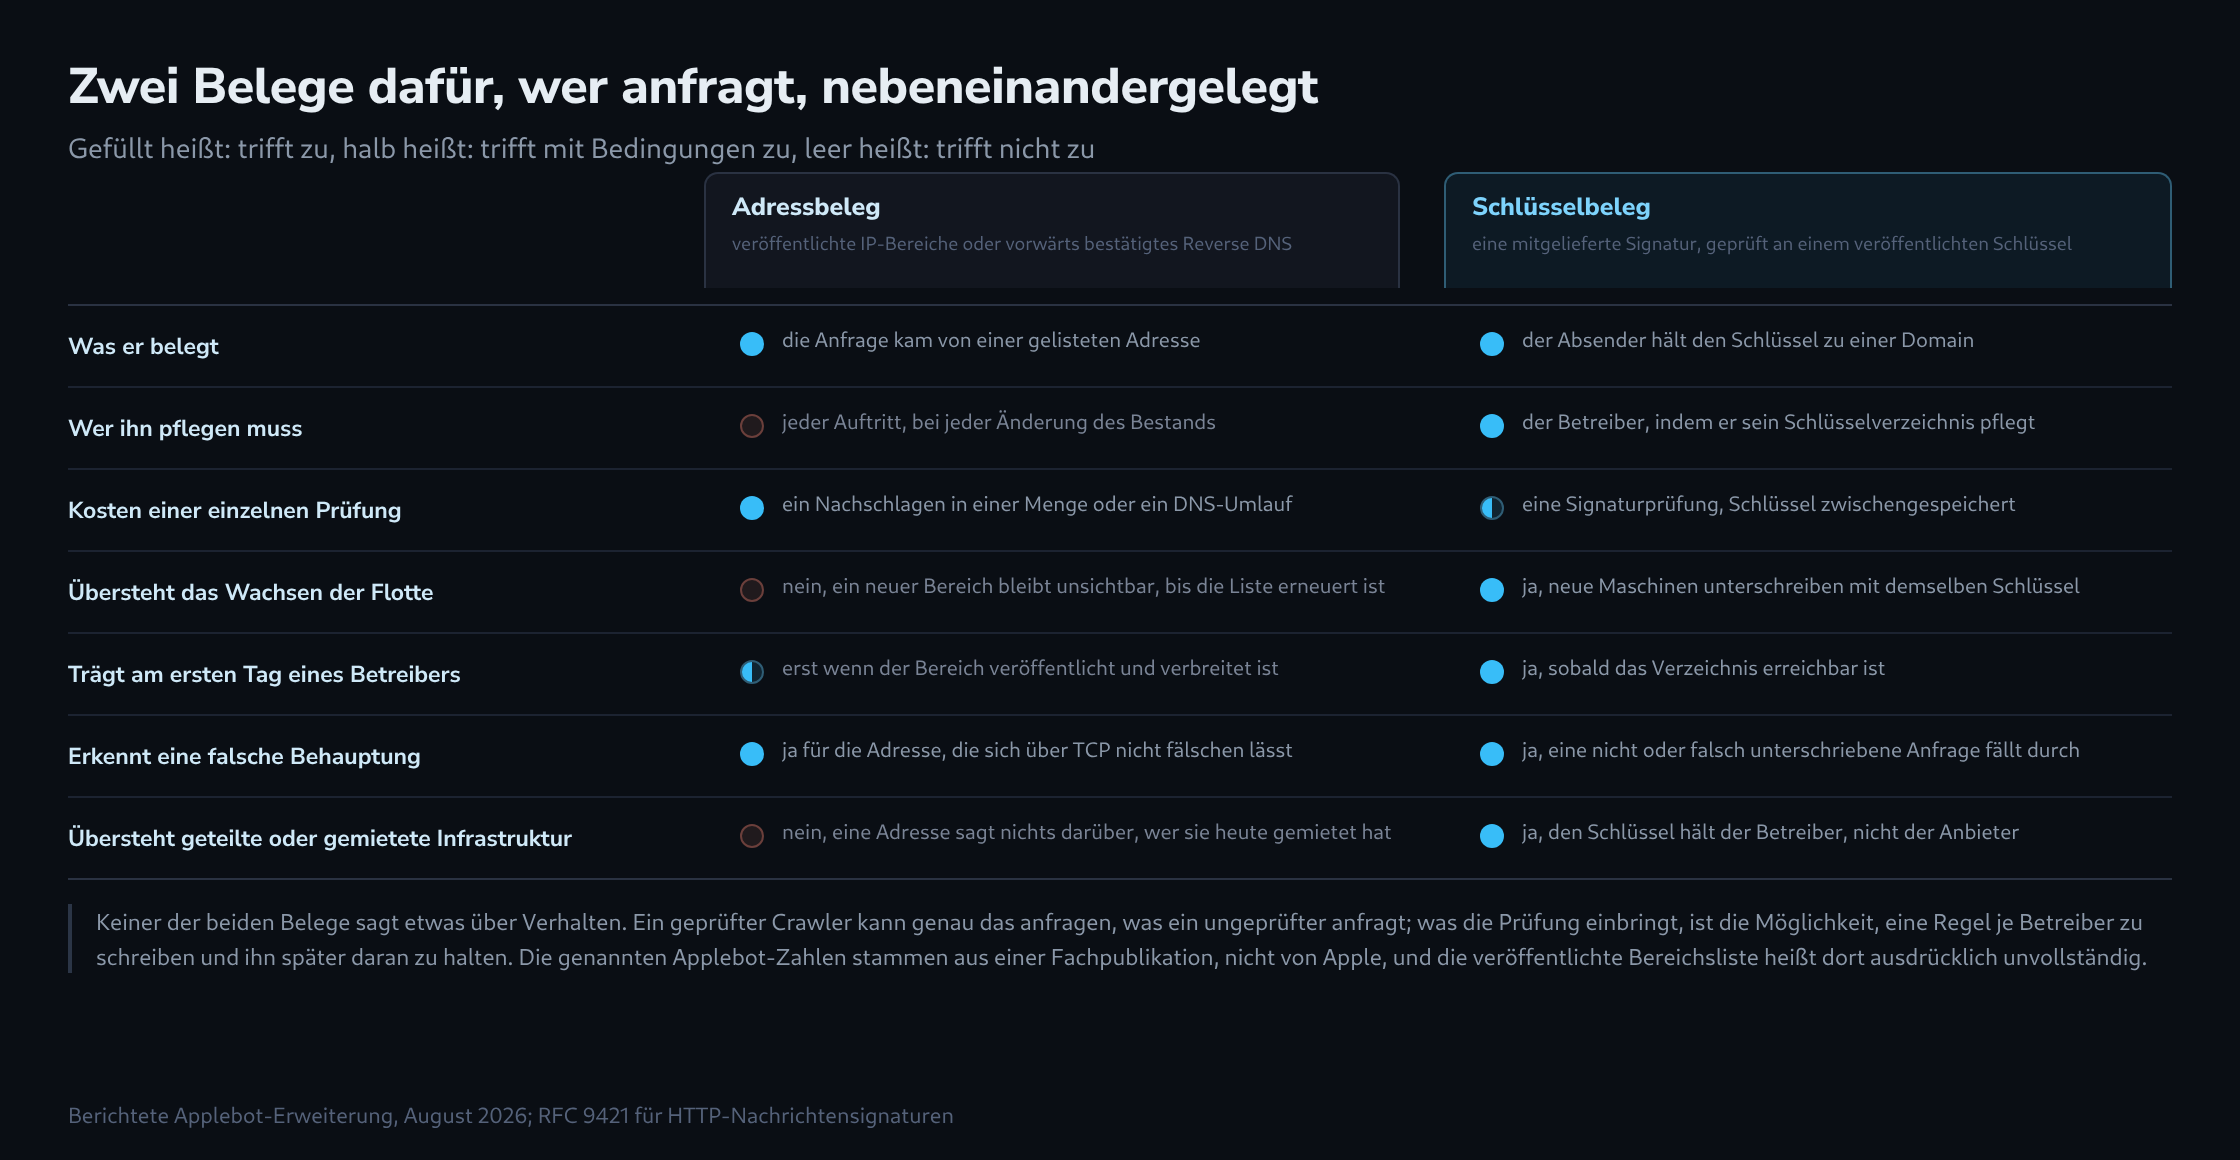
Die einfachste Form ist eine Liste von Bereichen, die der Betreiber veröffentlicht und jeder Auftritt herunterlädt. Sie trägt, weil sich eine Absenderadresse über einen abgeschlossenen TCP-Handschlag nicht fälschen lässt – das macht sie zu einem echten Herkunftsbeleg statt zu einer Behauptung.
Vorwärts bestätigtes Reverse DNS ist derselbe Beleg mit verlagerter Pflege. Statt die Bereiche vorzuhalten, löst ein Auftritt die Adresse rückwärts auf, löst den erhaltenen Namen wieder vorwärts auf und prüft, ob er auf der Adresse landet, von der er ausging.
Adresse in der Anfrage       17.241.75.12

  Rueckwaertsaufloesung      -> irgendein.applebot.apple.com
  Endungspruefung            endet auf einer Domain des Betreibers
  Vorwaertsaufloesung        -> 17.241.75.12
  Vergleich                  gleiche Adresse, also traegt die Angabe

  faellt sicher aus: ein gefaelschter Rueckwaertseintrag
  ueberlebt die Vorwaertsaufloesung nicht, weil der Angreifer
  die Vorwaertszone des Betreibers nicht kontrolliert
Diese Spielart kostet ein bis zwei DNS-Umläufe je neuer Adresse, danach zwischengespeichert, und sie veraltet nicht, wenn der Bestand wächst. Ein Adressbeleg bleibt sie trotzdem, mit allem, was daraus folgt.
Was eine Erweiterung tatsächlich kostet
Ein Bestand, der sich fast verdreifacht, erzeugt zwei Fehlerarten, und nur eine davon ist laut. Die laute ist ein blockierter Crawler, bemerkt binnen eines Tages, weil Inhalte nicht mehr aufgenommen werden. Die leise ist die schlimmere: Ein Auftritt, der ungeprüften Verkehr wie gewöhnlichen menschlichen Verkehr behandelt, hat jetzt Crawler-Aktivität im Umfang mehrerer tausend Adressen als Sitzungen in seiner Auswertung stehen.
Keine der beiden Fehlerarten meldet sich als Listenproblem. Beide sehen nach etwas anderem aus, und genau deshalb gehört der Erneuerungstakt für jede veröffentlichte Bereichsliste in einen geplanten Auftrag und nicht in jemandes Gedächtnis.
Der Schlüsselbeleg
Der andere Weg verlagert den Nachweis in die Anfrage. Der Betreiber hält ein Schlüsselpaar, veröffentlicht die öffentliche Hälfte unter einer Domain, die er kontrolliert, und unterschreibt jede ausgehende Anfrage; der Auftritt prüft die Signatur am veröffentlichten Schlüssel. HTTP-Nachrichtensignaturen nach RFC 9421 sind der Mechanismus, Web Bot Auth ist die auf Agenten gerichtete Ausprägung davon.
Sein Vorteil gegenüber einer Adresse ist struktureller Art. Ein Schlüssel folgt dem Betreiber, nicht der Maschine – neue Kapazität unterschreibt am Tag ihrer Inbetriebnahme mit demselben Schlüssel, und keine Liste irgendwo muss angefasst werden. Er übersteht außerdem gemietete Infrastruktur, wo eine Adresse wirklich nicht weiterhilft: Der Adressblock gehört einem Rechenzentrumsanbieter, und das sagt niemandem, wer ihn in diesem Monat mietet.
Der Preis dafür ist, dass es ihn nur gibt, wo ein Betreiber sich dafür entschieden hat. Ein Adressbeleg wirkt gegen jeden Crawler, der Bereiche veröffentlicht, und das sind fast alle etablierten; ein Schlüsselbeleg wirkt gegen die Teilmenge, die unterschreibt, und die ist heute klein.
Welcher, und wann
In der Praxis konkurrieren die beiden nicht. Eine Adressprüfung beantwortet eine Frage, die eine Signatur nicht beantworten kann: ob Verkehr, der sich für einen bekannten Crawler ausgibt, tatsächlich dort herkommt, wo dieser Crawler wohnt. Eine Signatur beantwortet eine Frage, die eine Adresse nicht beantworten kann: welcher von mehreren Betreibern in einem gemeinsamen Rechenzentrum das hier geschickt hat.
Sinnvoll ist deshalb, die Adressprüfung zuerst laufen zu lassen, weil sie billig ist und die etablierten Crawler abdeckt, und eine gültige Signatur als unabhängigen zweiten Weg für die Betreiber zu akzeptieren, die einen anbieten. Was keiner von beiden liefert, ist ein Urteil darüber, wozu die Anfrage dient. Beide klären, wer fragt. Was mit der Antwort geschieht, steht in keinem der beiden Belege.
Fragen und Antworten
Genügt es nicht, den User-Agent zu prüfen?
Nein. Den User-Agent setzt jeder Client selbst; er ist die Behauptung, die geprüft werden soll, nicht ihr Beleg. Er taugt dazu, die passende Prüfung auszuwählen: Wer sich als Applebot ausgibt, wird gegen Apples Bereiche oder Hostnamen geprüft.
Was ändert sich, wenn ein CDN oder Reverse-Proxy vor dem Server sitzt?
Die Adresse, die der Server sieht, gehört dann dem vorgeschalteten Dienst. Der abgeschlossene TCP-Handschlag belegt nur noch, dass die Anfrage vom CDN kommt; die Adresse des Crawlers steht in einem Header wie X-Forwarded-For, den der Dienst anhängt. Beide Prüfungen, ob per Bereichsliste oder per Rückwärts- und Vorwärtsauflösung, müssen an dieser Adresse ansetzen, sonst prüfen sie das CDN.
Die Fälschungssicherheit wird damit zur Bedingung: Der Header ist nur so vertrauenswürdig wie sein Absender. Ein Client, der den Server direkt erreicht, kann X-Forwarded-For mit einer beliebigen Adresse aus Apples Bereichen füllen und besteht dann jede Adressprüfung. Ausgewertet werden darf der Header deshalb nur, wenn die Verbindung selbst aus den veröffentlichten Bereichen des CDN kommt, und bei mehreren Einträgen zählt der letzte, den das CDN selbst angehängt hat, nicht der erste.
Viele CDNs nehmen die Crawler-Prüfung auch selbst vor und stellen das Ergebnis in ihren Regeln bereit. Das ist bequem, verlagert aber nur die Frage zum Anbieter, ob ein erweiterter Bestand dort schon erkannt wird.
Kann eine gültige signierte Anfrage von Dritten erneut gesendet werden?
Grundsätzlich ja, etwa wenn der Betreiber einer anderen Seite eine an ihn gerichtete signierte Anfrage an einen fremden Auftritt weiterreicht. Eine Signatur belegt, wer die Nachricht unterschrieben hat, nicht, wer sie gerade sendet. RFC 9421 sieht deshalb Parameter vor, die eine Wiederholung eingrenzen: created und expires für den Zeitraum, in dem die Signatur gilt, und nonce für einen Wert, der nur einmal angenommen wird. Außerdem lässt sich festlegen, welche Teile der Anfrage unterschrieben sind, etwa der Zielhost über die Komponente @authority; eine Signatur für eine andere Domain besteht die Prüfung dann nicht.
Wie viel davon ein Auftritt verlangt, entscheidet er beim Prüfen selbst. Eine kurze Gültigkeit hält das Fenster klein, eine gespeicherte Liste bereits gesehener Nonces schließt es, kostet aber Speicher und bei mehreren Servern eine gemeinsame Ablage.
Warum taucht Crawler-Verkehr in manchen Auswertungen auf und in anderen nicht?
Weil die Werkzeuge an verschiedenen Stellen zählen. Server-Logs verzeichnen jede Anfrage, ein JavaScript-basiertes Werkzeug nur Besuche, bei denen das Skript ausgeführt wird und seinen Treffer absetzt. Viele Crawler rufen nur das HTML ab und tauchen dort nie auf; andere rendern Seiten samt JavaScript und können dann Sitzungen erzeugen.
Dazu kommt die eingebaute Filterung. GA4 schließt Verkehr bekannter Bots und Spider automatisch aus; abschalten lässt sich das nicht, und wie viel ausgeschlossen wurde, zeigt GA4 nicht an. Was nicht auf dieser Liste steht, zählt als gewöhnlicher Besuch. Eine serverseitige Zählung ohne Prüfung zählt ohnehin alles mit.
Für die leise Fehlerart heißt das: Zuerst betroffen sind eigene Zählungen auf Serverseite und Logauswertungen, die geprüfte Crawler herausrechnen und alles Übrige als menschlich behandeln. Dort lässt eine veraltete Bereichsliste jedes neue Applebot-Präfix wie einen Menschen aussehen. Steigen die angeblich menschlichen Aufrufe aus den neuen Präfixen plötzlich an, ist deshalb die gespeicherte Liste der erste Verdacht.
Praxisprüfung: GA4-Traffic-Gruppen untersuchen
Der GA4-Traffic-Prüfer gruppiert gemeldete Daten nach Browser, Betriebssystem, Land und Sitzungsquelle/-medium. Statt einer Bot-Wahrscheinlichkeit erscheinen konkrete Hinweise: keine Sitzungen mit Interaktion, durchschnittliche Dauer null, fehlende Dimensionen oder ein Automationsbegriff im Browsernamen. Eine veränderbare Mindestzahl nimmt kleine Gruppen von diesen Regeln aus; ihre Zeilen bleiben sichtbar.
Diese Beobachtungen bestätigen keine Crawler-Identität. Kampagnen, Einwilligungsverhalten, unvollständige Erfassung oder interne Tests können ähnliche Muster erzeugen. Land und Direct-Traffic beweisen keine Automation. Der CSV-Export unterstützt den Vergleich mit Server- oder CDN-Protokollen; dieser Bericht enthält jedoch weder Client-IP-Adressen noch geprüfte Signaturen. Es werden keine Daten ausgeschlossen oder verändert.
Google schließt bekannte Bots automatisch aus und zeigt deren ausgeschlossene Anzahl in GA4 nicht an. Ein Ergebnis ohne passende Regeln bedeutet daher nur, dass die gewählten Prüfungen in den gelieferten Zeilen nichts fanden. Quellen: Googles Ausschluss bekannter Bots und Data-API-Schema.
Passend dazu