English
 Deutsch
 Polski
Automatisiertes Enterprise-Reporting: PDF-Generierung mit Python & OpenAI API

Inhalt
Das manuelle Erstellen von wöchentlichen oder monatlichen Geschäftsberichten verbraucht erhebliche administrative Ressourcen und ist anfällig für menschliche Fehler. Die Kombination von Python zur Datenverarbeitung mit der OpenAI API erzeugt vollständig automatisierte, intelligente PDF-Berichte. Rohdaten aus Datenbanken oder CSV-Dateien werden in strukturierte Key Performance Indicators (KPIs) transformiert, während ein Large Language Model (LLM) eine präzise, kontextbezogene Management-Zusammenfassung (Executive Summary) formuliert. Diese automatisierte Pipeline gewährleistet eine konsistente und termingerechte Bereitstellung von Berichten.
1. Architektur-Grundlagen: Die automatisierte Reporting-Pipeline
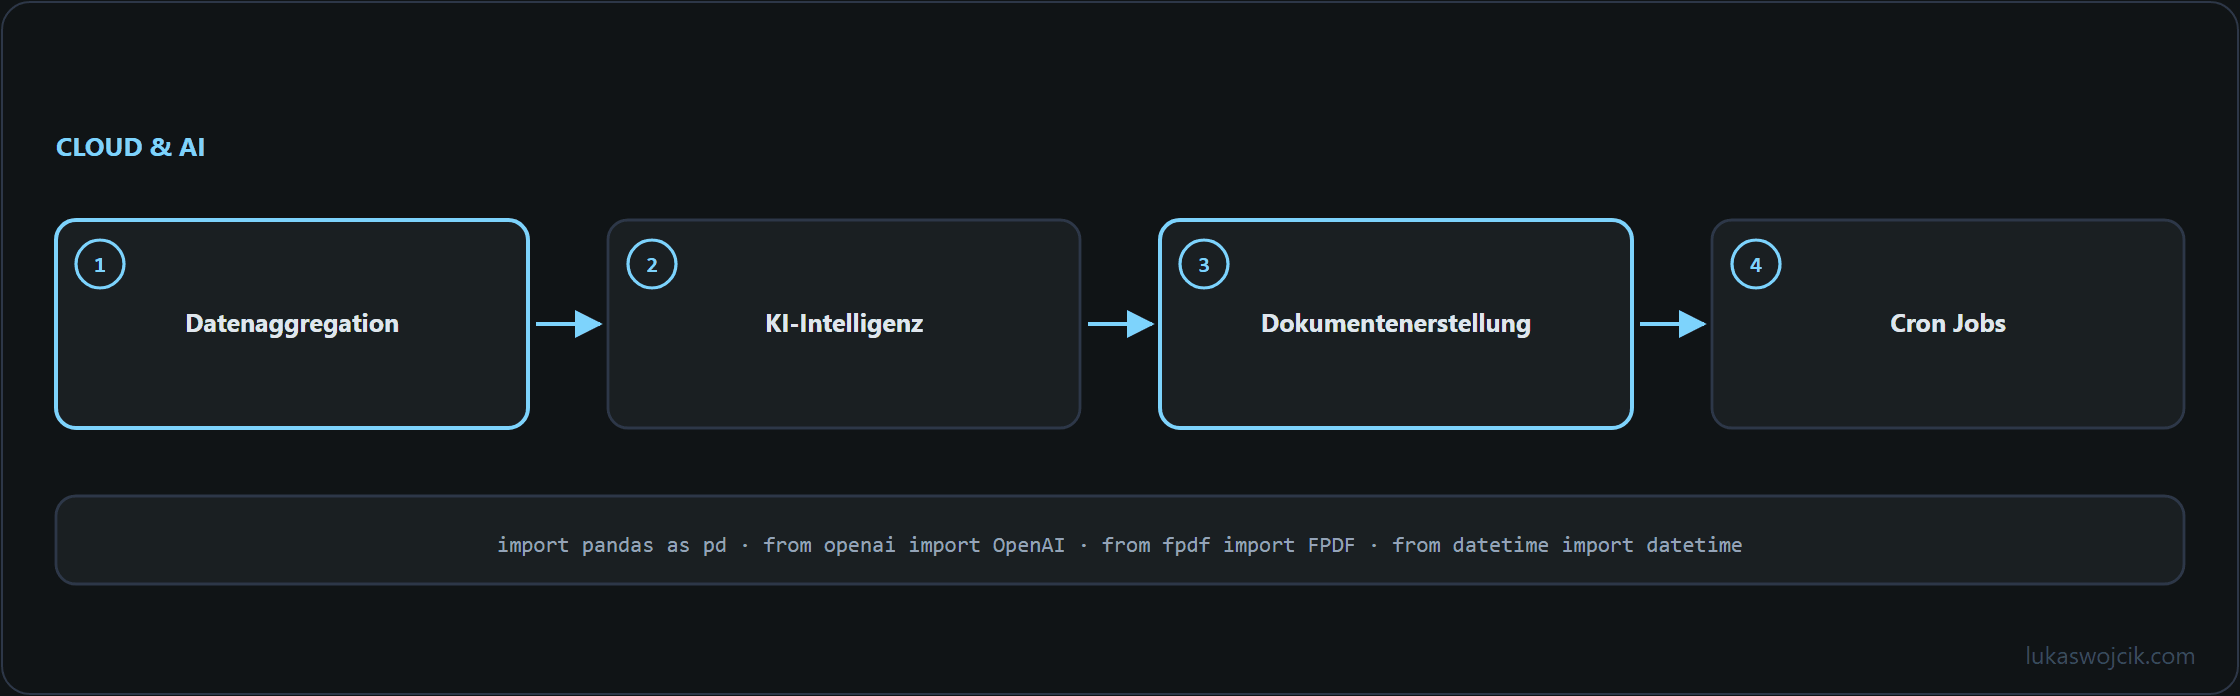
Ein automatisiertes Enterprise-Reporting-System basiert auf einer dreistufigen technischen Architektur:
- Datenaggregation (Pandas): Rohe Kennzahlen werden aus den Quellsystemen extrahiert, bereinigt und zu zentralen KPIs aggregiert.
- KI-Intelligenz (OpenAI API): Die aggregierten Metriken werden über eine strikte Prompt-Struktur an ein LLM (wie
gpt-4o) übergeben, um eine analytische und fließend lesbare Management-Zusammenfassung zu generieren. - Dokumentenerstellung (FPDF / ReportLab): Die numerischen Daten und der KI-generierte Text werden zu einem formatierten, im Corporate Design gehaltenen PDF-Dokument zusammengefügt.
2. Schritt-für-Schritt-Implementierung in Python
Zur Einrichtung der Reporting-Pipeline müssen die benötigten Bibliotheken (pandas, openai, fpdf) installiert werden. Das folgende Python-Skript demonstriert den vollständigen Prozess von der Datenerfassung bis zur finalen PDF-Ausgabe:
import pandas as pd
from openai import OpenAI
from fpdf import FPDF
from datetime import datetime

# 1. Datenaggregation via Pandas
# Im Produktionsbetrieb erfolgt der Datenabruf meist via SQL oder API
data = {'Metric': ['Umsatz', 'Neue Leads', 'Churn Rate'], 'Value': [145000, 850, '1.2%']}
df = pd.DataFrame(data)

umsatz_val = df.loc[df['Metric'] == 'Umsatz', 'Value'].values[0]
leads_val = df.loc[df['Metric'] == 'Neue Leads', 'Value'].values[0]

# 2. Generierung der KI-Management-Zusammenfassung
client = OpenAI()  # liest den Schlüssel aus der Umgebungsvariablen OPENAI_API_KEY

prompt = f"""
Agiere als Senior Business Analyst. Schreibe eine prägnante Executive Summary (max. 3 Sätze)
basierend auf den folgenden Wochen-KPIs. Bewerte die Leistung neutral.
Umsatz: {umsatz_val} €
Neue Leads: {leads_val}
Churn Rate: 1.2%
"""

response = client.chat.completions.create(
    model="gpt-4o",
    messages=[{"role": "user", "content": prompt}]
)
ai_summary = response.choices[0].message.content

# 3. Erstellung des PDF-Dokuments
pdf = FPDF()
pdf.add_page()
pdf.set_font("Arial", 'B', 16)

# Dokumentenkopf
current_date = datetime.now().strftime("%Y-%m-%d")
pdf.cell(200, 10, txt=f"Automatisierter Wochenbericht - {current_date}", ln=True, align='C')
pdf.ln(10)

# Einfügen der KPIs
pdf.set_font("Arial", 'B', 12)
pdf.cell(200, 10, txt="Key Performance Indicators:", ln=True)
pdf.set_font("Arial", '', 12)
for index, row in df.iterrows():
    pdf.cell(200, 10, txt=f"- {row['Metric']}: {row['Value']}", ln=True)
pdf.ln(10)

# Einfügen der KI-Summary
pdf.set_font("Arial", 'B', 12)
pdf.cell(200, 10, txt="Management Summary (KI-generiert):", ln=True)
pdf.set_font("Arial", '', 12)
pdf.multi_cell(0, 10, txt=ai_summary)

# Datei-Export
pdf.output("Automated_Weekly_Report.pdf")
3. Schritt-für-Schritt-Automatisierung per Scheduler
Sobald das Skript fehlerfrei funktioniert, ist eine manuelle Ausführung obsolet. Die Pipeline lässt sich vollständig über System-Scheduler automatisieren:
- Cron Jobs (Linux/macOS): Ein Eintrag via
crontab -eermöglicht die Ausführung jeden Montag um 08:00 Uhr (z. B.0 8 * * 1 /usr/bin/python3 /pfad/zum/report_script.py). - Cloud Execution: Im Enterprise-Umfeld kann das Skript als Google Cloud Function oder AWS Lambda bereitgestellt und über einen Cloud Scheduler getriggert werden.
- E-Mail-Verteilung: Durch Erweiterung des Python-Skripts um die Bibliothek
smtplibwird das generierte PDF automatisch als Anhang an einen definierten Management-Verteiler versendet.
4. Zusammenfassung & Mehrwert
Was sich damit erreichen lässt: Die erfolgreiche Implementierung einer automatisierten Reporting-Pipeline, welche Datenbankkennzahlen dynamisch aggregiert, diese mittels der OpenAI API durch eine KI-generierte Zusammenfassung anreichert und als formatiertes PDF-Dokument ausgibt.
Resultierender Mehrwert: Stundenlange manuelle Tabellenkalkulationen entfallen dauerhaft. Entscheidungsträger erhalten am Ende jedes Berichtszyklus sofort hochpräzise, konsistent formatierte Einblicke. Durch die Verlagerung der Arbeitslast von der manuellen Datenzusammenstellung auf eine automatisierte KI-Auswertung werden Unternehmensressourcen für kritische, strategische Initiativen freigesetzt.
Fragen und Antworten
Warum bricht die PDF-Erzeugung ab, sobald die Zusammenfassung ein Eurozeichen oder typografische Anführungszeichen enthält?
Weil die eingebauten Schriften von FPDF wie Arial nur einen 8-Bit-Zeichensatz kennen, im Kern Latin-1. Deutsche Umlaute liegen darin, das Eurozeichen, Buchstaben wie ł, ą oder ę, typografische Anführungszeichen und der Gedankenstrich nicht. Das Sprachmodell formuliert frei und verwendet genau solche Zeichen häufig, zumal der Prompt selbst ein Eurozeichen enthält; je nach Bibliotheksversion endet der Lauf dann mit einem Kodierungsfehler.
Abhilfe schafft eine TrueType-Schrift mit Unicode-Abdeckung, etwa DejaVu Sans, die mit add_font() eingebunden und statt Arial gesetzt wird. In der gepflegten Bibliothek fpdf2 ist das unkompliziert; das ältere Paket fpdf auf PyPI wird nicht mehr weiterentwickelt. Beide werden mit from fpdf import FPDF importiert, weshalb der Unterschied im Skript nicht auffällt.
Wie lässt sich verhindern, dass die Zusammenfassung Zahlen nennt, die nicht in den Daten stehen?
Ganz verhindern lässt es sich nicht, nur auffangen. Ein Sprachmodell formuliert, es rechnet nicht zuverlässig, und eine Aussage wie „ein Plus von 12 % gegenüber der Vorwoche“ kann entstehen, obwohl kein Vergleichswert übergeben wurde. Drei Maßnahmen verringern das Risiko:
- Nur fertige Werte übergeben. Veränderungen gegenüber der Vorwoche rechnet Pandas aus und schreibt sie in den Prompt; das Modell soll sie beschreiben, nicht herleiten.
- Vergleichswerte mitliefern. Das Skript übergibt nur die Werte einer einzigen Woche; ohne Vorperiode oder Ziel hat eine Bewertung keine Grundlage, und was das Modell dazu schreibt, ist geraten.
- Die Antwort prüfen, bevor sie ins PDF geht. Ein kurzer Abgleich zieht alle Zahlen aus dem Text und vergleicht sie mit den übergebenen; findet sich eine, die dort nicht vorkommt, geht der Bericht mit einem festen Textbaustein statt der Zusammenfassung hinaus oder wird zurückgehalten.
Der dritte Schritt ist der wichtigste, weil er als einziger nicht davon abhängt, dass sich das Modell an Anweisungen hält.
Quellen
Passend dazu