English
 Deutsch
 Polski
Conversational Analytics in Looker: Token-Abrechnung ab 1. Oktober 2026

Inhalt
Conversational Analytics in Looker ist bis zum 30. September 2026 kostenlos. Ab dem 1. Oktober läuft der Zähler: drei Dollar je Million Eingabetoken, zwanzig Dollar je Million Ausgabetoken, abgerechnet als Überlauf über ein Monatskontingent, das jeder Nutzer mitbringt.
Die interessante Zahl ist keiner der beiden Preise. Es ist das Verhältnis zwischen den beiden Kontingenten – und was dieses Verhältnis darüber sagt, welche Fragen sich in einem Eingabefeld lohnen und welche als Bericht gebaut gehören.
Das Kontingent gilt je Person, nicht je Strecke
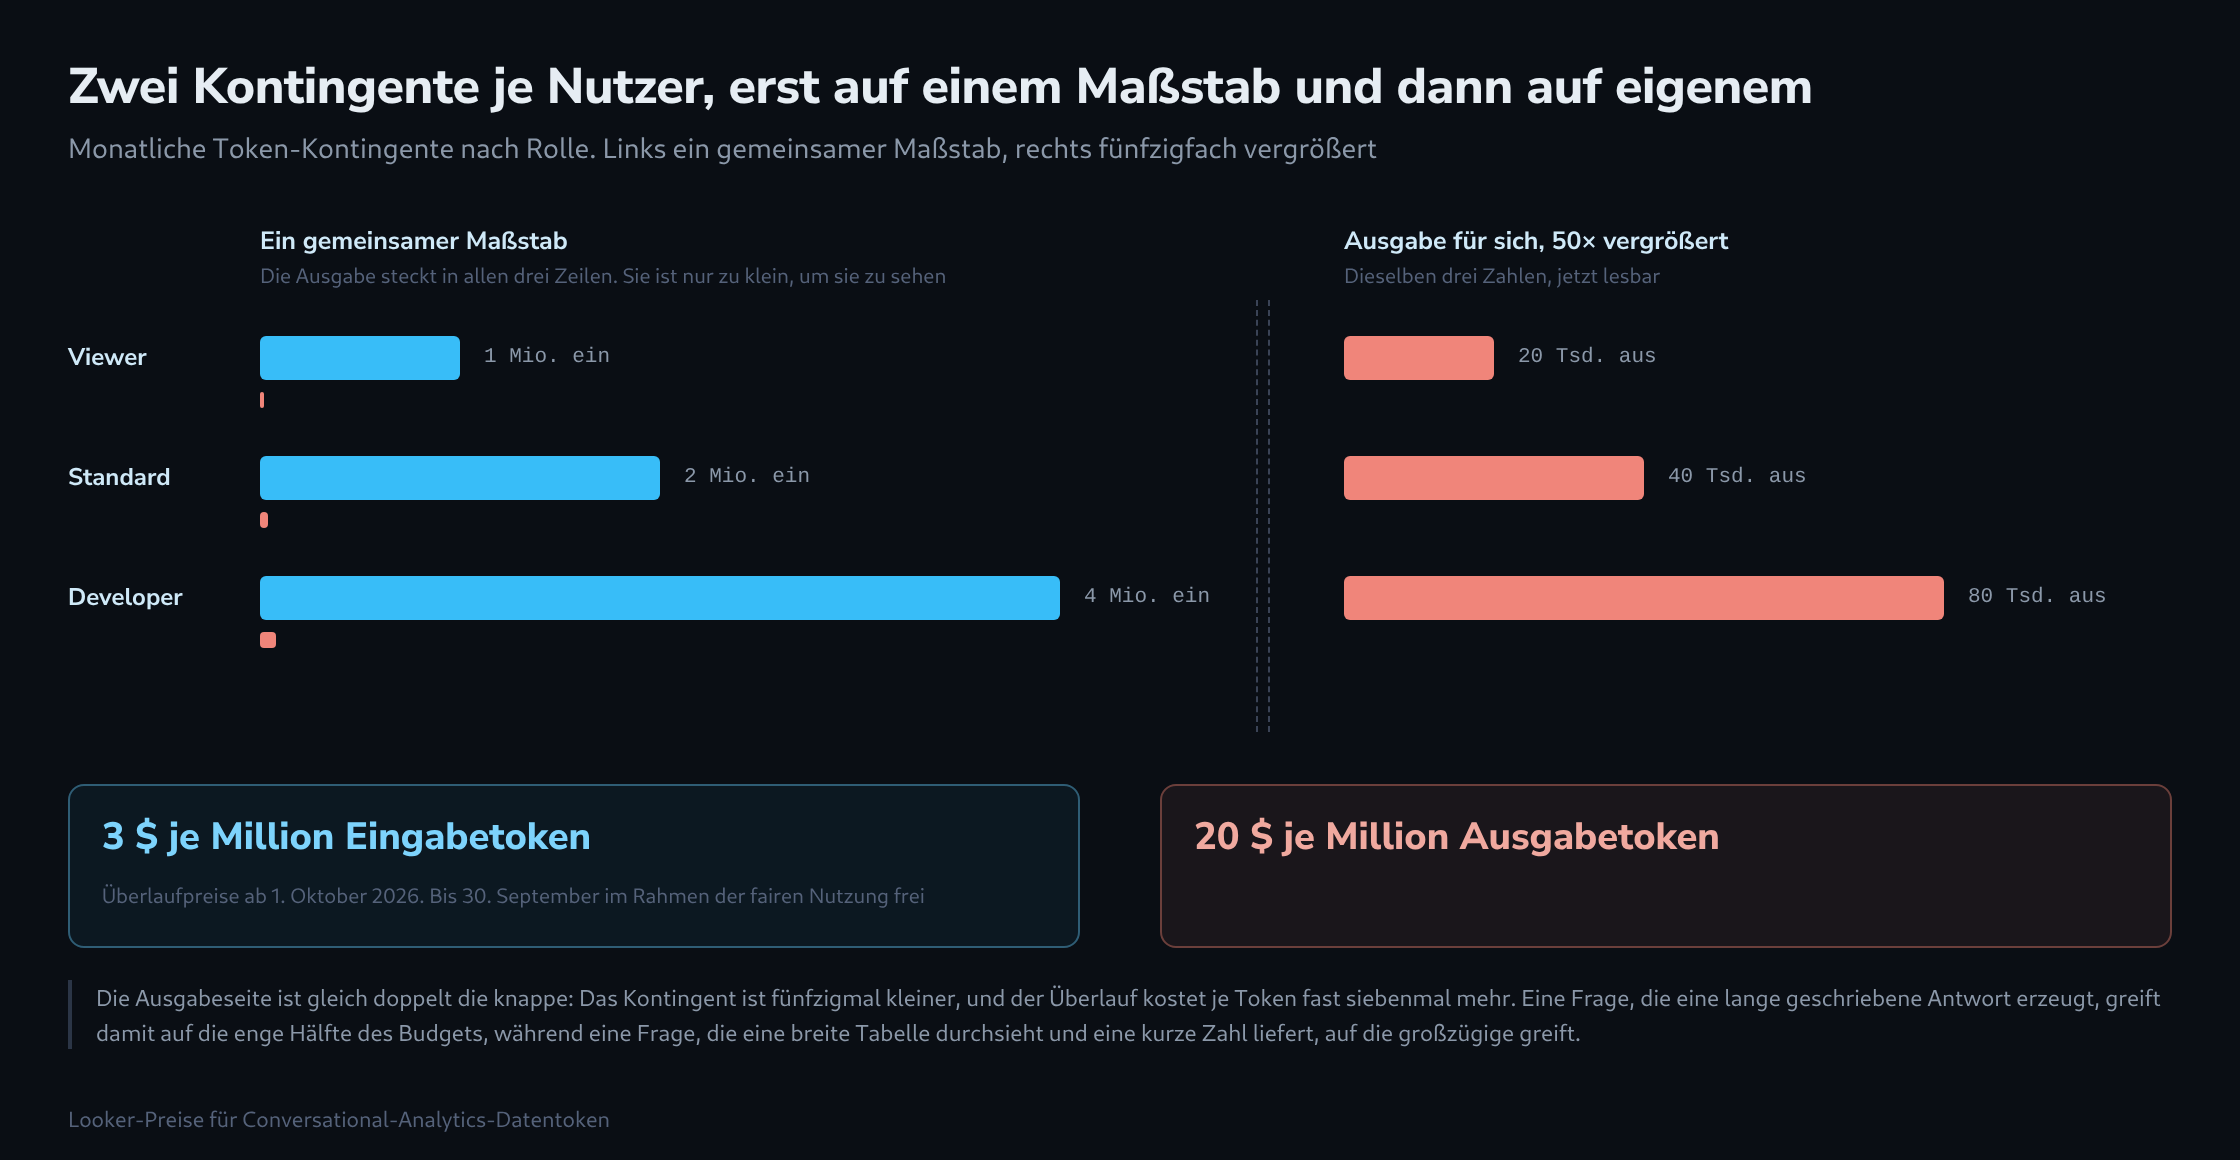
Das ist der bauliche Unterschied zu jeder anderen Tokenrechnung. Ein Zugangsschlüssel hat Verbrauch; ein Berichtsnutzer hat eine Rolle. Hier hängt das Monatskontingent an der Rolle: eine Million Eingabe- und zwanzigtausend Ausgabetoken für einen Viewer, zwei Millionen und vierzigtausend für Standard, vier Millionen und achtzigtausend für Developer.
Also wächst der Preis der Funktion mit der Zahl der Menschen, die sie nutzen, nicht mit der Menge der berührten Daten. Zwanzig Auswertende, die gelegentlich etwas fragen, sitzen bequem im Freikontingent. Eine einzelne Person, die eine tägliche Textzusammenfassung für zwanzig Berichte automatisiert, sitzt es nicht – und keine Abfrageoptimierung ändert daran etwas, weil der Aufwand im Schreiben steckt, nicht im Lesen.
Warum die Ausgabe die enge Hälfte ist
Kontingentverhaeltnis  1.000.000 ein : 20.000 aus     50 : 1
Preisverhaeltnis       3 $/Mio. ein  : 20 $/Mio. aus  1 : 6,7

  zusammen: ein Ausgabetoken ist fuenfzigmal knapper
  und fast siebenmal teurer

billige Frage          sieht eine breite Tabelle durch und
                       liefert eine Zahl. Schwer auf der
                       Eingabe, belanglos auf der Ausgabe

teure Frage            "fasse zusammen, was sich diesen
                       Monat geaendert hat, und erklaere
                       warum" - leicht auf der Eingabe,
                       jedes Wort der Antwort auf der Ausgabe
Der Reflex aus anderen Tokenrechnungen ist die Sorge darum, wie viele Daten hineingehen. Hier zeigt dieser Reflex in die falsche Richtung. Die Eingabe ist die großzügige Seite, sowohl im Kontingent als auch im Preis; die Grenze sitzt auf der Antwort.
Eine grobe Größenordnung hilft. Zwanzigtausend Ausgabetoken sind in der Größenordnung von sechzig bis achtzig gehaltvollen Antworten im Monat für einen Viewer, ein paar hundert Token Fließtext je Antwort angenommen. Für jemanden, der fragt, wenn etwas merkwürdig aussieht, reicht das gut. Als Oberfläche einer täglichen Routine reicht es nicht.
Was das an der Nutzung ändert
Die Trennung, die sich aus dem Preis ergibt, liegt nahe an der, die ohnehin sinnvoll war. Gelegentliche Fragen, gestellt weil ein Diagramm falsch aussah, sind genau das, wofür eine dialogische Oberfläche da ist, und sie passen ins Kontingent, ohne dass jemand darüber nachdenken muss.
Wiederkehrende Ausgabe gehört in einen Bericht. Ein Text, der jeden Montagmorgen für dieselben sechs Berichte erzeugt wird, ist eine Vorlage mit Zahlen darin – und eine Vorlage braucht kein Sprachmodell zum Ausfüllen, sobald ihre Form feststeht. Zwanzig Dollar je Million dafür zu zahlen, denselben Satzbau zweiundfünfzigmal im Jahr neu zu erzeugen, ist der Fehlschlag, der vorher benannt gehört.
Der mittlere Fall ist wirklich eine Ermessensfrage: eine gelegentliche geschriebene Zusammenfassung für jemanden, der Looker nie selbst öffnet. Das hat echten Wert, es kostet echte Ausgabetoken, und ob es sich lohnt, entscheidet die Person und nicht die Preisliste.
Was vor Oktober zu tun ist
Zwei Dinge, beide klein. Erstens herausfinden, wie hoch der Verbrauch heute tatsächlich ist, solange er noch frei ist – denn ab dem 1. Oktober kommt dasselbe Verhalten als Zeile auf einer Rechnung an, und niemand wird sich dann an den Ausgangswert erinnern.
Zweitens nachsehen, ob schon etwas planmäßig läuft. Geplante Erzeugung ist die Stelle, an der aus einer freien Funktion leise eine wiederkehrende Gebühr wird, und der Monat, sie zu finden, ist der vor dem Anlaufen des Zählers, nicht der danach.
Fragen und Antworten
Was kostet eine automatisierte tägliche Zusammenfassung für zwanzig Berichte im Monat?
Wenig genug, um übersehen zu werden, und genau darin liegt die Tücke. Ein Rechenbeispiel mit den Annahmen des Artikels: je Bericht eine Antwort von rund 300 Token Fließtext, zwanzig Berichte, dreißig Tage. Das ergibt 180.000 Ausgabetoken im Monat. Nach Abzug der 20.000 aus dem Kontingent eines Viewers bleiben 160.000 Token Überlauf, bei zwanzig Dollar je Million also 3,20 Dollar im Monat. Die Eingabe ist dabei nicht mitgerechnet; sie fällt erst ins Gewicht, wenn sie die Million des Kontingents übersteigt, und kostet dann drei Dollar je weitere Million.
Der Betrag allein ist also kein Argument. Entscheidend ist die Bauart der Kosten: Der Betrag wächst linear mit jedem weiteren Bericht und jeder weiteren Person, die dieselbe Routine einrichtet, er fällt jeden Monat neu an, und er bezahlt eine Leistung, die eine feste Vorlage ohne Sprachmodell erbringen würde. Hinzu kommt, dass die Routine mit 6.000 Token am Tag das Kontingent nach gut drei Tagen aufgebraucht hat. Für die gelegentlichen Fragen, für die die Oberfläche gedacht ist, bleibt dann nichts mehr frei, und jede davon läuft ebenfalls in den Überlauf.
Lohnt es sich, Nutzer in eine höhere Rolle zu heben, um ihr Kontingent zu vergrößern?
Kaum. Der Schritt von Viewer zu Standard bringt eine Million Eingabe- und 20.000 Ausgabetoken mehr, zum Überlaufpreis zusammen 3,40 Dollar im Monat; der Schritt von Standard zu Developer ist 6,80 Dollar wert. Mehr als diese Beträge spart ein Rollenwechsel an Tokenkosten nicht, und das auch nur, wenn das zusätzliche Kontingent vollständig genutzt wird. Die Rolle regelt zugleich, was eine Person darf; wer sie nach dem Kontingent vergibt statt nach der Aufgabe, erweitert Rechte, um ein paar Dollar zu sparen.
Wie lässt sich eine Frage stellen, die wenig Ausgabetoken verbraucht?
Indem sie eine Zahl, eine kurze Liste oder eine Tabelle verlangt statt einer Erklärung. „Wie hoch war der Umsatz je Region im August?“ belastet vor allem die Eingabe, „Warum war der August schwach?“ vor allem die Ausgabe; die Warum-Frage lohnt sich erst, wenn die Zahlen gezeigt haben, wo die Suche ansetzen sollte.
Quellen
Passend dazu