English
 Deutsch
 Polski
Aufbau einer RAG-Wissensdatenbank mit Google Cloud Vertex AI & BigQuery

Inhalt
Standardmäßige Large Language Models (LLMs) leiden häufig unter Halluzinationen und veralteten Wissensgrenzen, wenn Abfragen zu internen Unternehmenshandbüchern, proprietären Datenbanken oder hochspezialisierten technischen Dokumentationen erfolgen. Retrieval-Augmented Generation (RAG) überwindet diese Einschränkungen, indem der Generierungsprozess fest in einem verifizierten, unternehmensspezifischen Wissensspeicher verankert wird. Die Implementierung einer serverlosen RAG-Architektur auf Basis von Google Cloud Vertex AI Embeddings und BigQuery Vector Search ermöglicht eine skalierbare semantische Suche über Millionen von Dokumentenabschnitten ohne den Betrieb separater Vektordatenbank-Cluster.
1. Architektur-Grundlagen: Serverless RAG auf Google Cloud
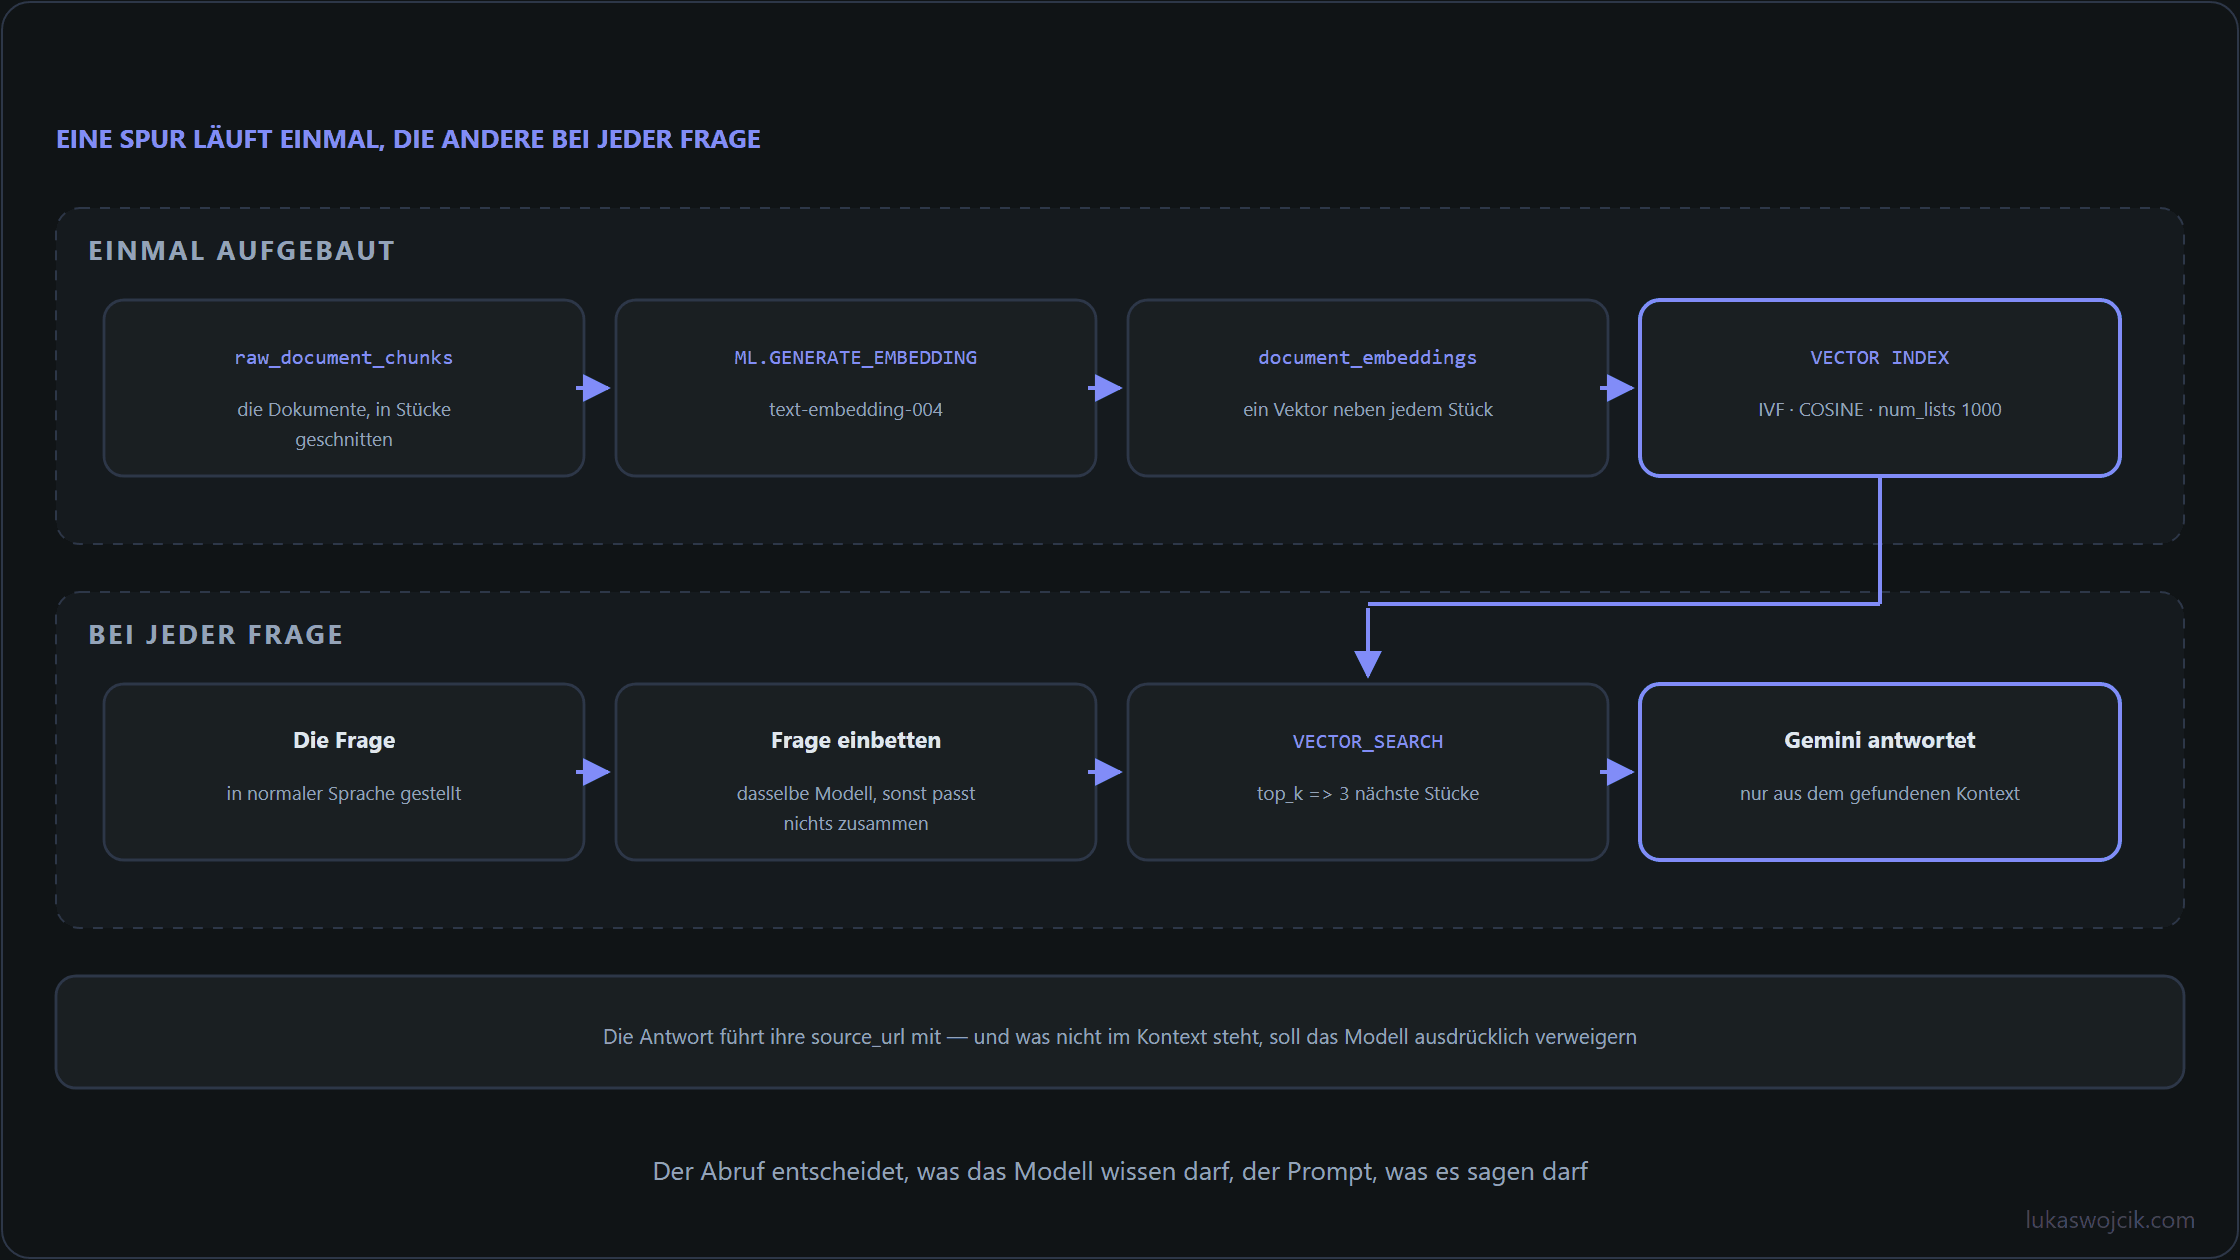
Eine professionelle RAG-Pipeline auf der Google Cloud entkoppelt Dokumentenaufbereitung, semantische Indexierung und Antwortgenerierung über drei verwaltete Services:
- Daten-Ingestion & Chunking: Rohe PDF-Handbücher, Intranet-Wikis und strukturierte Datenbanktabellen werden in den Google Cloud Storage (GCS) geladen und in semantische Abschnitte (Chunks) von 500 bis 1000 Token mit 10 % Überlappung zerlegt.
- BigQuery ML Vektorindexierung: Die Abschnitte werden in BigQuery-Tabellen gespeichert, wo Vertex-AI-Embedding-Modelle (z. B.
gemini-embedding-001, das mehrsprachig arbeitet; die älterentext-embedding-004undtext-multilingual-embedding-002schaltet Google am 01.04.2027 ab) hochdimensionale Vektoren direkt via SQL generieren. - Grounding mit Vertex AI Gemini: Bei einer eingehenden Anfrage führt BigQuery Vector Search eine Annäherungssuche (Approximate Nearest Neighbor, ANN) aus, um die relevantesten Textabschnitte abzurufen, welche anschließend als faktischer Kontext in den Prompt eines Gemini-Modells integriert werden.
2. Schritt-für-Schritt-Generierung von Embeddings in BigQuery ML
Um Vektor-Embeddings ohne den Export von Daten in externe Python-Skripte zu erstellen, wird eine direkte Verbindung zum Vertex AI Modell in BigQuery eingerichtet. Das folgende SQL-Skript verbindet das Embedding-Modell und transformiert eine Tabelle mit Textabschnitten in ein vektorindexiertes Wissensarchiv:
-- 1. Verbindung zum Vertex AI Embedding-Endpunkt anlegen
CREATE OR REPLACE MODEL `enterprise_kb.vertex_embed_model`
REMOTE WITH CONNECTION `us-central1.vertex_ai_connection`
OPTIONS (
    ENDPOINT = 'gemini-embedding-001'
);

-- 2. Vektor-Embeddings für unstrukturierte Dokumentenabschnitte erzeugen
CREATE OR REPLACE TABLE `enterprise_kb.document_embeddings` AS
SELECT
    doc_id,
    chunk_id,
    content_text,
    source_url,
    ml_generate_embedding_result AS content_embedding
FROM
    ML.GENERATE_EMBEDDING(
        MODEL `enterprise_kb.vertex_embed_model`,
        (SELECT *, content_text AS content FROM `enterprise_kb.raw_document_chunks`),
        STRUCT(TRUE AS flatten_json_output)
    )
WHERE
    content_text IS NOT NULL;
3. Schritt-für-Schritt-Vektorindexierung & semantische Suche
Um extrem schnelle Antwortzeiten bei großen Datenmengen zu garantieren, muss vor der Ausführung semantischer Ähnlichkeitssuchen ein IVF-Vektorindex (Inverted File) auf die Embedding-Spalte angewendet werden:
-- 1. IVF-Vektorindex (Approximate Nearest Neighbor) erzeugen
CREATE VECTOR INDEX `kb_semantic_index`
ON `enterprise_kb.document_embeddings`(content_embedding)
OPTIONS (
    index_type = 'IVF',
    distance_type = 'COSINE',
    ivf_options = '{"num_lists": 1000}'
);

-- 2. Vektorähnlichkeitssuche zur Extraktion der Top-3-Abschnitte ausführen
SELECT
    base.doc_id,
    base.chunk_id,
    base.content_text,
    base.source_url,
    distance AS cosine_distance
FROM
    VECTOR_SEARCH(
        TABLE `enterprise_kb.document_embeddings`,
        'content_embedding',
        (
            SELECT ml_generate_embedding_result AS content_embedding
            FROM ML.GENERATE_EMBEDDING(
                MODEL `enterprise_kb.vertex_embed_model`,
                (SELECT 'Wie lauten die Eskalationsregeln bei kritischen Serverausfällen?' AS content),
                STRUCT(TRUE AS flatten_json_output)
            )
        ),
        top_k => 3,
        distance_type => 'COSINE'
    )
ORDER BY distance ASC;
4. Schritt-für-Schritt-RAG-Grounding-Pipeline mit Gemini
Sobald die relevanten Kontextabschnitte mittels BigQuery Vector Search extrahiert wurden, wird ein strukturierter Grounding-Prompt zusammengestellt und per Python an die Vertex AI Gemini API übermittelt:
from google.cloud import bigquery
from google import genai

# Google-Cloud-Clients initialisieren
bq_client = bigquery.Client(project='enterprise-ai-project')
genai_client = genai.Client(vertexai=True, project='enterprise-ai-project', location='us')

def answer_query_with_rag(user_question):
    """Führt eine BigQuery-Vektorsuche aus und sichert Gemini-Antworten faktisch ab."""

    # BigQuery Vector Search für die Top-3 semantischen Chunks abfragen
    search_query = f"""
        SELECT base.content_text, base.source_url
        FROM VECTOR_SEARCH(
            TABLE `enterprise_kb.document_embeddings`,
            'content_embedding',
            (
                SELECT ml_generate_embedding_result AS content_embedding
                FROM ML.GENERATE_EMBEDDING(
                    MODEL `enterprise_kb.vertex_embed_model`,
                    (SELECT @question AS content),
                    STRUCT(TRUE AS flatten_json_output)
                )
            ),
            top_k => 3,
            distance_type => 'COSINE'
        )
    """

    job_config = bigquery.QueryJobConfig(
        query_parameters=[bigquery.ScalarQueryParameter("question", "STRING", user_question)]
    )
    results = bq_client.query(search_query, job_config=job_config).result()

    # Extrahierte Abschnitte als Kontextblock formatieren
    context_block = "\n---\n".join([f"Quelle ({row.source_url}): {row.content_text}" for row in results])

    # Strikt massgeblichen RAG-Prompt erzeugen
    rag_prompt = f"""Sie sind ein technischer Unternehmensassistent.
Beantworten Sie die Frage AUSSCHLIESSLICH basierend auf den Fakten im untenstehenden Kontext.
Falls die Antwort nicht im Kontext enthalten ist, weisen Sie ausdrücklich darauf hin, dass die Information nicht vorliegt.

Kontext:
{context_block}

Frage:
{user_question}
"""

    response = genai_client.models.generate_content(model="gemini-3.5-flash", contents=rag_prompt)
    return response.text

if __name__ == '__main__':
    output = answer_query_with_rag("Wie lauten die Eskalationsregeln bei kritischen Serverausfällen?")
    print(output)
5. Zusammenfassung & Mehrwert
Was sich damit erreichen lässt: Die erfolgreiche Bereitstellung einer serverlosen, hochskalierbaren RAG-Wissensdatenbank auf Basis von Google Cloud Vertex AI Embeddings, BigQuery ML Vektorindexierung und fundierter Gemini-Generierung.
Resultierender Mehrwert: Fachspezifische Fragen zu internen Unternehmensdokumenten, Handbüchern und Datenbanken werden mit höchster Präzision und nachvollziehbaren Quellenangaben beantwortet. KI-Halluzinationen werden deutlich reduziert, da Antworten strikt an reale Organisationsdaten gebunden sind. Die Ausführung von Vektor-Embeddings und semantischer Suche direkt in BigQuery macht zudem teure, separate Vektordatenbanken überflüssig, während maximale Datensicherheit und IAM-Governance im Enterprise-Standard gewahrt bleiben.
Fragen und Antworten
Welche Berechtigungen und Standorte muss der Aufbau zusammenbringen?
Drei Stellen, an denen der Aufbau sonst scheitert oder Daten an einen unerwarteten Ort schickt:
- Die Verbindung
vertex_ai_connectionhat ein eigenes Dienstkonto. Erst wenn dieses Konto im Projekt die Rolle Vertex AI User hat, darf BigQuery das Embedding-Modell aufrufen; ohne sie brichtML.GENERATE_EMBEDDINGmit einem Berechtigungsfehler ab. - Das Python-Skript läuft mit eigenen Zugangsdaten und braucht damit das Recht, BigQuery-Jobs zu starten und die Tabelle
document_embeddingszu lesen, für den Aufruf von Gemini außerdem Zugriff auf Vertex AI. - Das Dataset
enterprise_kbund die Verbindung müssen am selben Standort liegen. Der Artikel verwendetus-central1, eine Region in den USA, und für Gemini den Standortus, ebenfalls in den USA. Sollen die Dokumente in der EU verarbeitet werden, gehören Dataset und Verbindung in eine europäische Region und ingenai.Client()ein europäischer Standort wieeu, sofern die verwendeten Modelle dort angeboten werden.
Die IAM-Governance, die der Artikel nennt, beruht auf genau diesen Rollen und Standorten.
Muss die Frage mit demselben Modell eingebettet werden wie die Dokumente?
Ja. Vektoren verschiedener Embedding-Modelle liegen in verschiedenen Räumen, oft sogar mit unterschiedlich vielen Dimensionen, und ihr Kosinusabstand sagt nichts aus; der Code im Artikel verwendet folgerichtig für beides enterprise_kb.vertex_embed_model. Daraus folgt eine Grenze im Betrieb: Wechselt das Modell, etwa weil Google eine Modellversion abkündigt, müssen alle Abschnitte neu eingebettet und der Vektorindex neu angelegt werden.
Passend dazu