English
 Deutsch
 Polski
Chunk-Größe und Überlappung in einer RAG-Wissensbasis: Auswirkungen auf Embedding-Zahl, Token-Budget und Neuindexierung

Inhalt
Eine Wissensbasis für einen KI-Assistenten beginnt damit, lange Dokumente in kurze Abschnitte zu zerlegen. Zwei Zahlen entscheiden darüber, wie das geschieht: wie lang ein Abschnitt sein soll, und wie weit zwei aufeinanderfolgende Abschnitte einander überlappen. Beide sind in einer Minute eingetragen, gelten für den gesamten Bestand und lassen sich nachträglich nur ändern, indem alles noch einmal von vorn verarbeitet wird.
Und beide werden zweimal bezahlt: einmal beim Aufbau der Wissensbasis, und danach bei jeder einzelnen Frage aufs Neue. Deshalb lohnt es sich, sie auszurechnen statt sie zu schätzen.
Gemessen wird in Token – grob gesagt in Wortteilen; hundert Token sind etwa siebzig Wörter deutscher Prosa. Jeder fertige Abschnitt wird in eine lange Zahlenfolge übersetzt, die seine Bedeutung festhält. Diese Zahlenfolge heißt Einbettung, und gesucht wird später nicht im Text, sondern in ihr.
Warum die Überlappung Geld kostet
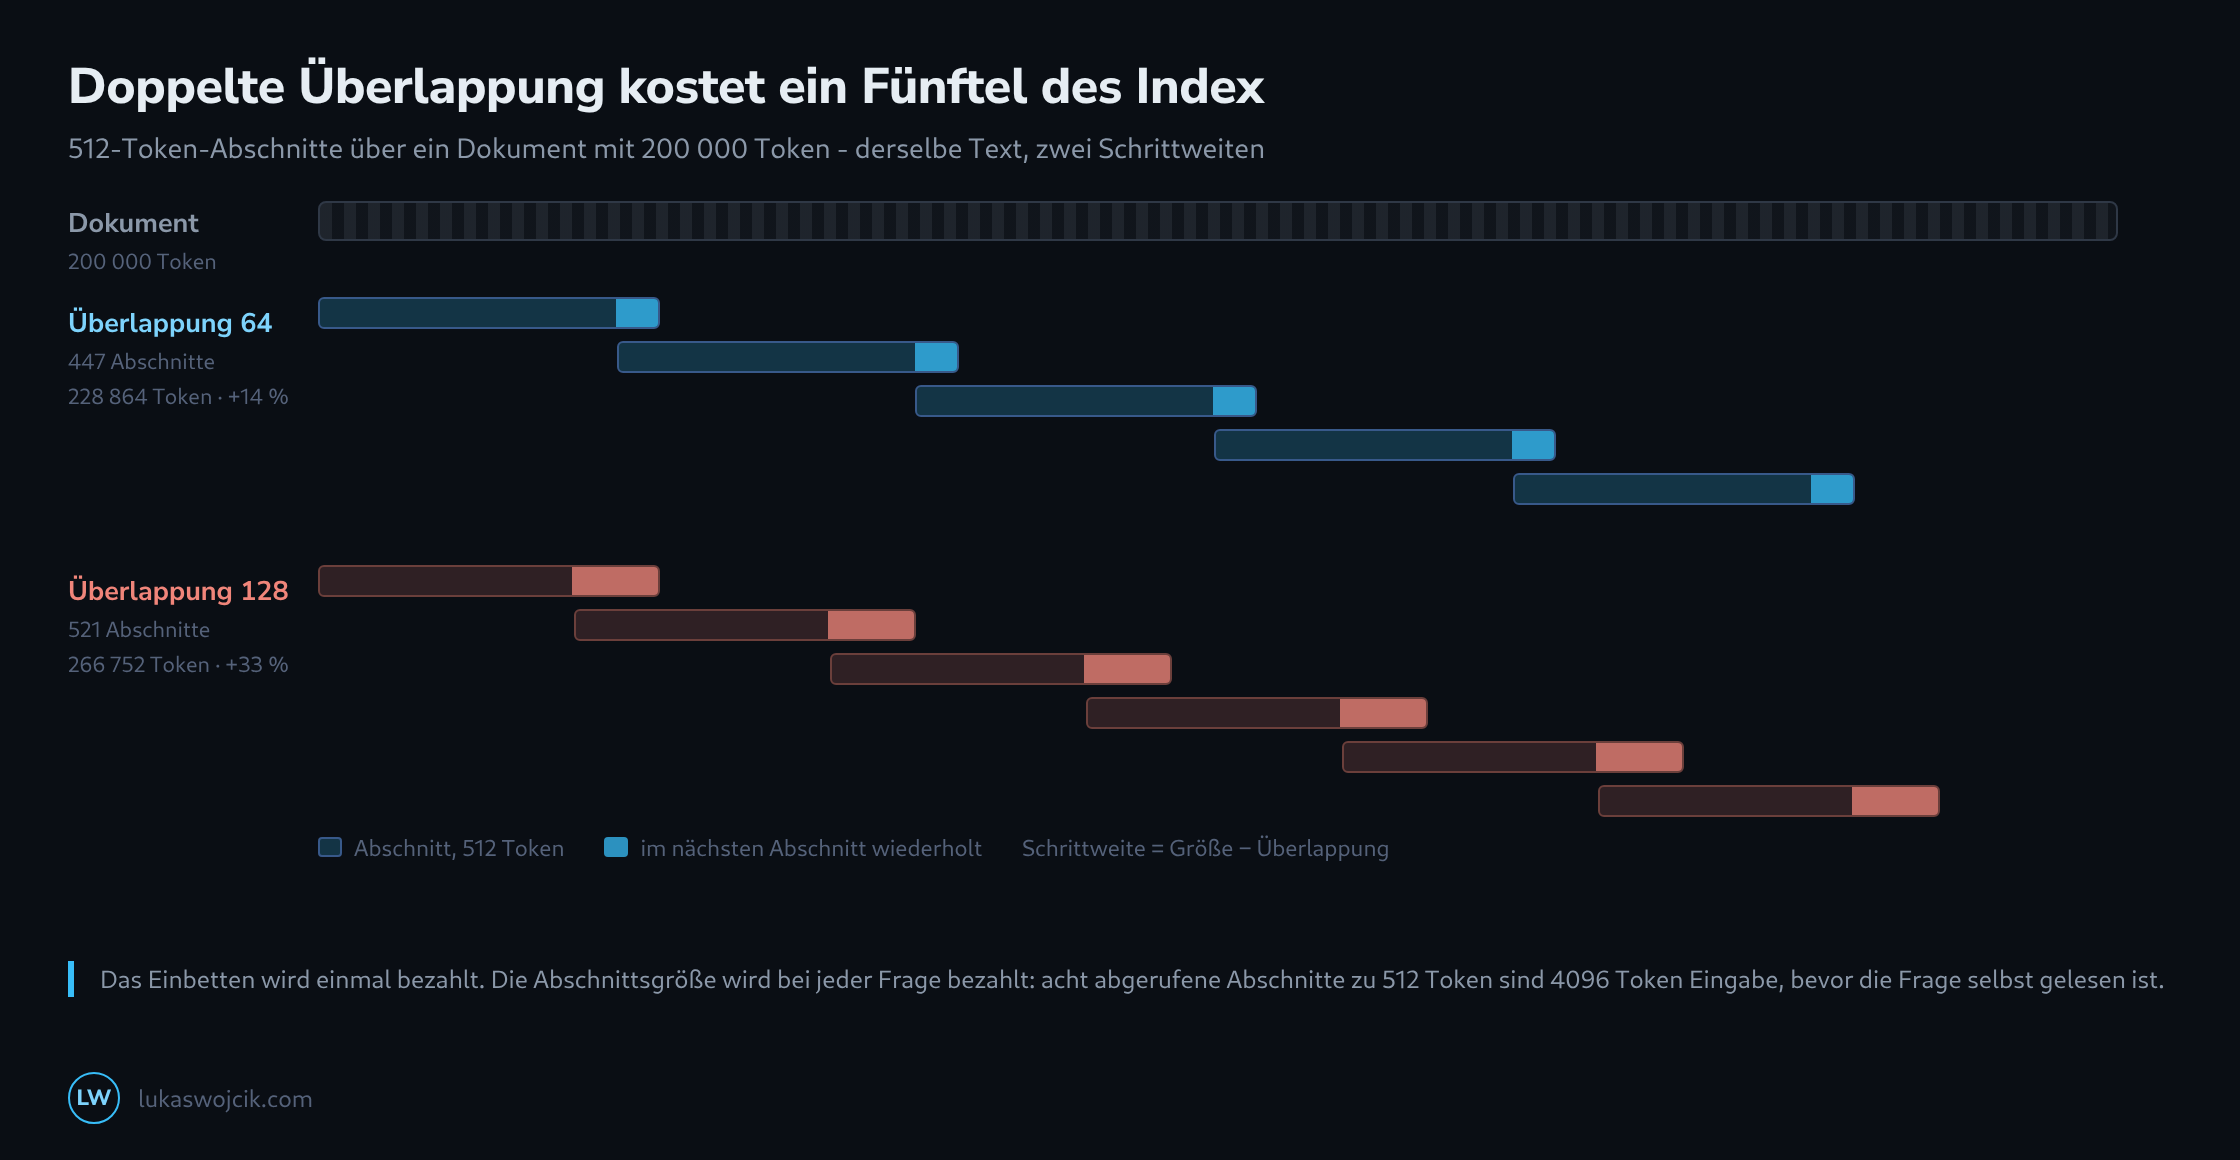
Die Abschnitte rücken nicht um ihre volle Länge vor, sondern nur um den Teil, der nicht überlappt. Bei einer Abschnittsgröße von 512 Token und einer Überlappung von 64 rückt jeder Abschnitt also um 448 vor. Für dasselbe Dokument braucht es damit mehr Abschnitte – und weil jeder Abschnitt in voller Länge abgelegt wird, landet der überlappende Teil zweimal im Speicher.
Die Tabelle zeigt, was das für ein Dokument von 200.000 Token bedeutet, bei einer Abschnittsgröße von 512.
| Überlappung | Abschnitt rückt vor um | Zahl der Abschnitte | Abgelegt insgesamt | Aufschlag |
|---|---|---|---|---|
| 64 Token (12 %) | 448 | 447 | 228.864 | +14 % |
| 128 Token (25 %) | 384 | 521 | 266.752 | +33 % |
| 256 Token (50 %) | 256 | 781 | 399.872 | +100 % |
Die letzte Zeile lohnt sich zu merken: Eine Überlappung von der halben Abschnittsgröße legt jedes Token zweimal ab. Der Aufschlag wächst nicht gleichmäßig mit der Überlappung, sondern schießt hoch, sobald der Vorschub schmal wird. Deshalb liegt der brauchbare Bereich zwischen zehn und zwanzig Prozent, und deshalb braucht alles oberhalb eines Drittels einen Grund.
Wofür die Überlappung überhaupt da ist
Ein starrer Schnitt trennt dort, wo der Zähler abläuft, und das ist regelmäßig mitten in dem Satz, in dem die Antwort steht. Die Überlappung sorgt dafür, dass dieser Satz in mindestens einem Abschnitt vollständig vorkommt – und das ist ihre gesamte Aufgabe.
Die Überlappung muss also nur so groß sein wie die Stelle, die nicht zerrissen werden darf. Bei Fließtext sind zwei bis drei Sätze großzügig, und zwei bis drei Sätze sind etwa sechzig bis hundert Token. Größere Werte werden meist aus Vorsicht gewählt und im Speicher bezahlt, ohne etwas einzubringen: Ein Satz, der ohnehin vollständig in einen Abschnitt passt, passt nicht vollständiger hinein, weil er auch im nächsten steht.
An der Struktur zu schneiden schlägt das Schneiden nach Zahl
Die bessere Antwort auf dasselbe Problem ist, gar nicht erst mitten im Satz zu trennen. An Überschriften zu schneiden, dann an Absätzen und erst dann auf eine Tokenzahl zurückzufallen, wenn ein Absatz die Größe übersteigt, nimmt der Überlappung den größten Teil ihres Grundes – und es erzeugt Abschnitte, deren Inhalt zusammengehört, was die Einbettung ja abbilden soll.
Die Ergänzung, die fast nichts kostet, ist der Überschriftenpfad je Abschnitt, dem Text vorangestellt. Ein Abschnitt, der mit Handbuch > Abrechnung > Kündigung beginnt, wird besser gefunden und liest sich in der Vorgabe besser, weil er den Zusammenhang mitbringt, den der Schnitt genommen hat.
Zwei Größen, zwei verschiedene Fehler
| Abschnittsgröße | Was sie gut kann | Wie sie scheitert |
|---|---|---|
| 128 – 256 | genauer Abruf, der Treffer ist genau die Stelle | die Stelle kommt ohne den Satz an, der sie erklärt |
| 400 – 800 | ein Absatz samt Zusammenhang, ein Thema je Einbettung | kaum; das ist der Arbeitsbereich |
| 1024 – 2048 | ganze Kapitel, nichts wird je abgeschnitten | die Einbettung mittelt mehrere Themen und passt auf nichts scharf |
Der Fehler großer Abschnitte ist der von außen schwer sichtbare. Eine Einbettung ist ein einziger Punkt für den ganzen Text; ein Abschnitt über drei Gegenstände liegt also irgendwo zwischen allen dreien und keinem nahe. Der Abruf meldet das nicht, er liefert einfach etwas anderes, und die Antwort entsteht aus einer Stelle, die nicht ganz die richtige war.
Die Kosten, die wiederkehren
Einen Bestand einzubetten ist billig und geschieht einmal. Die Abschnittsgröße ist aber zugleich die Einheit, in der der abgerufene Text gemessen wird, den der Assistent bei jeder Frage vorgelegt bekommt – und der wird jedes Mal bezahlt. Acht Abschnitte zu 512 Token sind 4096 Token, die das Modell liest, bevor es die Frage überhaupt gesehen hat.
Auf diese Zahl ist auszulegen, denn sie multipliziert sich mit der Zahl der Fragen und nicht mit der Größe des Bestands. Die Abschnittsgröße zu halbieren und dafür doppelt so viele Abschnitte abzurufen, lässt die Rechnung gleich und erhöht die Genauigkeit; sie zu halbieren, ohne die Anzahl anzufassen, halbiert die Rechnung und riskiert, mit zu wenig Zusammenhang anzukommen. Beides sind Entscheidungen, und beide stehen in derselben Zeile.
Die Einstellung zu ändern heißt neu aufzubauen
Die Abschnittsgrenzen stecken in den Einbettungen. Eine andere Größe erzeugt andere Texte, andere Einbettungen und andere Kennungen, eine teilweise Umstellung gibt es also nicht – der Bestand wird neu eingebettet, und anderswo gespeicherte Kennungen zeigen auf Abschnitte, die es nicht mehr gibt.
Das spricht für eine Gewohnheit von Anfang an: Rohdokumente, Schnitt und Einbettung als drei getrennte Schritte zu führen und das Zwischenergebnis auf die Platte zu schreiben. Neu einzubetten ist dann ein erneuter Lauf des letzten Schritts auf einem bereits aufbereiteten Bestand statt eines Nachmittags, an dem rekonstruiert wird, wie der Text überhaupt hineingekommen ist.
Fragen und Antworten
Gilt der Aufschlag aus der Tabelle auch für andere Abschnittsgrößen?
Ja, denn er hängt nur vom Verhältnis zwischen Überlappung und Abschnittsgröße ab. Die abgelegte Menge ist ungefähr die Dokumentlänge mal Abschnittsgröße geteilt durch Vorschub; bei 512 Token und 64 Token Überlappung ergibt das den Faktor 512 / 448 ≈ 1,14. Ein Abschnitt von 1024 Token mit 128 Token Überlappung kommt deshalb auf denselben Aufschlag von 14 Prozent, einer von 256 Token mit 64 Token Überlappung schon auf 33 Prozent.
Kostet die Überlappung auch bei jeder Frage, nicht nur im Speicher?
Ja, sobald benachbarte Abschnitte gemeinsam abgerufen werden, und das kommt häufiger vor, als es klingt. Zwei Nachbarn teilen sich den überlappenden Text, ihre Einbettungen liegen deshalb nahe beieinander, und eine Frage, die zu dem einen passt, passt oft auch zum anderen. Landen beide unter den abgerufenen Abschnitten, steht der gemeinsame Teil zweimal in der Vorgabe und wird zweimal bezahlt.
Schwerer wiegt der verlorene Platz. Bei acht abgerufenen Abschnitten belegt ein Nachbarpaar zwei Plätze mit zum Teil demselben Inhalt, und der Abschnitt, der als neunter gekommen wäre, fällt heraus. Je größer die Überlappung, desto ähnlicher die Nachbarn und desto häufiger der Effekt; bei der halben Abschnittsgröße teilen zwei Nachbarn die Hälfte ihres Textes.
Zwei Handgriffe halten das klein. Benachbarte Treffer aus demselben Dokument lassen sich vor dem Einsetzen in die Vorgabe zu einer Passage zusammenführen, wobei der doppelte Teil wegfällt. Und die Auswahl lässt sich so einrichten, dass je Nachbarpaar nur der besser bewertete Abschnitt zählt und der frei gewordene Platz an den nächsten Kandidaten geht.
Welche Grenze setzt das Einbettungsmodell selbst der Abschnittsgröße?
Eine harte: Jedes Einbettungsmodell nimmt nur eine begrenzte Zahl Token entgegen, und die letzte Zeile der Größentabelle reicht bei manchen gängigen Modellen an diese Grenze heran. Kritisch ist, was bei einer Überschreitung geschieht. Vertex AI, die Quelle des Artikels, kürzt zu lange Eingaben in der Voreinstellung stillschweigend, statt einen Fehler zu melden. Der Rest des Abschnitts wird dann weiter gespeichert und ausgeliefert, fließt aber nicht in die Einbettung ein und ist über diesen Abschnitt nicht auffindbar.
Zwei Zuschläge werden dabei leicht übersehen. Der vorangestellte Überschriftenpfad zählt mit, und ein Abschnitt, den der Zerleger mit seinem eigenen Tokenizer auf 512 gezählt hat, kann im Tokenizer des Einbettungsmodells länger sein. Wer nahe an der Grenze arbeitet, lässt deshalb Luft oder schaltet die Kürzung ab, damit ein zu langer Abschnitt als Fehler auffällt.
Muss nach der Änderung eines einzelnen Dokuments der ganze Bestand neu eingebettet werden?
Nein, das verlangt nur eine geänderte Einstellung. Bei einer Änderung am Inhalt genügt es, die Abschnitte dieses einen Dokuments zu löschen, das Dokument neu zu zerlegen und die neuen Abschnitte einzubetten. Voraussetzung ist, dass jede Kennung das Dokument enthält, aus dem der Abschnitt stammt; sonst lässt sich nicht feststellen, welche Einträge wegfallen müssen.
Wie viel dabei neu entsteht, hängt von der Art des Schnitts ab. Beim Schnitt nach Tokenzahl verschiebt ein eingefügter Satz nahe am Anfang alle folgenden Grenzen des Dokuments, und jeder Abschnitt dahinter ändert sich. Beim Schnitt an Überschriften und Absätzen bleibt die Änderung in dem Abschnitt, in dem sie steht; die übrigen bleiben Zeichen für Zeichen gleich.
Das lässt sich ausnutzen. Wer zu jedem Abschnitt eine Prüfsumme seines Textes ablegt, erkennt unveränderte Abschnitte und übernimmt deren Einbettung und Kennung, statt sie neu zu erzeugen, sodass anderswo gespeicherte Verweise gültig bleiben. Mit dem Schnitt an der Struktur bedeutet eine Dokumentänderung dann meist nur eine Handvoll neuer Einbettungen.
Quellen
Passend dazu